 AI-Papers
- 行動軌跡を画像空間にレンダリングし、オフライン幾何キャリブレーションで記録映像と整合させることで行動追従性を高めたロボット世界モデル
- 記録済み軌跡を改変する反事実ポストトレーニングと、欠陥アノテーション付きデータで学習した身体化ビデオ報酬モデルによる強化学習を組み合わせた
- 人間評価による干渉欠陥率を48.12%から6.25%へ低減し、AgiBot World Challenge 2026の世界モデル部門で1位を獲得
研究の背景
ロボットの「世界モデル」とは、現在の観測と実行しようとする行動を入力として、その後に起こる映像を予測するモデルです。実機を動かさずに方策(ポリシー)の良し悪しを試せるため、データ収集コストの高いロボット学習において、シミュレータの代わりとして期待されています。
ところが既存のロボットデータセットでそのまま学習すると、2つの問題にぶつかります。1つ目はキャリブレーションの不正確さで、カメラの内部・外部パラメータがずれていると、与えた行動と画面上のアームの動きが対応しなくなり、行動への追従が崩れます。2つ目は失敗事例の少なさです。公開データセットは成功した操作が中心のため、学習したモデルは何を入力しても「うまくいった未来」を描きがちになります。
中国科学院自動化研究所などの研究チームが発表したDreamTrueは、この2点を正面から扱ったマルチビュー・クロス身体の世界モデルです。コードとプロジェクトページが公開されており、再現性の面でも追試しやすい構成になっています。
行動を画像として与える
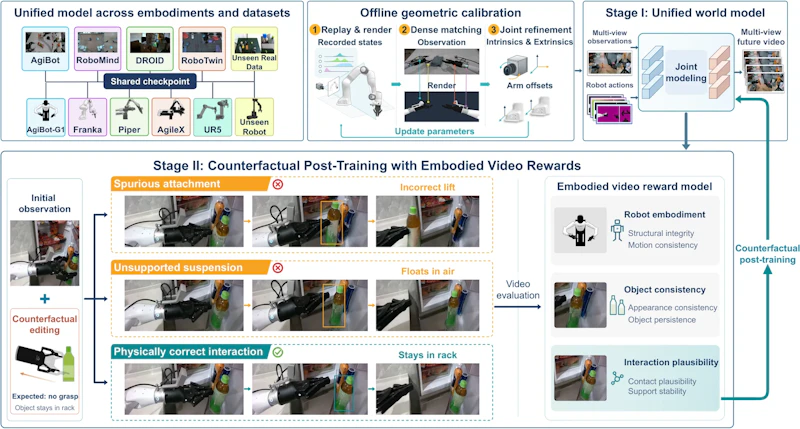
図1に示すように、DreamTrueの学習は2段階に分かれます。第1段階では、ロボットのURDF(関節構造の記述ファイル)から各視点・各時刻のRGB画像、深度、遮蔽を考慮したマスクをレンダリングし、これを行動の条件として動画生成モデルに入力します。数値の関節角をそのまま渡すのではなく、画像空間に「こう動く」という見た目を描いて与えるわけです。グリッパーの開き具合は背景の輝度として符号化し、カメラの向きはPlücker座標の密なマップとして与えます。
生成器はWan2.1-VACE-14Bを初期値とし、VACEブランチ経由で残差を注入する形で約0.7Bのパラメータのみを学習します(LoRAランク128)。複数視点は幅方向にタイル状に並べて同時に予測するため、頭部カメラと手首カメラの整合性が保たれます。
キャリブレーションは専用の撮影を追加せず、既存の記録映像だけから事後的に精緻化します。レンダリングしたアームと観測されたアームの対応点を合わせる制約、背景が静止していることを使う制約、同期した複数視点の光線が同一平面上に乗る制約の3つを組み合わせ、内部パラメータ・外部パラメータ・歪み・アーム取り付けのずれを同時に最適化します。AgiBotデータでは視点間の同期誤差が7.73ピクセルから4.60ピクセルへ縮まり、マスクのIoU(領域の重なり度合い)は平均0.228改善しました。
反事実ポストトレーニング
第2段階が本論文の中心です。記録された軌跡の終端姿勢にSE(3)の摂動(並進と回転のずれ)を加え、固定した初期姿勢から補間して逆運動学で関節指令に変換することで、実際には記録されていない行動を人工的に作ります。これが「反事実」の軌跡であり、物に当たる・つかみ損ねるといった接触状況まで学習範囲に含められます。
問題は、反事実の行動には正解となる未来映像が存在しないことです。そこで研究チームは、予測映像の欠陥を人手でアノテーションしたデータセット(44.9K本の動画、うち30.4K本に欠陥ラベル)を構築し、Qwen3.5-9Bをベースに3つの観点で採点する身体化ビデオ報酬モデルを学習させました。
- L1 身体性の欠陥:アームの複製や消失、構造・材質の崩れ
- L2 物体の欠陥:物体の出現・消失・変形・質感の破綻
- L3 干渉の妥当性:接触と運動の不一致、物理的にありえない相互作用
この報酬を欠陥確率の符号反転として与え、グループ内で正規化したうえでDiffusionNFTにより生成器を最適化します。記録済みの行動に対してはPSNRによる報酬も重み0.5で併用し、正解がある場合の忠実さと、正解がない場合の妥当さを両立させています。報酬モデル自体の精度は3観点平均で正解率86.33%、Macro-F1が74.21でした。
実験結果
AgiBotベンチマークでの比較が下表です。記録済み行動に対する再現精度(PSNR、nDTW)と、反事実行動に対する欠陥率(人間評価)の両方を見ています。nDTWは予測映像から読み取れる軌跡が指令にどれだけ沿っているかを示す指標で、高いほど行動追従が良いことを意味します。
手法 | PSNR | nDTW(記録) | 物体欠陥率 | 干渉欠陥率 | nDTW(反事実) |
|---|---|---|---|---|---|
EnerVerse-AC | 19.17 | 0.8058 | 49.38% | 48.12% | 0.6828 |
Genie Envisioner | 20.72 | 0.8124 | 43.75% | 54.38% | 0.7379 |
GE-Sim 2.0 | 19.91 | 0.8063 | 3.75% | 7.50% | 0.7817 |
DreamTrue(RLなし) | 22.66 | 0.8711 | 31.88% | 48.12% | 0.8735 |
DreamTrue(完全版) | 23.06 | 0.8772 | 3.12% | 6.25% | 0.8831 |
注目したいのは、RLなしの段階では画質と行動追従がすでに他手法を上回っている一方で、干渉欠陥率は48.12%と高いままだという点です。画像空間への行動レンダリングとキャリブレーションが追従性を担い、反事実ポストトレーニングが物理的な破綻を潰すという役割分担がはっきり出ています。完全版は干渉欠陥率6.25%、物体欠陥率3.12%まで下がり、AgiBot World Challenge 2026の世界モデル部門ではEWMScore 0.829で1位となりました(2位は0.8245)。
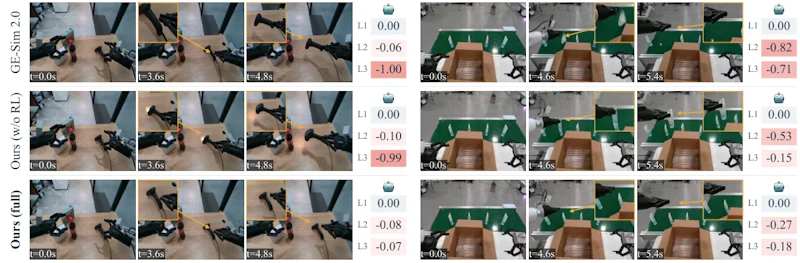
図5の定性比較では、GE-Sim 2.0やRLなしのモデムに見られる「支えのない物体が動く」「物体が消える・二重になる」といった破綻が、完全版では抑えられています。また方策の成否予測という実用的な観点では、4種類のVLA方策・24条件での成功率予測の平均絶対誤差が12.92ポイントから7.08ポイントへ改善し、Spearman順位相関は0.937に達しました。世界モデル上での評価が実機の結果とよく一致することを示す結果で、Long-WAMのような長文脈の世界行動モデルとは別方向から、予測の信頼性を高めるアプローチと言えます。
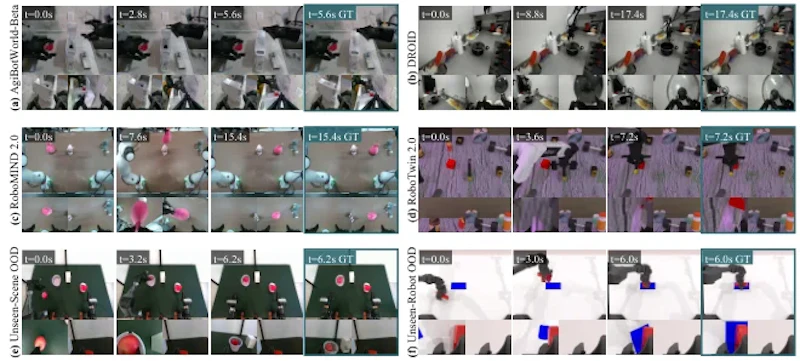
汎化性については図7が示すとおり、1つのチェックポイントでAgiBot、DROID、RoboMIND 2.0、RoboTwin 2.0の4データセットを扱え、未知の実環境や未学習の機体WidowX250にも追加学習なしで適用できました。DROIDではCtrl-WorldのPSNR 22.00に対し22.95、LPIPSは0.162に対し0.073です。
まとめと今後の展望
DreamTrueは、キャリブレーションの精緻化で「行動どおりに動く」精度を上げ、反事実軌跡と欠陥報酬による強化学習で「物理的にありえない未来を描かない」性質を獲得した世界モデルです。成功例に偏ったデータセットという制約をデータ側の工夫で乗り越えた点が、他の身体化AI研究にも応用しやすいでしょう。
一方で課題は著者自身が明示しています。行動表現、生成器、報酬モデルのすべてが画像空間で動作するため、遮蔽が強い場面やカメラ視点が限られる場面では、見た目は妥当でも物理的には誤った予測を生成し、かつ報酬モデルがそれを高く評価してしまう可能性があります。また報酬モデルのL1(身体性)はMacro-F1が69.37と他の観点より低く、まれな欠陥クラスの判定には改善余地が残ります。3次元的な接触情報や力の情報をどう取り込むかが、次の論点になりそうです。
論文情報: "DreamTrue: Action-Faithful Robot World Model with Counterfactual Post-Training"(Junyan Li et al., 2026) arXiv:2610.12468
本記事の図(図1、図5、図7)は解説のため上記論文より引用しています。


