 AI-Papers
- ルールを明かさない反直感的なテキストゲーム20種で、LLMエージェントが対話から学ぶ力だけを分離して測るベンチマーク
- 経験を要約せず生の行動と反応の記録として残す方式が、ルール要約型の自己進化手法より高いスコアと学習速度を示した
- 同じモデルでもハーネスを替えるだけで Claude Opus 5 が 74.5 から 81.8 へ改善し、入力トークンも削減できた
研究の背景
Large Language Model(LLM)を使ったエージェントは、手順が与えられた作業をこなす場面では高い成功率を出します。一方で、見たことのない環境に置かれ、試行錯誤の反応からルールそのものを掘り当てる力は、それとは別の能力です。
既存のエージェント評価では、課題のルールが指示文に書かれているか、事前学習で覚えた常識から推測できるものが大半を占めます。これでは「対話を通じて学んだ成果」と「もともと知っていた知識を当てはめただけの成果」を切り分けられません。
シンガポール国立大学などの研究チームが公開した Learn2Play Bench(arXiv:2610.08215)は、この切り分けのために設計されたテキストゲーム群です。ゲームのルールは新規かつ反直感的で、たとえば「同僚の弁当を盗むと昇進する」といった、事前知識が役に立たないどころか邪魔になる因果関係が仕込まれています。
ベンチマークの設計
ベンチマークは手作業で設計された20個のゲームテンプレートから成り、各テンプレートが乱数シードによって具体的なゲーム実例を生成します。エージェントに渡されるのは目標と実行可能な行動の一覧だけで、隠れたルールはテキストのフィードバックから自力で推定する必要があります。モデルの重みは一切更新されず、学習はあくまで対話の文脈とメモリの上で起こります。
- 20ゲームのうち10個は毎回同じ実例を繰り返す固定型
- 残り10個は配置や登場人物、メニューが変わる再シャッフル型(隠れたルールは同一)
- Catnip、DreamGarden、Mola Tea、RedEye、Roadside Observatory の5つは難問扱い
- フィードバックは再現可能で、採点は自動化されている
再シャッフル型の存在が、このベンチマークの評価軸をひとつ増やしています。表面的な実例を覚えただけのエージェントと、背後のルールを掴んだエージェントを、見た目が変わった場面での伸び方で区別できるためです。
評価プロトコルの工夫
通常ゲームは5エピソード、難問ゲームは10エピソードを1試行とし、メモリを共有しない独立した試行を3回行います。スコアは参照値に対してゲームごとに0から100へ正規化され、難問ゲームに重み3、通常ゲームに重み1を割り当てることで、両グループが合計の半分ずつを占めるよう調整されています。
指標は4つで、試行ごとの最高点の平均(Max)、全エピソードの平均(Mean)、後半と前半の差である学習ゲイン(LG)、エピソードに対する直線的な伸びを表す学習傾き(LS)です。最終スコアだけでなく伸び方を見る設計になっているため、初期値の高さと学習の速さを別々に議論できます。
実験結果
ハーネスを OpenCode に固定した主要モデルの結果は次の通りです。
モデル | Max | Mean | 学習ゲイン | 学習傾き |
|---|---|---|---|---|
Claude Opus 5.5 | 80.1 | 61.0 | +23.0 | +5.22 |
GPT-6 Astra | 76.2 | 56.1 | +23.8 | +5.88 |
Claude Opus 5 | 74.5 | 53.8 | +21.3 | +5.13 |
Qwen 3.8 Max | 72.5 | 51.1 | +25.2 | +6.30 |
Kimi K3 | 68.5 | 50.2 | +17.1 | +4.24 |
Claude Sonnet 5 | 55.9 | 35.6 | +15.7 | +3.72 |
GPT-5 Mini | 34.0 | 22.3 | +9.2 | +1.83 |
最高点では Claude Opus 5.5 が首位ですが、学習傾きが最も大きいのは Qwen 3.8 Max でした。到達点の高さと学び方の速さが一致しないという結果は、単一のスコアでエージェントの適応力を語りにくいことを示しています。
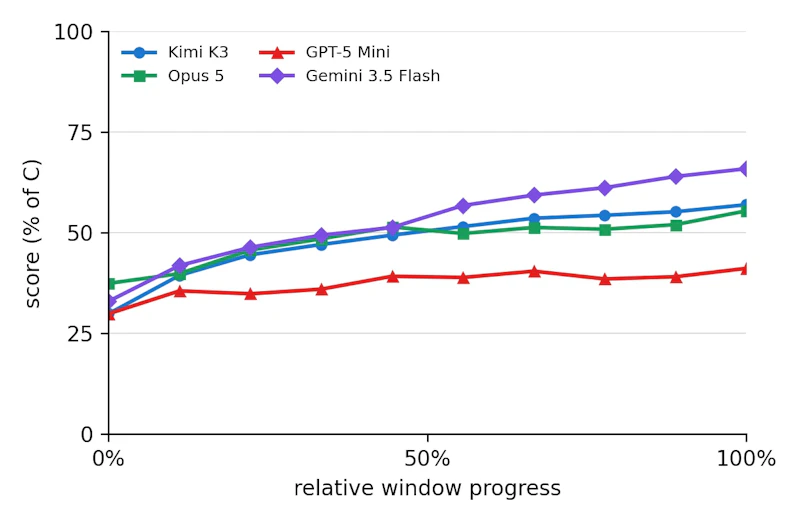
図4は、生の履歴を保持する設定でのエピソード別スコアの推移です。モデルによって立ち上がりの位置と伸び方が異なり、同じ学習機構でもバックボーン次第で曲線の形が変わることが読み取れます。
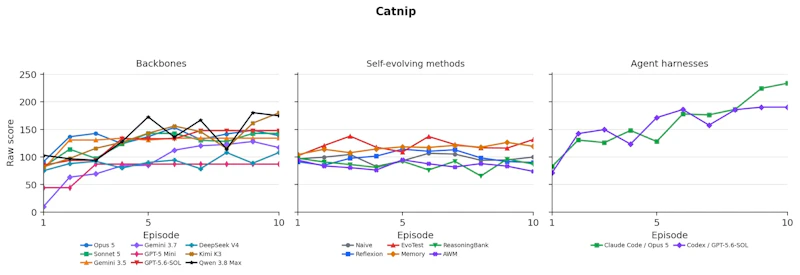
図7は難問ゲームの1つである Catnip の素点の推移です。難問ゲームでは10エピソードを与えても伸びが鈍い設定が残っており、ベンチマークに十分な余地が確保されています。
生ログと要約の差
経験の持ち方の比較では、行動とフィードバックの記録をそのまま保持する方式(Memory)が、経験をルールや戦略に要約する自己進化手法を上回りました。Kimi K3 では Memory が Max 63.3、学習傾き +4.69 に達し、EvoTest(62.4、+1.01)、ReasoningBank(59.9)、AWM(56.1)、メモリなしの Naive(54.7、+0.42)を抑えています。
Claude Opus 5 では EvoTest、Reflexion、Memory、ReasoningBank が Max 60から66の範囲に収まり差が縮みましたが、メモリなしの設定だけは学習ゲインがマイナス5.1と悪化しました。要約は情報を圧縮する過程で、後から意味が判明する細部を落としてしまう可能性があり、この点はAgentGartenとは?コード世界でエージェントが約4ラウンドで学習する仕組みで扱われた自己進化型の設計とも関わる論点です。
ハーネスとコストの関係
バックボーンを固定したままハーネスを入れ替えた比較では、Claude Opus 5 が OpenCode の Max 74.5 から Claude Code で 81.8 へ、GPT-5.6-SOL が 57.0 から Codex で 74.3 へ改善しました。学習傾きも同時に上がっており、実行環境の設計がエージェントの学習効率に直接効いています。
コスト面では、1回の応答で複数の行動をまとめ、重複するフィードバックを削る OpenCode の方式が効きました。Kimi K3 では Memory 方式に比べて入力トークンを56%削減しており、1エピソードあたりの費用も OpenCode + Kimi K3 が 0.313ドル、Gemini 3.7 Flash が 0.052ドルと幅があります。トークン単価が高い Kimi K3 が、同一ハーネス下で Claude Sonnet 5 より高性能かつ低コストに収まった例も報告されています。
人間との比較と限界
人間の参加者と比べると、上位1名の Max は 84.3、学習傾きは +7.33 で、評価されたどのエージェントよりも高い到達点を記録しました。ただし参加者全体では Max 43.6、Mean 31.2 にとどまり、人間側の平均がエージェントを上回るわけではありません。
行動の傾向にも差が出ています。連続する行動列の類似度は人間が0.54、エージェントが0.66で、エージェントは同じ手を繰り返しがちでした。失敗した後に自己最高記録を更新した割合も人間が33%、エージェントが22%で、探索の幅に開きがあります。得意分野も分かれ、GemForge や Grapevine では人間上位が優位、RedEye や Model Auditor ではエージェントが優位でした。
一方で結果の読み方には注意が必要です。設定とゲームの組み合わせごとの試行は3回のみで、標準偏差の推定精度は限られます。人間の上位k名は成績で選抜されているため集計値が高めに出る構造があり、ゲームごとの参加者も21から30名です。テンプレートあたりのシードは1つに固定されており、ルール発見のラベルは補助的な指標として扱われています。
まとめと今後の展望
Learn2Play Bench は、事前知識で解けない環境を意図的に作ることで、エージェントの「経験から学ぶ力」を他の能力から切り離して測る土台を提供します。再現可能なフィードバックと自動採点、実例の変動による転移評価が組み合わさっており、再シャッフル条件では Claude Sonnet 5 の学習傾きが 4.90 から 2.23 へ落ちるなど、表面的な記憶との区別も機能しています。
実装者にとって読み取りやすい示唆は、経験の生ログを残す価値と、ハーネス設計の改善が性能とコストの両方に効くという点です。評価規模や人間側の集計方法に課題は残るものの、エージェントの学習能力を測る軸をひとつ増やした貢献は小さくありません。
論文情報: "Learn2Play Bench: How Well Do LLM Agents Learn from Experience in Unfamiliar Environments?"(Yibo Li et al., 2026) arXiv:2610.08215, CC BY 4.0
本記事の図(図4、図7)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


