 AI-Papers
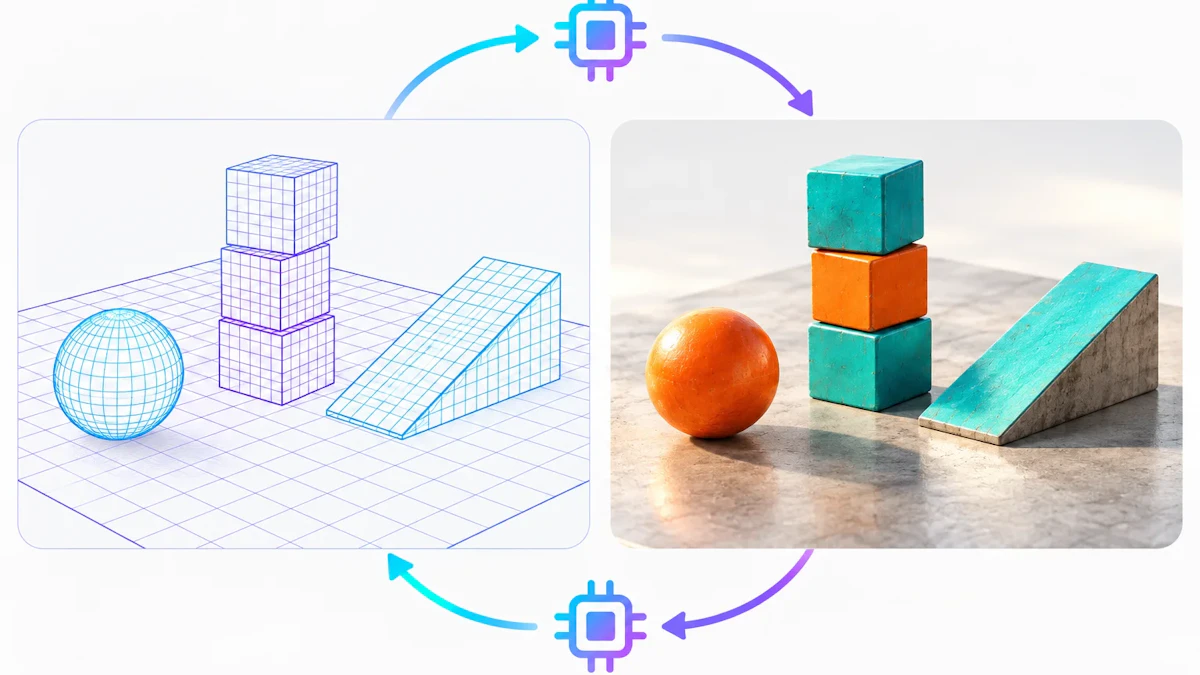
- ゲームエンジンが世界の状態と規則を担い、事前学習済み動画モデルを蒸留した共通レンダラーが見た目を作る「コード世界」を提案
- 履歴の符号化まで勾配を通す Adversarial Forcing により、30秒級のロールアウトでも破綻しにくいリアルタイム描画を実現
- かくれんぼでは強化学習が約2500万エピソードを要した行動がラウンド4で現れ、プレイブック継承による学習が進んだ
研究の背景
エージェントは仮想環境との相互作用を通して学びますが、学べる内容は環境の質に縛られます。良い環境には2つの条件があり、状態や規則や物理が一貫して保たれる忠実さと、見た目が現実に近い写実性です。
この2つは両立が難しい関係にあります。ゲームエンジンは状態管理と規則の実行に優れる一方、見た目をフォトリアルに作り込むには手作業の資産制作が必要になります。逆に動画生成モデルは写実的な映像を出せますが、長い相互作用の間に状態がずれていき、誰がどこに何を置いたかという永続的な事実を保てません。
AgentGarten はこの矛盾を、役割の分離で解こうとします。状態と規則はプログラムとしてエンジンに任せ、見た目だけをニューラルレンダラーが担当する構成です。著者らは清華大学などの研究者14名で、2026年10月8日に arXiv へ投稿されました。
コード世界の構成
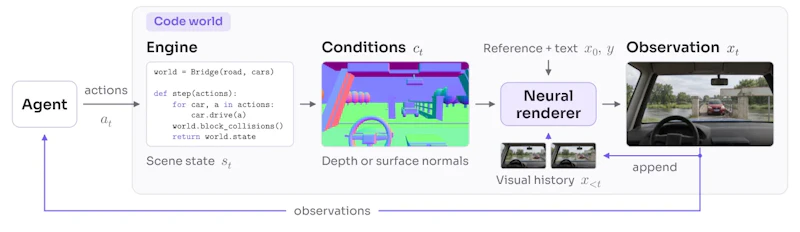
コード世界は、シミュレータ上で動くシーンプログラムと、共有のニューラルレンダラーの組み合わせで定義されます。エージェントが行動を送るとエンジンが状態を更新し、その状態から深度や表面法線といった構造的な条件を書き出します。レンダラーはその幾何条件に、初期画像から取った外観参照、テキスト、キャッシュされた視覚履歴を合わせて観測画像を生成します。
図1がこのループを示しています。重要なのは、状態遷移が生成画像を入力に取らない点です。描画の誤りが状態へ混ざらないため、見た目のほころびが世界の整合性を壊すことはありません。
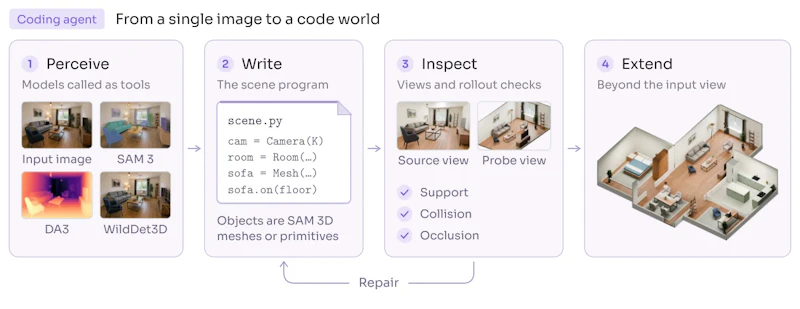
世界そのものはコードなので、コーディングエージェントに書かせることもできます。図2は1枚のリビングの写真から出発し、知覚モデルと生成モデルを道具として呼び出し、シーンプログラムを書いて、描画結果とロールアウト検査を見ながら修復していく過程です。入力画像に写っていない隣室は、エージェントが拡張部分として書き足します。
Adversarial Forcingの中身
レンダラーは事前学習済みの双方向動画モデル Cosmos 3-Nano を出発点に、幾何条件付け、ブロック因果生成への教師強制適応、そして Adversarial Forcing という3段階で作られます。最後の段が本研究の技術的な核で、次の3要素から成ります。
- 分布マッチング: 生徒のロールアウトを凍結した教師と偽スコアモデルで評価する(DMD2 系)
- 厳密リプレイ: 勾配なしのロールアウトと同じ実行構造で、履歴の鍵と値を勾配付きで再計算する
- 敵対損失: 凍結した教師の特徴に学習可能なヘッドを載せ、実データとの相対的な判別を行う
従来の Self Forcing では履歴は勾配を切った状態で読み込まれるため、後のフレームで生じた誤差を「履歴の符号化のしかた」まで遡って直せません。厳密リプレイはそこに勾配を通します。全系列を1回のアテンションでまとめて再計算する素直な実装は相対L2で3.99%のずれを生みましたが、ブロック単位で呼び出しを揃える方式はビット単位で一致したと報告されています。前向き計算は2.95秒から2.79秒へ5.4%短縮され、ピークメモリの増加は0.2%に収まりました。
推論速度は、16フレームのブロック1つが438.8ミリ秒で、H100 1枚あたり約36.5フレーム毎秒に相当します。このうち大半はTransformerのノイズ除去(414.4ミリ秒)で、条件の符号化は10.6ミリ秒ほどです。映像の品質そのものについては、図7で Self Forcing との30秒ロールアウト比較が定性的に示されるのみで、数値指標は本文に出てきません。
エージェントは何ラウンドで学ぶか
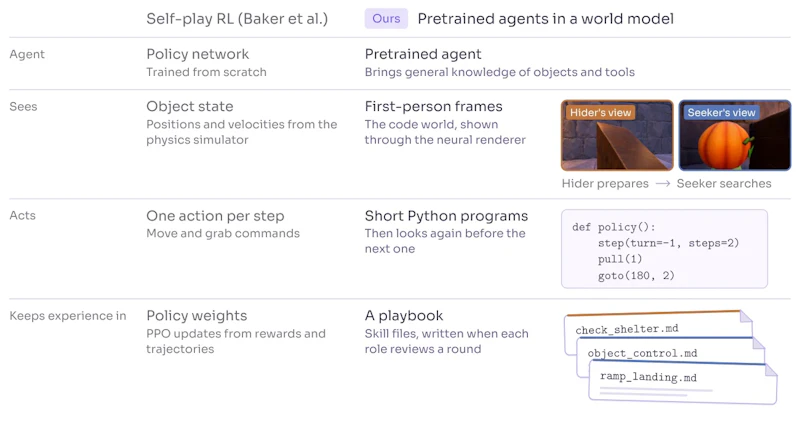
学習の進み方を測る舞台として、隠れる側と探す側が1体ずつ登場する物理ベースのかくれんぼが使われます。図9の上段が示すように、従来の自己対戦強化学習は物体の状態ベクトルと報酬で方策ネットワークを訓練しますが、本研究のエージェントはレンダラーが生成した一人称の映像だけを見て、短いPythonプログラムで行動し、学んだことをプレイブックのスキルファイルに書き残します。
1ラウンドの流れは図10のとおりです。エージェントは目標と行動と制約だけが書かれたタスクファイルを読み、解法は与えられないまま並列に遊び、終了後にプレイブックを書きます。次のラウンドのエージェントは記憶を持たない新しい対話から始まり、タスクファイルと過去すべてのプレイブックだけを引き継ぎます。
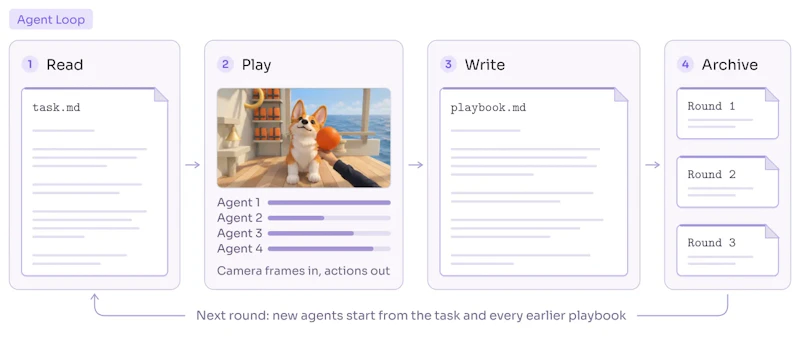
結果として、遮蔽物を組んで身を隠す行動は2019年の強化学習研究で約2500万エピソードを要したのに対し、ラウンド4で現れました。坂を使って壁を越える行動は約1億エピソードに対してラウンド10です。ただし論文自身が、両者は条件が異なり直接のサンプル効率比較ではないと断っている点は押さえておきたいところです。
図8の5つの世界に加え、別の4つの世界でも4ラウンドの試行が行われました。世界ごとに固有の指標で測った変化は次のとおりです。
世界 | 指標 | 初回 | 後半 |
|---|---|---|---|
伴侶犬 | 交流回数 | 13 | 19 |
一車線の橋 | 通過時間 | 71秒 | 41秒 |
牧羊 | 囲い込んだ頭数 | 4頭中3頭 | 4頭中4頭 |
採石場の積込機 | スコア | 30 | 90.9 |
採石場の積込機はラウンド2で0点に落ち込んでから持ち直しており、単調な右肩上がりではありません。各世界の試行回数は少なく、傾向の提示にとどまる点は読み方として注意が必要でしょう。
限界と今後の展望
条件として使う深度や法線はコンパクトですが、細い構造を落としやすく、回転や色や材質といった状態を表現できません。長い遮蔽のあとに視覚履歴がそれらを失う可能性があります。また世界はいまのところ1つずつ人手で書かれており、解けるかどうかや練習する価値があるかを自動で検査する仕組みは用意されていません。
多数の世界から得た知見をどう選び、どう統合するかという問題も残されています。Long-WAM のように視覚文脈を長く取る世界モデルと比べると、AgentGarten は状態の管理をプログラム側に預けることで整合性を確保した点が対照的です。
コードで書けば同じインターフェースで描画できるという設計は、環境の数と難易度をエージェントの成長に合わせて増やしていく道筋を示しています。評価の厳密さはまだ発展途上ですが、世界モデルとエージェント学習をつなぐ構成の一案として検討に値します。
論文情報: "AgentGarten: Code Worlds for Evolving Agents"(Jiawei Chi et al., 2026) arXiv:2610.12374
本記事の図(図1、図2、図9、図10)は解説のため上記論文より引用しています。


