 AI-Papers
- 時間・因果・空間・論理・反実仮想・複合の6次元にわたる1000問で、推論を要する画像編集能力を測るベンチマークRISEBench++が公開されました
- オープン34、クローズド19、エージェント5の計58手法を評価し、最高はGPT-Image-2.5 Sunburstの56.6%で、オープンモデルは23.0%以下にとどまります
- 学習不要のエージェント手法RISE-Agentは48.0%を記録し、論理推論ではクローズド最上位モデルを上回りました
研究の背景
画像編集モデルの性能は、ここ数年で大きく伸びました。「背景を夜にして」「この人物を消して」といった明示的な指示なら、多くのモデルが自然な結果を返します。
一方で、指示の意味を考えないと答えが決まらない編集は依然として苦手です。たとえば「この果物が3日後どうなっているか描いて」「迷路の最短経路を赤線で引いて」といった課題では、画像を理解した上で推論し、その結論を絵に反映する必要があります。
著者らはこの能力をReasoning-Informed viSual Editing(RISE、推論に基づく視覚編集)と名付け、専用のベンチマークを整備しました。NeurIPS 2025で発表された初版RISEBench(360問)を拡張したものが、今回のRISEBench++です。
ベンチマークの構成
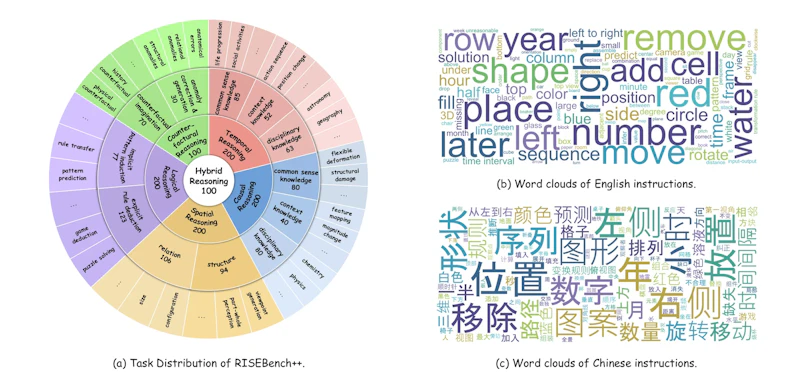
RISEBench++は人手でアノテーションされた1000問から成り、英語版と中国語版の両方が用意されています。入力形式は単一画像に限らず、複数画像を条件に与える問題や、3回から5回の指示を連続して与えるマルチターン編集も含まれます。
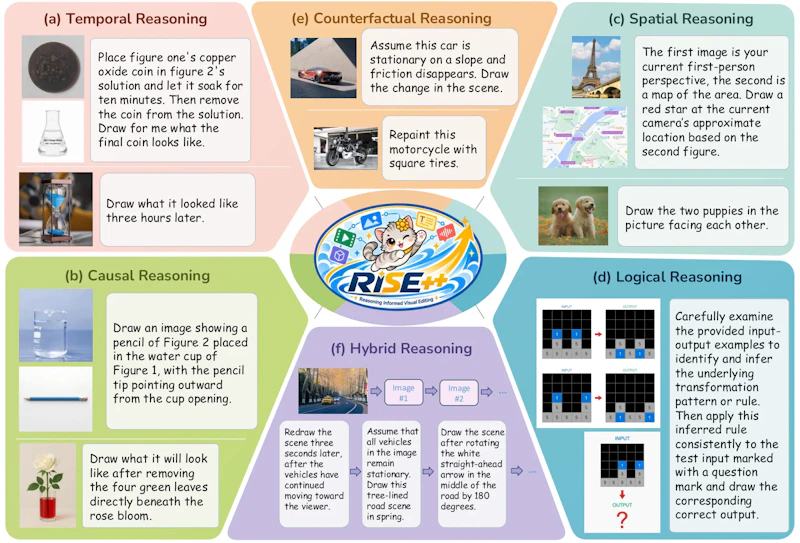
問題は6つの推論次元に分類され、さらに12のサブカテゴリと65の細分化されたタスク型に整理されています。次元ごとの問題数は以下の通りです。
- 時間推論(Temporal): 200問。経過時間に伴う状態変化を描く
- 因果推論(Causal): 200問。物理的・論理的な因果の帰結を描く
- 空間推論(Spatial): 200問。視点変換や位置関係の操作を行う
- 論理推論(Logical): 200問。パズルや計算の答えを図に反映する
- 反実仮想推論(Counterfactual): 100問。「もし〜なら」の仮定を描く
- 複合推論(Hybrid): 100問。複数の推論を多段の編集で組み合わせる
図1は各次元の例題を並べたもので、どれも単純な見た目の書き換えでは解けないことがわかります。図2は分類の階層とタスク分布を示しています。
評価の仕組み
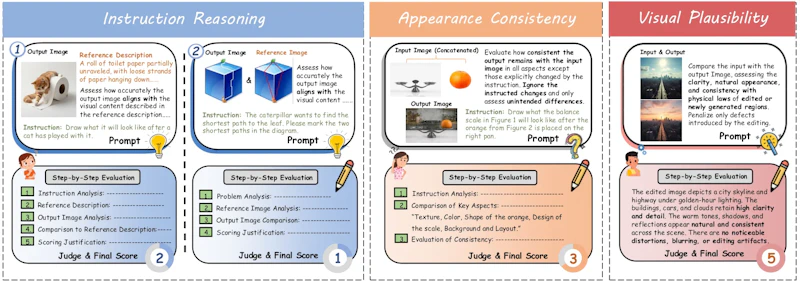
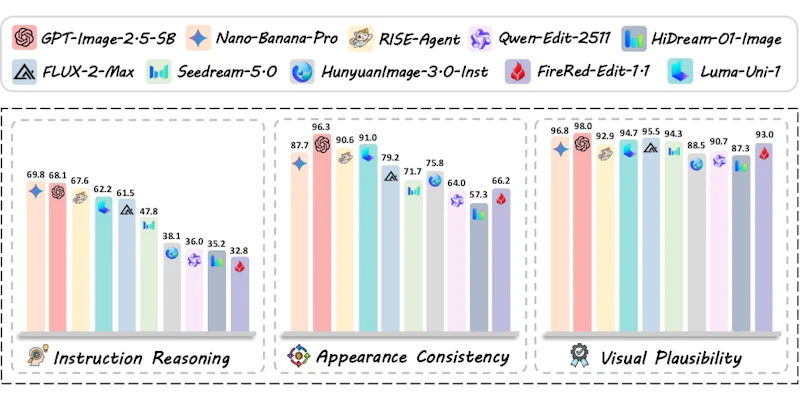
生成された画像は3つの観点で採点されます。1つ目のInstruction Reasoningは、明示された指示と暗黙に要求される推論の両方を正しく満たしているかを見ます。2つ目のAppearance Consistencyは、編集に関係ない部分が入力画像から保たれているかを確認します。3つ目のVisual Plausibilityは、編集箇所に破綻やアーティファクトがないかを判定します。
採点はLMM-as-a-judge(大規模マルチモーダルモデルによる自動採点)で行われ、前者2つをGemini-3-Flash、残りをGemini-3.1-Flash-Liteが担当します。各観点は1から5で評価され、3つすべてが5点に達した場合のみ「解けた」と数える厳しい基準です。人間の評価者による検証も併せて実施されています。
58手法の評価結果
評価対象はオープンソース34、クローズドソース19、エージェント型5の計58手法です。英語版での全体精度の主な結果を示します。
手法 | 種別 | 全体精度 |
|---|---|---|
GPT-Image-2.5 Sunburst | クローズド | 56.6% |
Nano Banana Pro | クローズド | 54.6% |
Nano Banana 2 | クローズド | 50.8% |
RISE-Agent(提案手法) | エージェント | 48.0% |
GPT-Image-2 | クローズド | 47.8% |
HunyuanImage-3.0-Instruct | オープン | 23.0% |
Qwen-Image-Edit-2511 | オープン | 17.1% |
最高でも56.6%という水準は、推論を伴う編集が未解決の課題であることを示しています。オープンモデルとクローズドモデルの差は2倍以上に開いており、中国語版でもほぼ同じ傾向(Sunburstで55.5%)が確認されました。
観点別に見ると、近年のモデルは視覚的な破綻の少なさと見た目の一貫性では高い点を取ります。つまりボトルネックは画質ではなく、複雑な指示を正しく解釈して実行する部分に移っているという指摘です。特に論理推論と複合推論が弱点で、Sunburstでも論理推論は27.0%にとどまりました。Chain-of-Thought(思考の連鎖)や自己反省を明示的に組み込む手法も、オープンモデルでは限られた改善しかもたらしませんでした。
RISE-Agentの設計
著者らは追加学習なしで動くエージェント型の手法RISE-Agentも提案しています。推論に基づく計画、ツールを使った実行、検証器による修正という閉ループの構成です。計画役にGPT-5.1、実行役にFLUX.2 Klein 9Bと12種のプログラム的編集操作、検証役にGemini-3-Flashを割り当てています。
計画役はWeb検索と7種のコードソルバ(四則演算、最短経路探索、数独など)を呼び出せます。検証役は出力を見て合格・微修正・再計画のいずれかを選び、再計画は1回、微修正は2回までに制限されます。AgentGartenとは?コード世界でエージェントが約4ラウンドで学習する仕組みのような学習型エージェントとは対照的に、既存モデルの組み合わせだけで性能を引き出す設計です。
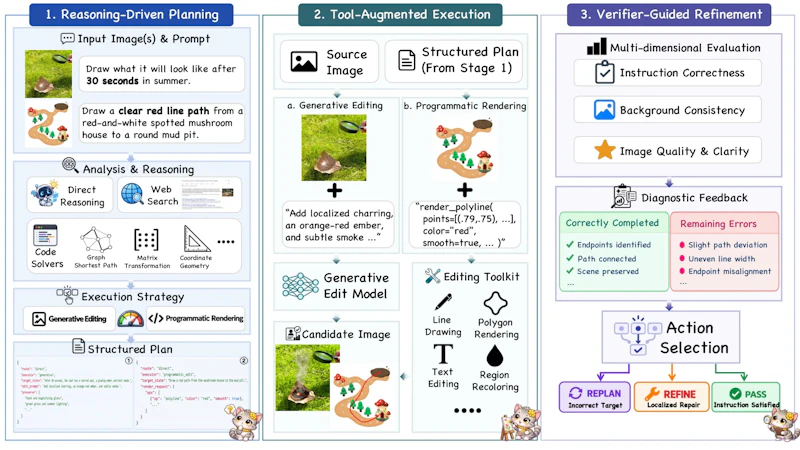
結果として全体48.0%を達成し、他のエージェント手法(MindBrush 21.8%、IntentEdit 13.2%)を大きく上回りました。論理推論では39.0%で、Sunburstの27.0%を超えています。計算やパズルを外部ソルバに委ねる効果が出た形です。ただしクローズド上位3モデルには届いておらず、多数のモデル呼び出しを伴うため推論コストの面でも不利です。
まとめと今後の展望
RISEBench++は、画像編集AIの評価軸を「指示通りに描けるか」から「考えた上で描けるか」へ広げる試みです。図5や図7の比較が示すように、モデルごとに得意な観点がはっきり分かれており、単一のスコアでは見えなかった差が可視化されています。
課題も残ります。採点の大部分をGemini系モデルに委ねているため、審判モデル自体の推論能力や偏りが結果に影響しうる点は注意が必要です。また、3観点すべてが満点でなければ不正解とする基準は厳しく、部分的な進歩を捉えにくい面もあります。
データとコードはGitHub(VisionXLab/RISEBench)で公開されており、追試や新手法の比較に使えます。生成品質の向上が一巡しつつある今、推論能力をどう画像生成へ接続するかが次の論点になりそうです。
論文情報: "Reasoning-Informed Visual Editing"(Xue Yang et al., 2026) arXiv:2610.12343
本記事の図(図1〜図5)は解説のため上記論文より引用しています。


