 AI-Papers
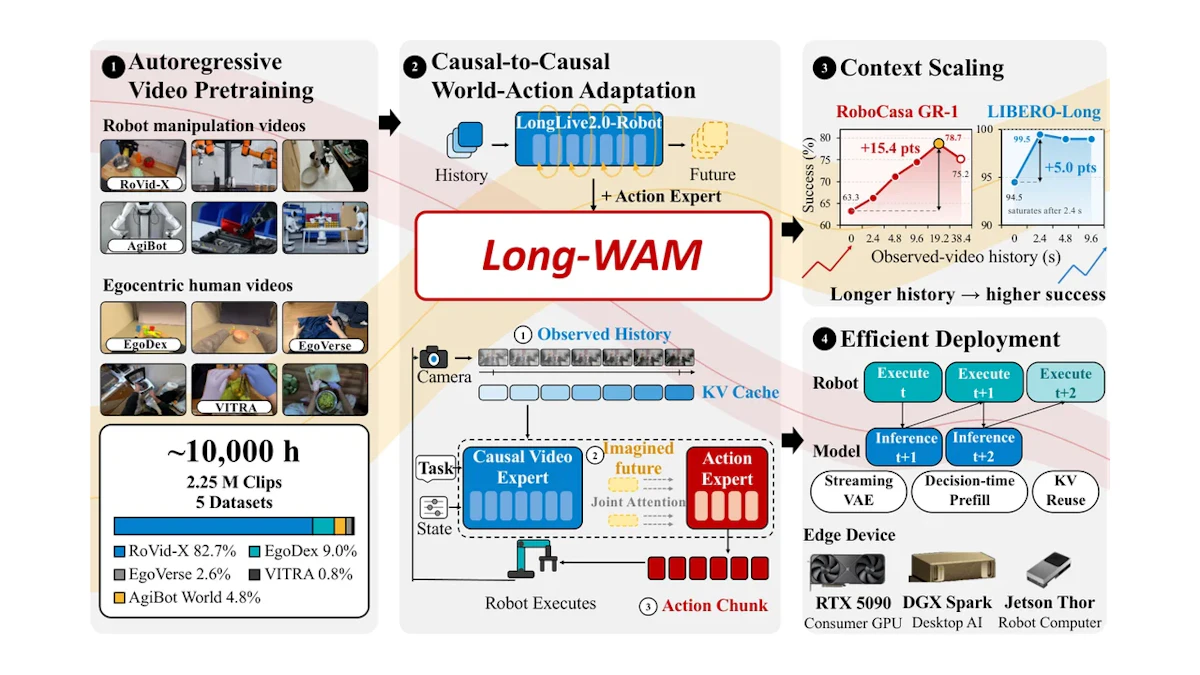
- NVIDIAらが提案したLong-WAMは、ロボット制御に使う視覚履歴を最大19.2秒まで広げ、RoboCasa GR-1の成功率を63.3%から78.7%へ引き上げました
- 約1万時間相当の動画で自己回帰的に事前学習したLongLive2.0-Robotを土台に、因果構造を保ったまま行動生成へ適応させる設計が鍵になっています
- NVFP4量子化とストリーミングVAE、非同期実行によりRTX 5090上で1チャンク107.4msを達成し、実機でも90〜100%の把持成功を記録しました
研究の背景
ロボットが動いている物体をつかむとき、現在のカメラ画像1枚だけでは判断材料が足りません。対象がどちらへどのくらいの速さで動いているのか、作業がどこまで進んだのかといった情報は、時間的な変化を見なければ分かりません。
一方で、過去の映像を長く取り込めば、その処理に時間がかかり行動の出力が遅れます。実時間で動くロボットにとって遅延は致命的で、ここに「履歴を増やしたいが増やせない」という緊張関係がありました。さらに、既存のVision-Language-Action(VLA、視覚と言語から行動を出すモデル)に素朴に過去フレームを足しても性能が伸びないことも知られていました。
Long-WAMの著者らは、この行き詰まりの原因を「履歴にアクセスできることと、履歴を実際に使えることは別物である」と整理します。長い文脈が効くかどうかは、土台となる動画基盤モデルの事前学習の仕方に依存するという主張です。
Long-WAMの仕組み
Long-WAMは、未来の映像を予測する世界モデルと行動生成を一体化したWorld-Action Model(WAM)です。モデル内部には映像担当と行動担当の2つのエキスパートがあり、映像側は視覚履歴とそれ以前の視覚ブロックだけを参照する因果的な構造を保ちます。行動側は観測履歴、予測された未来、そしてノイズの乗った行動チャンクを見てノイズ除去を行います。
予測された未来の潜在表現は画素に戻されることがなく、映像エキスパートのKVキャッシュがそのまま行動のノイズ除去で再利用されます。未来予測を捨てずに計算を節約する、実装上の工夫です。
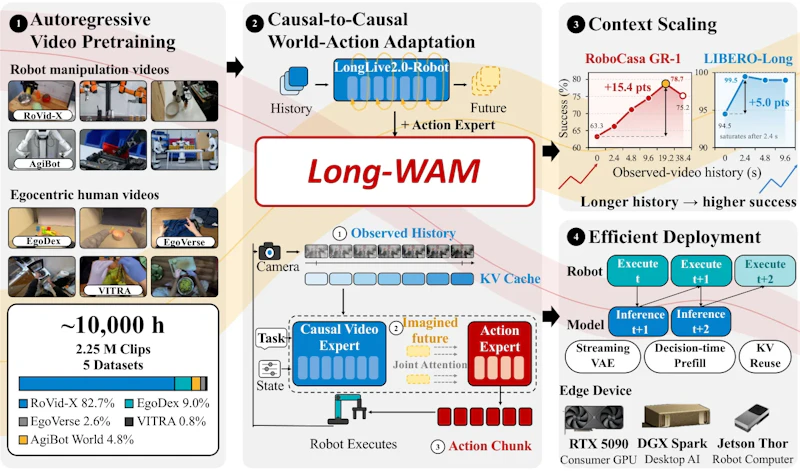
図1に示すように、学習は大きく2段階に分かれます。前段のLongLive2.0-Robotは、LongLive-2.0の16秒自己回帰チェックポイントを起点に、RoVid-XやAgiBot World、EgoDex、EgoVerse、VITRAといった約1万時間相当のロボット動画と一人称視点動画で継続学習されました。行動ラベルは使わず映像だけで予測的なダイナミクスを学ぶ設計で、学習規模はH100 64枚で約3万GPU時間です。
後段の因果-因果適応では、動画側の因果的な依存関係を壊さないまま、観測履歴を条件として行動チャンクのノイズ除去を学習します。双方向の注意で事前学習したモデルを土台にすると文脈を伸ばしても効果が出ない点が、この設計の必要性を裏づけています。長文脈の扱い方がモデルの前提に左右されるという論点は、UNREALとは?凍結LLMの内部表現で検索と長文脈処理を統合する新手法で扱われた言語側の議論とも通じます。
文脈は長いほど良いのか
RoboCasa GR-1 Tabletopでの検証では、自己回帰事前学習モデルの成功率は履歴が短い設定の63.3%から、19.2秒で78.7%まで上がりました。差は15.4ポイントです。ところが38.4秒まで伸ばすと75.2%へ下がります。
著者らはこの低下を、記憶能力の限界ではなくデータ側の問題と分析しています。38.4秒の設定では履歴の80.4%がパディングフレームで埋まり、実質的な情報が薄まってしまうためです。
対照的に、双方向事前学習(Wan2.2)から始めた場合は2.4秒で61.7%、9.6秒で64.1%、19.2秒で61.6%と、文脈を伸ばしても正味の改善がありません。自己回帰事前学習の優位は履歴なしでは3.3ポイントにとどまるのに、19.2秒では17.1ポイントまで開きます。なお最適な文脈長はタスク依存で、LIBERO-Longでは2.4秒付近がピークとなり94.5%から99.5%へ改善しました。
実時間制御を支えるシステム
文脈を伸ばすと推論時間も伸びます。RTX 5090では履歴なしの74.6msに対し、19.2秒の文脈では341.0msかかります。そこでLong-WAMは、観測チャンクを届いた順に符号化するストリーミングVAE、推論とロボット動作を重ねる非同期実行、呼び出し内でのKV再利用、映像エキスパートへのNVFP4量子化などを組み合わせました。
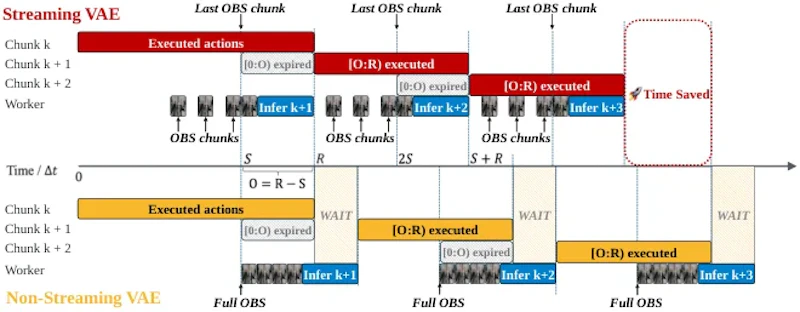
図3のように、全窓を一括で符号化する方式では引き渡しが遅れ、ロボットの待機時間が積み上がります。ストリーミング方式はこの遅れを吸収します。最適化後の1チャンクあたりの処理時間はRTX 5090で107.4ms(BF16そのままの実行比3.3倍)、DGX Sparkで328.2ms、Jetson AGX Thorで378.7msでした。非同期実行を入れてもRoboTwinの成功率は94.2%を保ち、比較対象のFast-WAMは76.4%に落ちています。
実験結果
4つのシミュレーション環境での主な数値は次の通りです。RoboCasa365では高レベルの計画をGPT-6 Astraに任せた構成も評価されています。
ベンチマーク | Long-WAM | 比較 |
|---|---|---|
RoboCasa GR-1 Tabletop | 78.7%(19.2秒文脈) | 63.3%(短い履歴) |
LIBERO-Long | 99.5% | 94.5%(現在観測のみ) |
RoboTwin 2.0(平均) | 94.4% | Clean 94.7% / Randomized 94.2% |
DOMINO(成功率) | 34.9% | Fast-WAM 19.9% |
RoboCasa365(計画器併用) | 54.4% | π0.5 + 同一計画器 30.5% |
動的な操作を集めたDOMINOでの差が大きく、履歴を使えることが動く対象への対応に直結していることが読み取れます。RoboCasa365では単体で31.4%ですが、計画器と組み合わせると54.4%まで伸び、記憶を持つ実行器として上位の計画を補う役割が示されました。
実機ロボットでの検証
実機評価はUnitree G1とYAMで行われました。G1ではコンベア上のカップを3.0から7.5cm/sの4速度で把持させ、90〜100%の成功率を記録しています。動いているカップを別のカップに重ねる複合タスクでは20試行中19回成功(95%)で、Fast-WAMとπ0.5は同条件で1回も成功しませんでした。
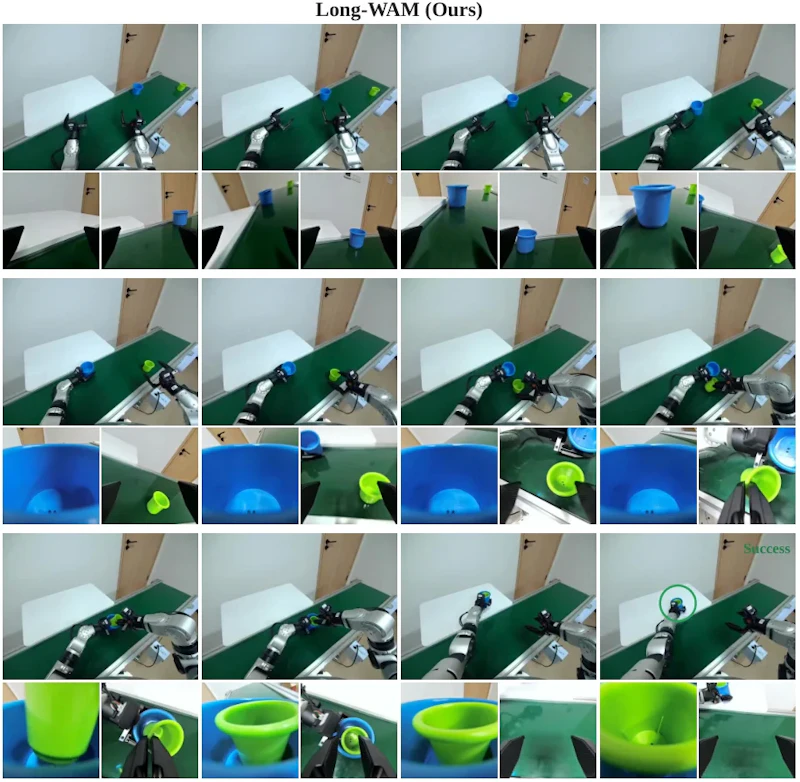
図12は、青いカップをつかんだ後に移動中の緑のカップを捕まえ、重ね合わせるまでの一連の動きです。同じタスクで比較手法は緑のカップを取り逃がし、段階の途中で止まっていました。YAMでは平均40秒を超える長尺タスク(色別のブロック仕分け、餃子の配置、ボウルの積み重ね)で平均81.7%でした。
まとめと今後の展望
Long-WAMは、長い視覚文脈を「持つ」だけでなく「使える」形にするには事前学習の因果構造が重要だと示し、同時に実時間制御に乗せるシステム面の設計もあわせて提示しました。コードはNVlabs/LongLiveで公開されており、追試しやすい点も価値があります。
一方で課題も残ります。現在は文脈長ごとに別のモデルを学習しており、テスト時に窓の長さを調整できる単一の方針が望まれます。38.4秒での性能低下が示すように、履歴の密度が高い長時間のロボット記録データも不足しています。
また実機での文脈長の体系的な検証は今後の課題とされ、文脈を伸ばすほど遅延が増える構造的なトレードオフも残ったままです。必要な場面だけ履歴を長く取る適応的な計算配分が、次の論点になりそうです。
論文情報: "Long-WAM: Scaling the Context of World-Action Models"(Wei Huang et al., 2026) arXiv:2610.10528, CC BY 4.0
本記事の図(図1、図3、図12)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


