 AI-Papers
- Domain-MoT(ドメイン対応AdaLN)により参照画像のドメイン属性とビデオを構造的に分離し、クロスドメインでの被写体特徴の忠実な保持を実現
- Video-Reference DualRoPEで参照画像とビデオトークンのRoPE空間を独立させ、複数被写体の空間関係を精密に制御
- クロスドメインスコア(CD-Score)でSOTA比18.7%向上(0.861 vs 0.725)を達成し、商用モデルのKling 1.6も含む全比較手法を上回る
研究の背景
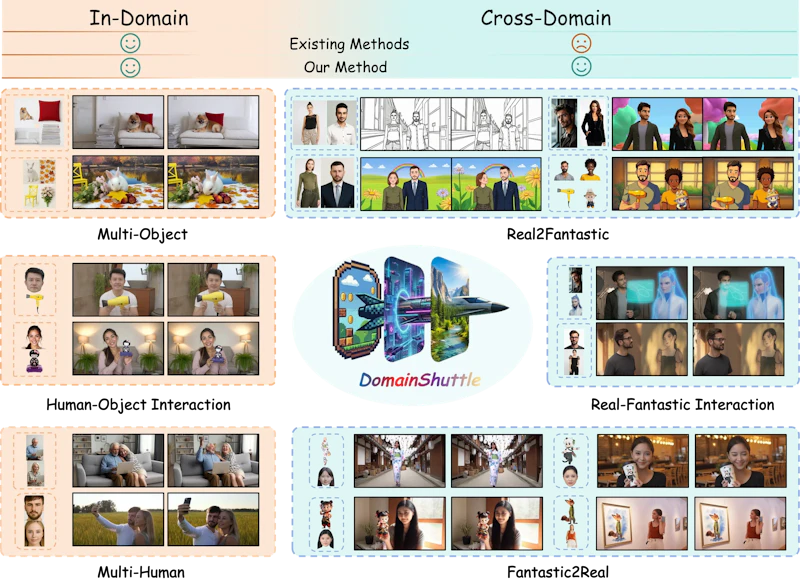
被写体駆動型テキスト動画生成(Subject-to-Video、S2V)とは、1枚または複数枚の参照画像に写った被写体の外見的特徴を保ちながら、テキスト指示に従った動画を生成する技術です。商品プロモーション動画の自動作成や、キャラクターのアニメーション生成など、幅広い実用用途が期待されています。
しかし既存の手法には大きな課題がありました。「同一ドメイン」での再現(例:写真からリアルな動画を生成)では高い忠実度を発揮できる一方、「クロスドメイン」の変換(例:写真のキャラクターをアニメ風に変換)では被写体の特徴が失われるか、ドメイン変換自体が不完全になります。この2つの特性はトレードオフの関係にあり、同時に高いレベルで達成することが困難でした。
3つの主要コンポーネント
DomainShuttleはこの課題を解決するため、3つのコンポーネントを組み合わせたアーキテクチャを提案しています。
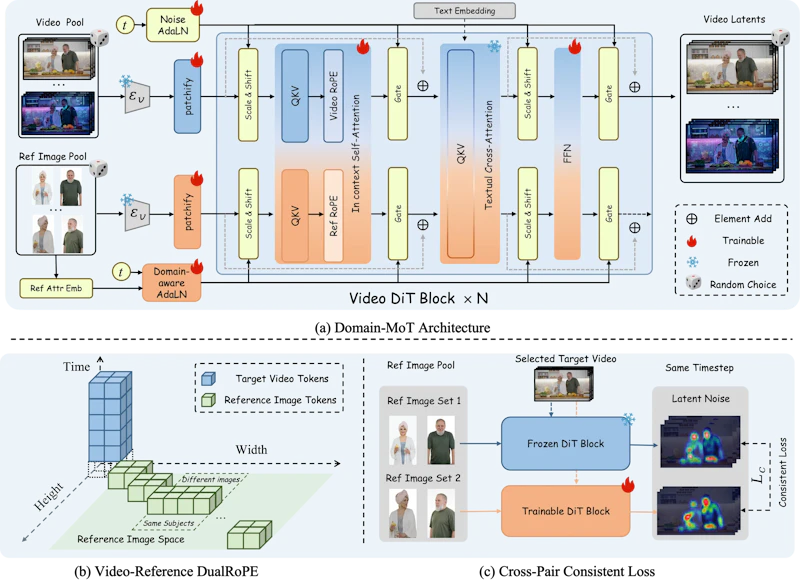
- Domain-MoT: ビデオと参照画像の処理経路を明示的に分離する機構
- Video-Reference DualRoPE: 参照画像トークンとビデオトークンの位置情報を独立に符号化する仕組み
- Cross-Pair Consistent Loss: 参照画像の違いに左右されない特徴を学ばせる損失関数
それぞれの役割を順に見ていきます。
Domain-MoT(ドメイン対応Mixture of Transformers)は、ビデオブランチと参照ブランチにそれぞれ独立したQKV投影とRoPEを割り当て、参照ブランチにはDomain-aware AdaLN(適応的層正規化)を導入します。AdaLNとは、時間特徴とドメイン属性の2種類の情報で特徴量を調整する仕組みです。
これにより、参照画像が持つドメイン属性(アニメ調の線やテクスチャなど)がビデオに過剰に混入することを防ぎます。一方で被写体の本質的な特徴(顔の輪郭・体型・色など)は正確に継承できます。
Video-Reference DualRoPE(VR-DualRoPE)は、空間的な位置情報の符号化を改善します。RoPE(Rotary Position Embedding)とは、トークン間の相対的な位置関係を回転行列で表現する手法です。従来手法では参照画像を追加のビデオフレームとして扱っていたため、参照被写体とビデオ内の被写体の位置関係が混乱することがありました。
VR-DualRoPEは参照画像トークンを独立したRoPE空間(時間インデックスを0に固定)に配置し、ビデオトークンと明確に分離します。さらに、異なる被写体間には空間オフセットを設け、同一被写体の複数画像は近接して配置することで、被写体の同一性を空間的に表現しています。
Cross-Pair Consistent Loss(CCL)は学習時の損失関数です。同一の動画に対して2組の異なる参照画像セットを用い、学習可能なブランチと凍結されたブランチでそれぞれ予測を行い、その差分を最小化します。これにより、視点の違いや照明変化・モーションブラーといったノイズに依存しない、被写体の本質的な特徴のみをモデルが学習できます。
実験結果
既存手法との定量比較では、クロスドメイン評価指標(CD-Score)においてDomainShuttleが最高値を記録しました。次の表は主な指標をまとめたものです。
指標 | DomainShuttle | 次点(FFGO) |
|---|---|---|
CD-Score | 0.861 | 0.725 |
DINO-I(同一ドメイン被写体一貫性) | 0.400 | - |
CLIP-I(同一ドメイン被写体一貫性) | 0.690 | - |
CD-ScoreはFFGOと比べて18.7%の向上です。比較対象には商用モデルのKling 1.6、およびVACE・MAGREF・Phantom・HuMo・BindWeaveなどの研究手法が含まれています。
CD-Scoreの算出にはNano-CLIP指標が用いられています。参照画像にドメイン変換を施した編集済み画像と、各手法が生成した動画フレームのCLIP類似度を比較する評価方法です。同一ドメインの被写体一貫性でも競争力のある数値を示しており、クロスドメインの柔軟性と同一ドメインの忠実度を同時に実現しています。
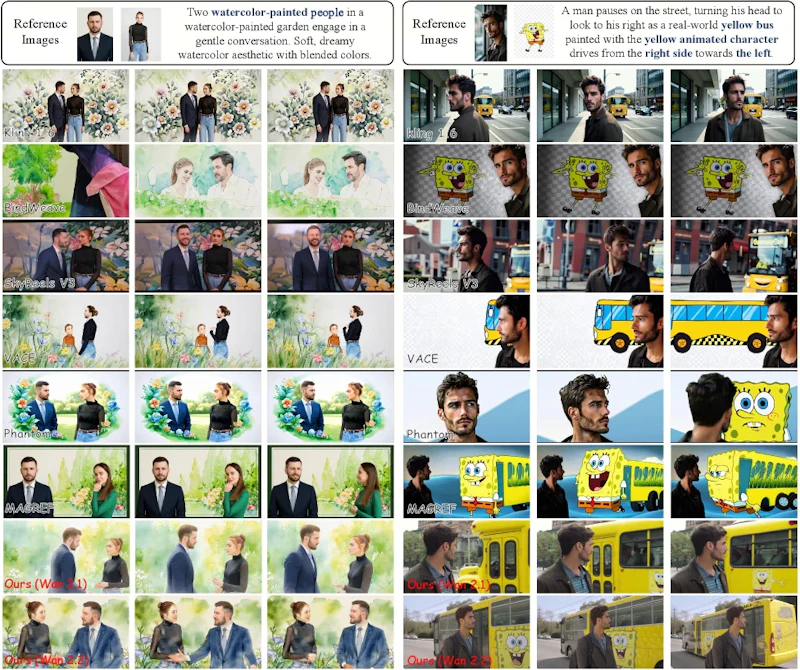
定性的な比較でも優位性が確認されています。ファンタジーキャラクターが印刷された黄色いバスの生成、実世界のフィギュアへのキャラクター変換、ペーパーカットアートへの変換など、従来手法が苦手としていた複雑なシナリオで高品質な動画を生成できました。ユーザースタディでも動画品質・テキスト制御性・オープンドメイン被写体一貫性のすべての評価項目でベースラインを大きく上回っています。
各コンポーネントの検証
各コンポーネントの貢献は、構成要素を一つずつ取り除く実験(アブレーション)で検証されています。Domain-MoTがない場合、参照被写体がすべてファンタジードメインに引き込まれてしまいます。VR-DualRoPEがない場合は、複数の被写体の相互作用が誤った位置関係で生成されました。
CCLがない場合、モデルが参照画像をそのままコピーする傾向が現れます。3つすべてを組み合わせることで最良の結果が得られることが確認されています。
まとめと今後の展望
DomainShuttleは、同一ドメインとクロスドメインの両方で高い性能を持つ被写体駆動型動画生成手法です。商用モデルを含む既存手法を超える定量・定性評価結果を得ており、商品プロモーション動画やキャラクターコンテンツ制作など実用的な応用が見込まれます。
スタイルと被写体を独立して制御する発想は画像生成の分野でも広がっており、FreeStyleとは?コミュニティLoRAでスタイルとコンテンツを独立制御する画像生成手法も参考になるでしょう。
一方で、生成速度や計算コストについては論文中で詳しく触れられていません。また、著作権に関わるキャラクターや商品のドメイン変換については、実用上の検討が必要な場面もあります。今後はリアルタイム生成や、より多様なドメインへの対応拡張が期待されます。
論文情報: "DomainShuttle: Freeform Open Domain Subject-driven Text-to-video Generation"(Nan Chen et al., 2026) arXiv:2606.26058
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


