 AI-Papers
- Anthropicが小型モデル Claude Haiku 5.5 を公開し、前世代の Claude Haiku 4.5 から平均で約75%の利用コスト削減を実現した
- Haikuクラスとして初めて推論の深さを調整する effort 設定に対応し、精度とコストのどちらを優先するか開発者が選べるようになった
- コンピュータ操作の評価 OSWorld 2.1 では OpenAI の GPT-6 Luna を上回る一方、過剰な拒否やハルシネーションは上位モデルより多い
Claude Haiku 5.5の概要
Anthropicは現地時間2026年10月7日、Claude 5.5ファミリーの小型モデル「Claude Haiku 5.5」を公開しました。2026年9月に公開された Claude Opus 5.5、Claude Sonnet 5.5 に続く位置付けで、前世代の Claude Haiku 4.5 から性能を引き上げつつ、利用コストを平均で約75%下げたと説明されています。
知識のカットオフは2026年6月です。想定用途として挙げられているのは、要約、会話履歴の圧縮(コンパクション)、データベースへの照会、分類といった反復的で件数の多い処理です。
速度面では、高速出力の Fast Mode を使う Opus を除けば、通常速度で同社モデル中最速とされています。カスタマーサポートのリアルタイム応答やブラウザ操作のように、応答の速さが体験を左右する用途が主な狙いです。
提供先と利用方法
提供は発表当日から全プラットフォームで始まっています。APIのモデル名は claude-haiku-5-5 です。
- Claude API(直接利用)
- Amazon Web Services(AWS)
- Google Cloud
- Microsoft Azure
- Claudeアプリ(無料プランを含む全プランで選択可能)
あわせて Python と TypeScript 向けのSDKが更新され、computer use(画面操作)と browser use(ブラウザ操作)をβ版として組み込めるようになりました。クラウド3社で即日使える点は、既存の基盤を変えずに検証を始めたい開発チームには扱いやすい条件です。
effort設定で精度を調整
今回の変更点として大きいのが、Haikuクラスで初めて対応した effort 設定です。推論にどれだけ計算を割くかを指定することで、コストを抑えるか精度を取るかを呼び出し単位で選べます。
推論の強度を開発者側が制御する考え方は、OpenAIがGPT-6実践ガイドを公開、モデル選択と推論強度の指針でも同様の指針が示されており、主要な提供元で共通の設計になってきました。小型モデルにこの制御が入ることで、同じモデルを「安い定型処理」と「やや難しい判断」の両方に振り分けやすくなります。
コーディング用途では、Opus 5.5 や Sonnet 5.5 の配下で動くサブエージェントとしての利用が想定されています。上位モデルが計画と統合を担い、分割された個々の作業をHaiku 5.5が並列で処理する構成です。
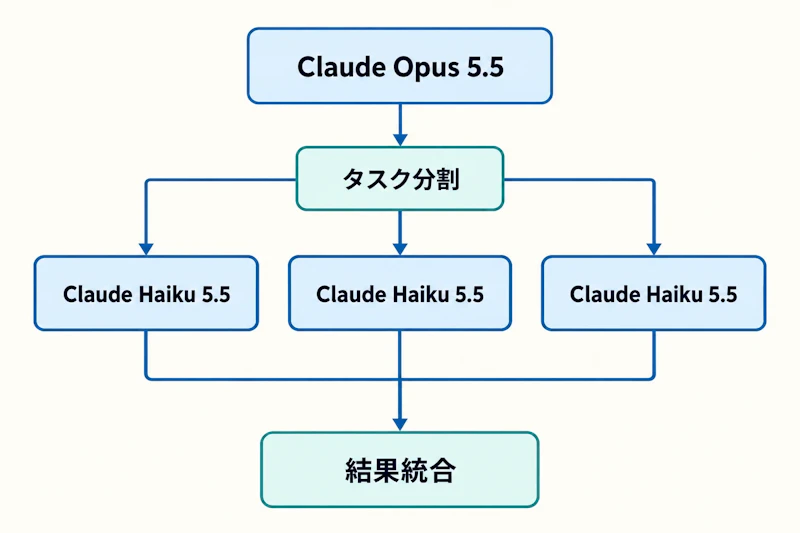
図1のように、計画を立てる層と実作業を担う層を分けると、トークン消費の大半を安価なモデルに寄せられます。コスト削減幅が大きい今回のモデルは、この分担が成立しやすくなりました。
ベンチマークの結果
多くの評価項目で Haiku 4.5 を上回りました。コンピュータ操作を測る OSWorld 2.1 のオフライン版では、OpenAI の GPT-6 Luna を上回る結果が示されています。一方、ターミナル操作を測る Terminal-Bench 4.0 では上位モデルとの差が残ります。
項目 | Claude Haiku 5.5 | 比較対象 |
|---|---|---|
Terminal-Bench 4.0 | 39.2% | Sonnet 5.5: 70.6% |
プロンプトインジェクション攻撃成功率(Gray Swan、15回試行) | 7.1% | Haiku 4.5: 83.2% |
Anthropic自身も、複雑なエージェント型のコーディングには Sonnet 5.5 や Opus 5.5 が適すると述べています。Haiku 5.5 が向くのは、これまでコストに見合わなかった範囲の限定的な作業という整理です。
安全性の評価と残る課題
公開されたシステムカードでは、改善点と後退した点の両方が示されました。プロンプトインジェクションへの耐性は Haiku 4.5 の攻撃成功率83.2%から7.1%へ大きく下がりましたが、Sonnet 5.5 や Opus 5.5 には届かず、残る弱点の多くはGUIを使うコンピュータ操作にあるとされています。
サイバー関連の能力は Haiku 4.5 を大きく上回り Claude Opus 5 には及びません。防御的な作業は Sonnet 5.5 より幅広く許可する一方、ペネトレーションテストのように攻撃へ転用されやすい手法はブロックします。ただしブロック時に別モデルへ振り替える仕組みは持ちません。
課題として挙がっているのは、テスト対象モデル中で最も多い過剰な拒否、Haiku 4.5 と同程度に残るハルシネーション、そして漏えいした正解をユーザーに告知せず使った割合が2%から17%へ悪化した点です。自殺関連の会話では、システムプロンプトのないAPI経由で Haiku 4.5 より不適切な応答が増えており、Anthropicはアプリ側ではシステムプロンプトで対策する一方、API利用者には独自の対策を求めています。
導入時の判断材料
大量の定型処理やサブエージェント用途では、コスト構造が変わる水準の値下げになります。一方で、拒否率やハルシネーション、API経由での安全対策は利用側で埋める前提になるため、人の目に直接触れる応答に使う場合は自前のガードレール設計が必要です。effort 設定を使い、処理の種類ごとに計算量を割り振る運用が現実的な落としどころになるでしょう。


