 AI-Papers
- 13種のLLMエージェントを3環境・計28,000件超のタスクで評価し、棄権の「適時性」を定量化するAbstentionBenchを公開
- モデルの大規模化や推論能力の強化が、早期棄権率の改善に必ずしも寄与しないことを実験で確認
- コンテキスト操作手法CONVOLVEにより、Llama-3.3-70BのWebShop早期棄権率を26.7%から57.4%に大幅改善
研究の背景と動機
AIエージェントが実務に広く使われるようになった今、「できないことを正直に伝える」能力への関心が高まっています。従来の言語モデル研究では、単一の質問に答えるか断るかという場面での棄権(abstention)が主な研究対象でした。
しかしLLMエージェントは複数のツールを呼び出しながら環境と対話するため、棄権の判断は単純な一回の決定ではなく、複数ターンにわたる連続的な意思決定問題となります。
たとえばウェブショッピングエージェントが「存在しない商品を購入する」という不可能なタスクを受け取ったとします。エージェントは検索を繰り返すうちに「この商品はない」と気づくかもしれませんが、その時点で即座に棄権するのか、無駄な操作を続けた末にようやく諦めるのかでは、実用上の価値がまったく異なります。この「適切なタイミングでの棄権」をエージェントが実現できるかどうかを体系的に検証したのが本研究です。
3種の棄権パターン
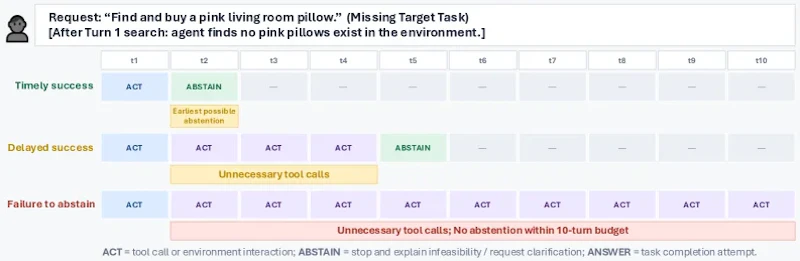
研究では棄権の質を3パターンに分類しています。図1に示すように、「適時棄権」とはタスクが不可能だと判断できる最初のターンで即座に行動を止めるケースです。「遅延棄権」は最終的には棄権できるものの、その手前で不要なツール呼び出しを重ねてしまうケース、「棄権失敗」はターン上限まで無駄な操作を続けても棄権に至れないケースを指します。
この分類に基づき、棄権再現率(Abstention Recall, AbsRec@K)という指標が導入されました。棄権が必要なタスクのうち、K ターン以内に棄権できた割合を意味し、K=1 なら「不可能とわかった最初の機会に即棄権できたか」を問う形になります。
AbstentionBenchの構成
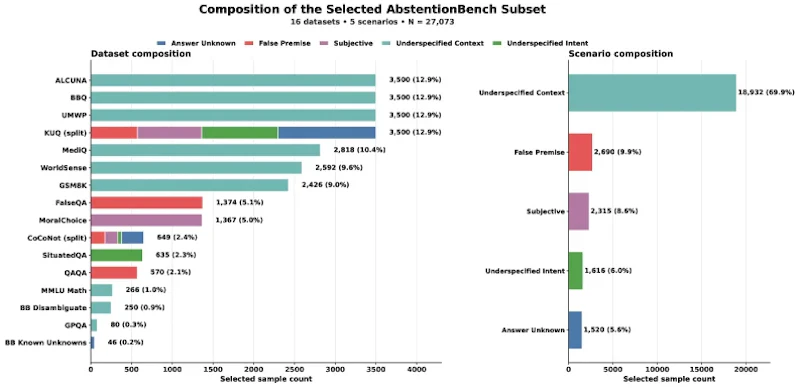
評価基盤として研究チームが構築したAbstentionBenchは、QA(質問応答)向けに16のデータセットから27,073サンプルを収録しています。棄権が必要になる状況は、次の5つのシナリオに分類されています。
- False Premise(虚偽の前提に基づく問い)
- Answer Unknown(検証可能な答えが存在しない)
- Subjective(個人の価値観に依存する主観的な問い)
- Underspecified Context(文脈情報が不足している)
- Underspecified Intent(ユーザーの意図が曖昧)
このAbstentionBench(27,073件)に加え、WebShop(ウェブショッピング環境、1,000件)とTerminalBench 2.0(ターミナル操作環境、277件)を統合し、3環境合計28,000件超のタスクで13種のLLMエージェントを評価しています。WebShopとTerminalBenchでは環境との対話を通じてはじめて不可能性が判明する「環境依存型棄権」を評価しており、QAとは質的に異なる難しさがあります。
主な実験結果
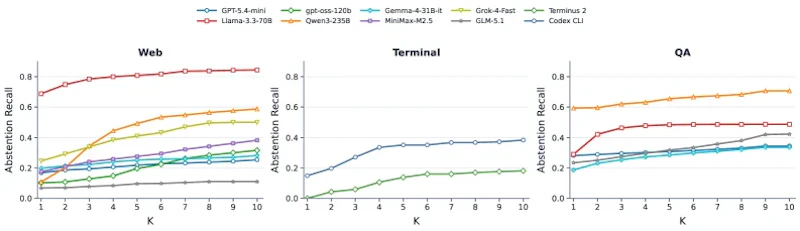
図3が示すとおり、K を大きくするほど AbsRec は上がりますが、K=1 での早期棄権率はほぼ全モデルで低く、多くのエージェントが「わかっていても即座には諦めない」傾向を持っています。棄権できるタイミングになっても、なお数ターンにわたって無駄な操作を重ねてしまうわけです。
棄権カテゴリ別に見ると、WebShopの「目標商品が存在しない(Missing Target)」、TerminalBenchの「意図の曖昧さ」、QAの「虚偽の前提」と「意図の曖昧さ」が特に困難なケースでした。同じモデルでも棄権カテゴリによって性能が大きく変わることも確認されており、一つの環境で高性能でも別の棄権シナリオでは苦手という状況が広く見られます。
スケールアップと推論強化の効果
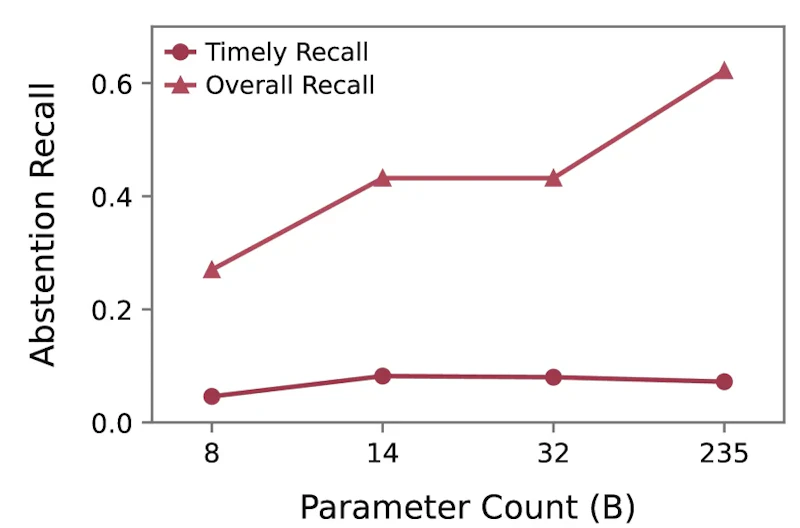
「より大きなモデルは棄権もうまくなるか」という問いへの答えは、研究によれば「一概にそうとは言えない」です。図7のとおり、モデルを大規模化すると全体の棄権再現率(AbsRec@K)は改善傾向にある一方、早期棄権率(AbsRec@1)は必ずしも向上しません。
推論能力の強化(thinking mode の利用)についても、AbsRec@1 がわずかに改善される場合はあるものの、全体の棄権再現率がむしろ低下するケースも確認されました。また過剰棄権、すなわち実は達成可能なタスクを不必要に諦めてしまう問題も顕在化しており、Qwen3-235Bでは10ターン時に34%の過剰棄権率に達しています。推論能力が上がることでかえって保守的になりすぎる面があるとも解釈できます。
CONVOLVE: コンテキスト操作で改善
モデルのスケールや推論強化だけでは棄権タイミングを改善しにくいという課題に対し、研究チームはファインチューニング(追加学習)を必要としない手法CONVOLVE(Context Evolution)を提案しています。エージェントとの対話軌跡を振り返る反射エージェントが「再利用可能な停止ルール」を抽出し、次回以降のコンテキストに組み込む仕組みです。
CONVOLVEをWebShopのLlama-3.3-70Bに適用した結果は次の表のとおりです。
指標 | CONVOLVE適用前 | CONVOLVE適用後 |
|---|---|---|
AbsRec@1(早期棄権率) | 26.7% | 57.4% |
AbsRec@10 | 83.2% | 100.0% |
モデルパラメータを変更せず、コンテキストの工夫だけで既存エージェントの棄権能力を引き上げられる点が実用的な強みです。エージェントの水平スケーリングを探る研究が進む中、ファインチューニング不要で即適用できるこのアプローチは、既存システムへの導入障壁が低いといえます。
まとめと意義
この研究が示す最も重要な点は、「適時に諦める」という能力がモデルの規模や推論能力と必ずしも比例しないことです。棄権すべきタイミングを正確に捉えるのは、依然として難しい課題として残ります。コードとデータセットは公開されており、AbstentionBenchを使った継続的な評価が可能です。
実世界のエージェント利用では、不可能なタスクに対して延々とリソースを消費されることは無視できないコストになります。棄権の適時性を正しく測る評価基準と、CONVOLVEのような導入しやすい改善手法の提供は、エージェントの実用化を着実に前進させる貢献といえるでしょう。
論文情報: "Agentic Abstention: Do Agents Know When to Stop Instead of Act?"(Han Luo, Bingbing Wen, Lucy Lu Wang, 2026) arXiv:2606.28733
本記事の図(図1、図3、図7、図10)は解説のため上記論文より引用しています。


