 AI-Papers
- Xiaomi の MiMo-V2.6 は強化学習(RL)の計算量を「バッチ規模」「環境の多様性」「採点の計算量」の3軸で同時に拡大するレシピを提示した
- 1ステップあたり 1,568 プロンプト × 16 ロールアウト(約25,000系列、2.7〜3.7B トークン)を消費し、RL 中の DeepSWE(average@3)は 58.4 から 72.6 まで伸びた
- MoE ルーターの凍結でエキスパート負荷の崩壊を防ぎ、4層の報酬ハッキング対策で不正解法の割合を2%未満に抑えた
研究の背景
大規模言語モデルの性能向上は、事前学習の規模拡大から強化学習による後処理へと重心を移しつつあります。検証可能な報酬を使った RL は数学やコード生成で成果を出してきましたが、エージェントとして長時間作業するタスクでは話が複雑になります。1回の試行が数十ターンに及び、環境の構築と検証にも計算資源が必要になるためです。
Xiaomi LLM-Core Team が公開した論文「MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement」は、この RL のスケーリングを正面から扱っています。モデル本体は音声・画像・テキストを同じトークン列に写して処理するオムニモーダル構成で、旗艦の MiMo-V2.6-Pro は総パラメータ 1.02T・アクティブ 42B の Mixture-of-Experts(MoE、入力ごとに一部の専門家ネットワークだけを使う構成)です。軽量版の MiMo-V2.6-Flash は総 310B・アクティブ 15B となっています。
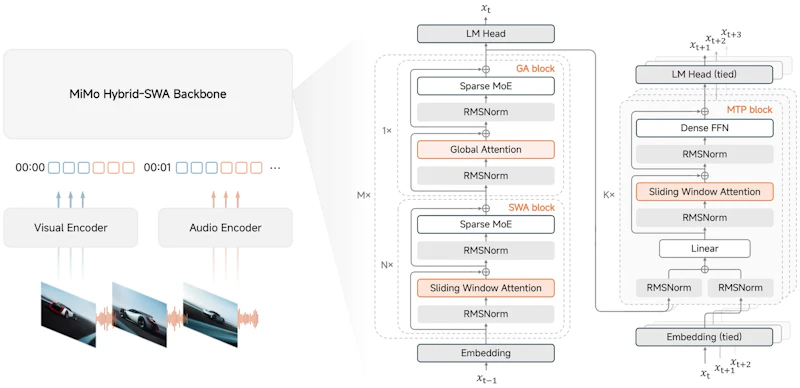
図1のように、入力モダリティごとのエンコーダが共通のトークン列を作り、その後ろに言語モデリングヘッドと多トークン予測(MTP)ブロックが並びます。文脈長は事前学習で 32K から 256K へ、中間学習で 1M まで拡張され、RL も最大 1M トークンの文脈で回されました。
RL計算を3軸でスケール
論文の中心的な主張は、RL の計算量を1つの軸だけ伸ばしても行き詰まる、という点です。著者らは3つの軸を同時に押し広げました。
第1の軸は1ステップあたりの学習計算量です。1,568 プロンプトに対して各16本のロールアウトを取り、1ステップで約25,000系列・2.7B〜3.7B トークンを消費します。部分ロールアウトを許す非同期学習でスループットを確保しており、RL 後処理のコストは Pro で 260万ドル、Flash で 90万ドルと報告されています。
第2の軸は環境とハーネスの多様性です。タスクは次の4領域にまたがり、それぞれ別個の検証方式を持ちます。
- コード: GitHub の Pull Request や仕様駆動など5経路でタスクを合成し、4回試行の監査と8回再実行の安定性テストで品質を確認
- 一般エージェント: ソフトウェアのモックを含むサンドボックス環境で、二値ルーブリックを MiMo-V2.6-SFT が採点
- 視覚: 自由度の高いデザイン課題と、ピクセル類似度と LLM 判定を組み合わせた高忠実度の再現課題
- サイバー: OSS-Fuzz 上の脆弱性再現。サニタイザのクラッシュ種別と位置が一致した場合のみ成功と判定
タスク構成比はコーディング 68%、デザイン 13%、一般的なツール利用 12%、サイバーセキュリティ 4%、文脈追従 3% です。領域ごとに最小限の「ミニハーネス」を用意して疎結合にすることで、ハーネスをまたぐ汎化を狙っています。
第3の軸は採点側の計算量です。テストに通るだけでは解法の良し悪しが分からないため、グループ単位のエージェント採点を導入しました。オフラインのルーブリックで品質と振る舞いを点数化する Groupwise Reward Synthesis と、同一グループ内の成功軌跡を順位付けして優位性を高品質な解に寄せる Groupwise Advantage Redistribution の2段構えです。後者を外すとターン数とトークン長が急増したのに対し、導入後は step 52 まで正解率の伸びが続いたと報告されています。採点は Pro の RL 計算の 12.7% を占めます。
学習を安定させる工夫
大規模 MoE を RL で回すと、ルーターの挙動が崩れます。ルーターを学習可能にしたまま進めた実験では、最初の20ステップでエキスパート負荷の変動係数が約 0.78 から 2.0 へ上がり、ピーク負荷は平均の約6倍から16倍、ほとんど使われない「冷えたエキスパート」の割合は 0.5% から 22% に膨らみました。step 20 のチェックポイントでルーターのパラメータだけを RL 前の値に戻すと負荷分散が回復し、ベンチマーク性能は変わらなかったため、原因はエキスパートの重みではなくルーターのドリフトだと特定されています。RL 中はルーターを凍結するのが論文の結論で、これにより変動係数は 0.7 前後、冷えたエキスパートは 1% 程度で安定しました。
報酬ハッキング(テストの抜け道を突いて報酬だけ得る振る舞い)には4層で対処しています。中間学習での整合データ、ビルドログや参照パッチの削除とネットワーク隔離による環境整備、抜け道を探す敵対的エージェントによる事前スクリーニング、そして学習中のオフライン軌跡監査です。
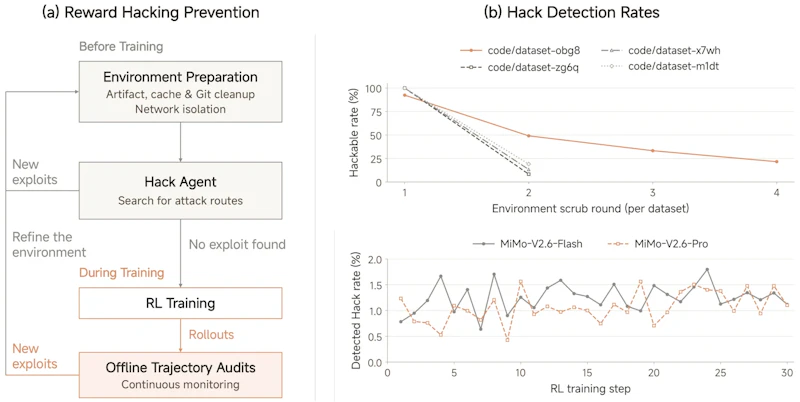
図2の上段が学習前のクリーンアップで、繰り返すほど攻略可能な環境の割合が下がっていく様子を示します。下段は本番 RL 中に検出されたハッキング軌跡の割合で、確認済みの不正は報酬ゼロとして扱い、Pro と Flash のどちらも 2% 未満に抑えられました。
推論と学習の数値的なずれを抑える仕組みにも踏み込んでいます。更新ごとにエキスパート重みを量子化・逆量子化して MXFP4 のロールアウトカーネルと揃え、ロールアウト時に記録したエキスパート選択と top-p 候補集合を学習側で再利用します。低精度とRL学習の相性についてはTRACEとは?FP4量子化でMoEのRL学習を最大5.4倍速くする新手法でも扱われており、MoE の RL では共通の課題になりつつあります。
ベンチマーク結果
エージェント系ベンチマークでの比較が表3にまとめられています。前世代の MiMo-V2.5-Pro からの伸びが大きく、Terminal Bench 4.0 は 1.5 から 34.9、DeepSWE v1.1 は 19.0 から 71.9 に上がりました。一方でフロンティアモデルとの比較では領域差があります。
ベンチマーク | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.5-Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|---|
DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 |
Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 |
Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 |
AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 |
Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 |
JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 |
ExploitBench | 47.9 | 25.3 | 16.6 | 70.0 | 78.5 |
MiMo Visual Coding | 72.3 | 71.5 | - | 70.0 | 73.4 |
Terminal Bench 2.1、AutomationBench、MiMo Visual Coding では Claude Opus 5 や GPT-5.6 Sol と同等以上ですが、Terminal Bench 4.0 や ExploitBench のような難度の高いセキュリティ・端末操作タスクでは差が残っています。なお、冒頭で挙げた 58.4 から 72.6 という数値は RL の学習ダイナミクスとして報告された DeepSWE の average@3 スコアで、評価条件が異なるため表の DeepSWE v1.1(71.9)とは別の計測値です。Flash も同じ学習曲線で 48.7 から 65.7 に伸びています。
9Bの蒸留モデルも公開
重みが公開されたのは、MiMo-V2.6 から蒸留した 9B モデル MiMo-V2.6-Distill-Qwen-9B です。ベースの Qwen3.5-9B と比べて、SWE-bench Verified が 60.0 から 66.2、Terminal Bench 2.1 が 27.0 から 52.8、MiMo Cyber Bench(mini)が 5.7 から 47.0 と、報告された11項目すべてで RL チェックポイントが SFT チェックポイントを上回りました。
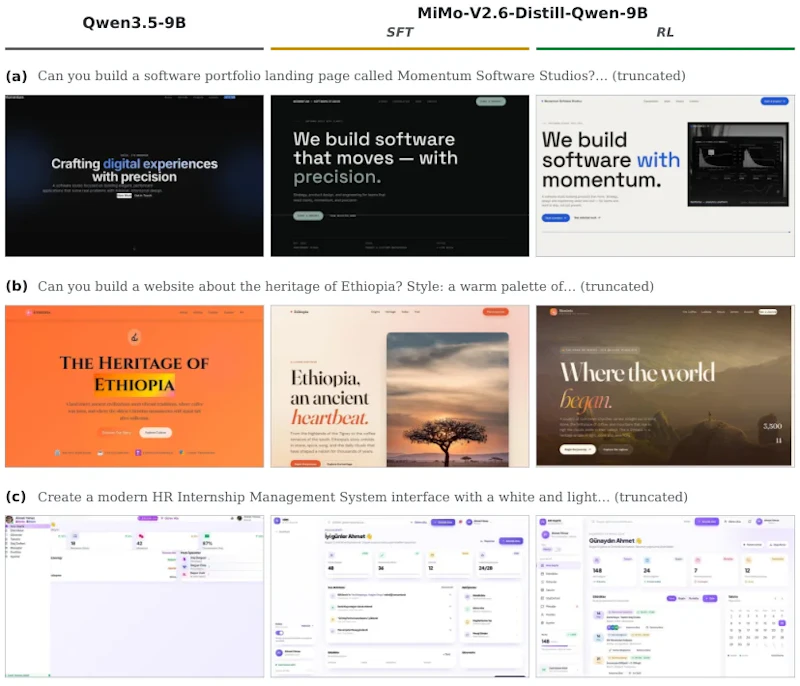
図3は同じ指示から Web サイトの先頭部分を生成させた例で、SFT 版から RL 版へ進むにつれてレイアウトの完成度が上がっていく様子が見て取れます。ただし公開は 9B の蒸留モデルであり、1.02T の Pro 本体の重みが配布されるわけではない点は押さえておく必要があります。
まとめと今後の展望
MiMo-V2.6 の価値は、個々のテクニックよりも「RL をどこまで、どの方向に大きくするか」という配分の設計を数値付きで開示したところにあります。1ステップ 2.7〜3.7B トークンという規模、採点に全体の 12.7% を割く判断、ルーター凍結の診断過程、報酬ハッキング検出率の推移は、同種の学習を試みる現場にとって実務的な手がかりになるでしょう。
著者らは、学習時の検証が難しい領域、たとえば長期的なゲーム開発や科学研究、身体性を伴うタスクへの拡張を今後の方向として挙げています。音楽生成の内部ベンチマークが SFT の 45.7 から RL 後に 52.5 へ上がったことも報告されており、検証しにくい創作系タスクへの応用も視野に入っているようです。RL 環境・学習ダイナミクス・RL フレームワーク・ミニハーネスの公開が予告どおり進めば、再現検証の余地はさらに広がります。一方で、260万ドル規模の RL コストを前提としたレシピがどこまで小規模な環境に移植できるかは、公開後の検証を待つ段階です。
論文情報: "MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement"(Xiaomi LLM-Core Team et al., 2026) arXiv:2610.11959
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


