 AI-Papers
- 視覚特徴をテキスト空間で整合させてから離散コードに変換する2段階フレームワークで、意味情報と細部情報の両立を実現
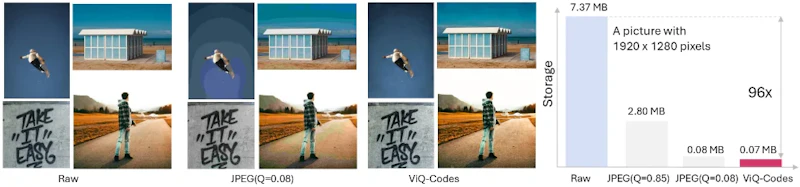
- 位置認識型ヘッドごと量子化と2D RoPEにより任意解像度の入力に対応し、画像ストレージを元サイズの1/96に圧縮
- 連続エンコーダのInternViT-6Bと同等の理解性能を保ちながら、マルチモーダル訓練を最大70%高速化
研究の背景
マルチモーダル大規模言語モデル(LLM)では、画像を数値ベクトルの列(視覚トークン)に変換してテキストと組み合わせる処理が一般的です。視覚トークンには大きく2種類あります。連続的な特徴量を直接LLMに渡す「連続エンコーダ」と、コードブック(整数の辞書)を使って数値列に変換する「離散トークナイザ」です。
連続エンコーダはSigLIP2やInternViTが代表例で、次元数が1000を超える高次元ベクトルを大量に扱うため、LLMの処理速度を大きく落とすという問題があります。一方、離散トークナイザは圧縮効率に優れて計算コストを下げられますが、従来手法では意味情報(高レベルセマンティクス)か画像の細部情報(低レベル詳細)のどちらかが犠牲になりがちでした。
Tencent HunyuanのViQは、この課題に正面から取り組み、両者を同時に満たすことを目指した離散視覚表現フレームワークです。
ViQの仕組み
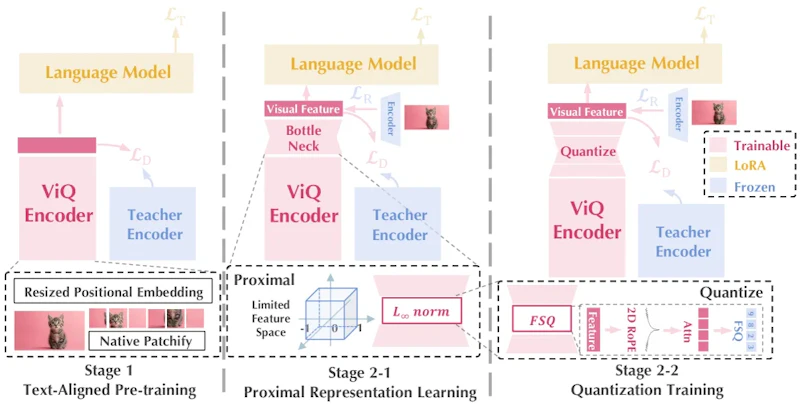
ViQは2つのフェーズで順番に訓練を進めます。
第1フェーズ「テキスト整合事前訓練」では、視覚エンコーダをLLMの監督下に置き、画像特徴をテキストの意味空間に整合させます。画像・質問・回答の3つ組を訓練データとして用いることで、視覚側のパラメータが更新され、視覚特徴はテキスト空間に沿った表現を獲得できます。加えて自己蒸留も組み合わせ、固定解像度モデルから任意解像度モデルへの意味情報の移転も図っています。
第2フェーズ「段階的視覚量子化」では、第1フェーズで得た高次元の特徴量を段階的に圧縮し、離散コードへ変換します。SigLIP2-gの1536次元から128次元、さらに6次元まで圧縮したうえで、FSQ(有限スカラー量子化)を適用します。コードブックは[8,8,8,5,5,5]の構成で、最大64,000種類のコードを表現できます。
また、各パッチを独立して量子化する「ヘッドごと量子化(head-wise quantization)」と2D RoPE(回転位置エンコーディング)を組み合わせることで、入力解像度に依存しない柔軟な処理が可能となります。
実験結果
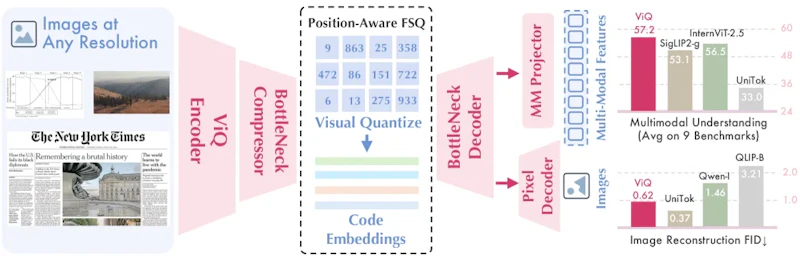
マルチモーダル理解性能を9つのベンチマークで評価した結果、Qwen2.5-7B(70億パラメータLLM)との組み合わせで平均63.9点を達成しました。主要な視覚エンコーダとの比較は次のとおりです。
視覚エンコーダ | 種別 | 9ベンチマーク平均 |
|---|---|---|
ViQ | 離散 | 63.9点 |
InternViT-6B | 連続 | 63.8点 |
UniTok | 離散 | 33.0点 |
QLIP | 離散 | 29.7点 |
従来の離散エンコーダを大幅に上回り、連続エンコーダのInternViT-6Bとほぼ同等の性能が得られています。
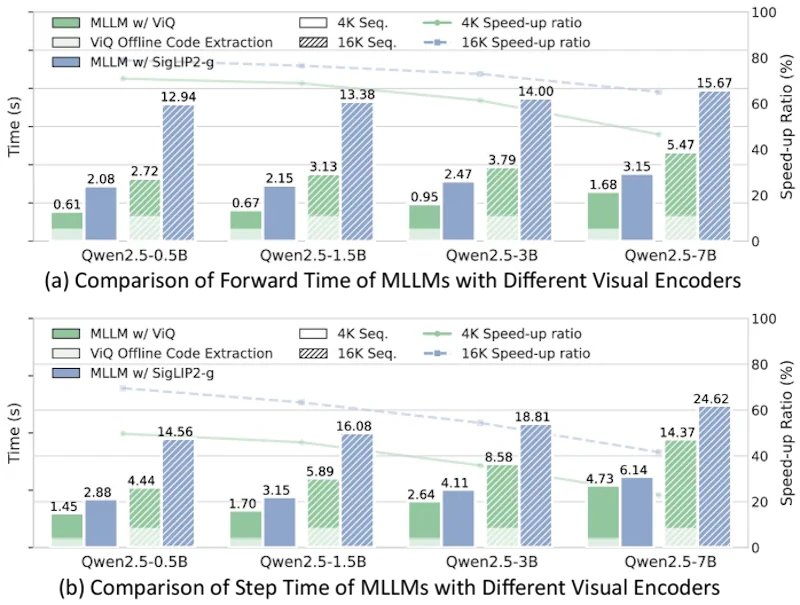
訓練効率の面では、16,000トークン設定のQwen2.5-0.5Bモデルで最大70%の高速化を確認しています。4,000トークン設定の7Bモデルでも46%の速度向上が得られており、大規模な訓練ほど恩恵が大きくなる傾向が見て取れます。
画像再構成の品質評価では、256×256のImageNetデータセットでrFID(再構成画像の品質指標)0.62を記録し、離散トークナイザの中でトップの数値を達成しました。さらに、ViQは元の画像データのわずか1/96というコンパクトなコードで画像を表現できることも示されています。
まとめと今後の展望
ViQは、離散視覚トークンが連続特徴量の代替として実用レベルに達したことを示す研究です。連続エンコーダと同等の理解性能を保ちながら訓練速度を最大70%引き上げられる点は、大規模なマルチモーダルモデルの開発コスト削減に直結します。テキスト整合を事前訓練に組み込み、量子化を段階的に進めるという設計は、今後のマルチモーダルアーキテクチャの参考になるでしょう。
今後の課題としては、より複雑な推論タスクへの適用検証や、動画などの時系列データへの拡張が考えられます。また、Ask, Solve, Generateのような自律進化型のマルチモーダル学習フレームワークとの組み合わせも、ViQが提供する高効率な視覚表現の活用先として期待されます。画像生成と理解を統合するモデルの基盤技術として、離散視覚表現の可能性はさらに広がりそうです。
論文情報: "ViQ: Text-Aligned Visual Quantized Representations at Any Resolution"(Xumin Yu et al., 2026) arXiv:2606.27313
本記事の図(図1〜図4)は解説のため上記論文より引用しています。


