 AI-Papers
- 知識蒸留は大きな教師モデルの振る舞いを小さな学生モデルに移す手法で、量子化やプルーニングとは目的も工程も異なります
- 従来の蒸留は学習時と推論時で入力分布がずれるため誤差が蓄積し、理論上は系列長の2乗で悪化します
- 学生の出力に教師が採点するオンポリシー蒸留は、強化学習と同等以上の性能を10分の1のGPU時間で達成した報告があります
知識蒸留とは何か
知識蒸留(Knowledge Distillation: KD)とは、性能の高い大きなモデル(教師モデル)が持つ振る舞いを、小さなモデル(学生モデル)に学習させる手法です。名前のとおり、原液から必要な成分だけを取り出すイメージで理解すると分かりやすいでしょう。
Large Language Model(LLM)の分野でこの手法が広く使われるようになったのは、実運用の制約が理由です。数百B(10億)パラメータ級のモデルは推論コストが高く、レイテンシも大きく、オンプレミスや端末上では動きません。かといって小さいモデルをゼロから学習させても、大規模モデルが持つ推論能力にはなかなか届きません。
そこで、すでに賢い教師モデルに答えを出させ、その出力を学習材料にして小さなモデルを鍛えます。教師が積み上げた学習の成果を、はるかに少ない計算量で引き継げる点が蒸留の本質的な価値です。Qwen3のテクニカルレポートでも、小型モデル群は旗艦モデルの知識を活用することで構築コストを大幅に下げたと説明されています。
蒸留の基本的な仕組み
ソフトラベルという情報源
通常の教師あり学習では、正解は「この単語が正しい」という1点だけを示します。これをハードラベルと呼びます。一方、蒸留では教師モデルが出力する確率分布そのものを学習の目標にします。
たとえば次の単語を予測するとき、教師が「猫: 0.6、犬: 0.25、鳥: 0.1」という分布を出したとします。この分布には「猫が最有力だが犬も十分ありうる」という教師の判断が含まれており、ハードラベルよりずっと情報量が多いのです。この分布をソフトラベルと呼び、学生の分布との差をKLダイバージェンス(2つの確率分布のずれを測る指標)で縮めていきます。
ホワイトボックスとブラックボックス
教師の内部にどこまでアクセスできるかで、手法は2つに分かれます。ホワイトボックス蒸留は教師のロジット(出力直前の数値)や確率分布をすべて利用でき、厳密な分布の比較ができます。オープンウェイトのモデルを教師にする場合はこちらです。
対してブラックボックス蒸留は、APIごしに生成されたテキストやスコアしか得られない状況で行います。この場合は教師に大量の回答を生成させ、それを通常のファインチューニング用データとして使うのが基本形になります。
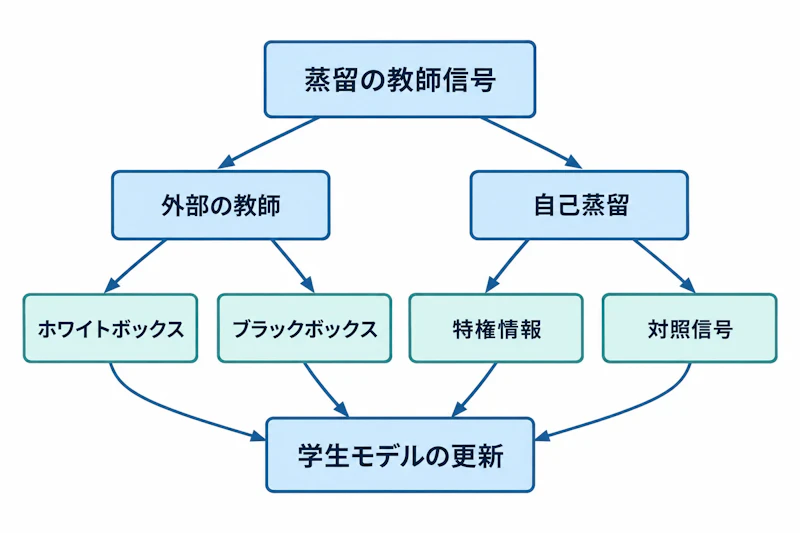
図1のように、教師を外部に置くか自分自身に置くかという軸もあります。同じモデルの異なる文脈での出力差を利用する自己蒸留も研究が進んでおり、誤答から遠ざかる方向に学習するNegative Self-Distillationのような手法も提案されています。
従来型蒸留が抱える弱点
ここまでの説明は、いわゆるオフポリシー蒸留(off-policy distillation)にあたります。教師が生成した完璧な系列を学生に模倣させる方式ですが、ここに構造的な問題が潜んでいます。
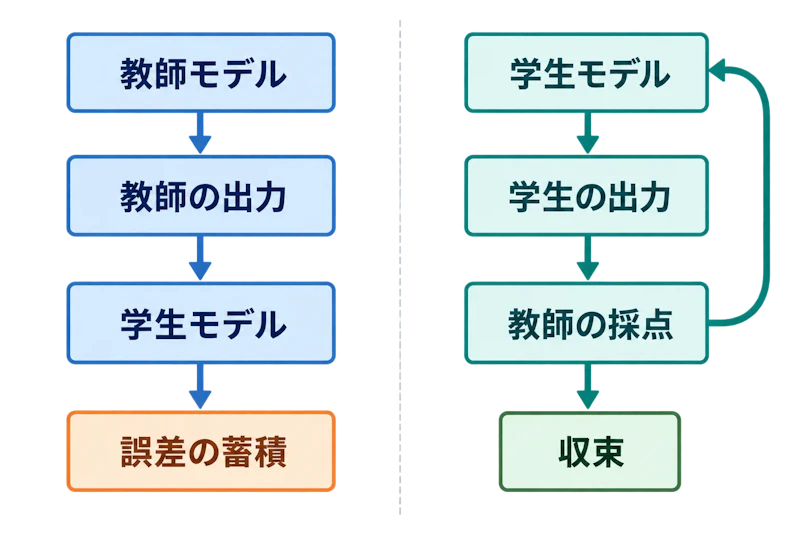
学習中、学生は常に「教師が書いた正しい途中経過」を前提に次のトークンを予測します。ところが実際に使われるときは、学生は自分が書いた文の続きを書かねばなりません。一度どこかで言い回しを外すと、その先は学習中に一度も見たことのない状況になり、破綻が連鎖します。
この現象は露出バイアス(exposure bias)と呼ばれ、模倣学習の理論であるDAggerの枠組みでは誤差が系列長Tに対してO(εT²)、つまりおおよそ系列長の2乗で悪化すると予測されます。推論過程が数千トークンに及ぶ現代の推論モデルでは、この差は無視できません。
オンポリシー蒸留の仕組み
2026年6月に公開されたSong氏とZheng氏によるサーベイ「Survey of On-Policy Distillation for Large Language Models」は、この課題への回答としてオンポリシー蒸留(On-Policy Distillation: OPD)を体系的に整理しています。発想は単純で、学習ループの向きを入れ替えます。
教師が書いた文を学生に読ませるのではなく、学生に自分で書かせ、その一文字ごとに教師が採点するのです。学生が実際に訪れる状態の上で教師のフィードバックを受けるため、誤差の蓄積はO(εT)まで抑えられます。サーベイはこれを「一度きりの模倣ではなく反復的な修正プロセス」への転換だと表現しています。
設計を分ける3つの軸
サーベイはOPDの手法群を3つの軸で整理しています。第1が目的関数で、教師の複数の解法を広くカバーする順方向KL、有力な解法に絞り込む逆方向KL、そしてトークンごとに両者を切り替える適応的手法があります。第2が信号源、第3が学習の安定化で、トークンごとの重み付けや難易度カリキュラムが該当します。
強化学習との数学的な近さ
興味深いのは、OPDと強化学習(Reinforcement Learning: RL)が同じ数学的空間にあるという指摘です。系列レベルの逆方向KLを方策勾配で最小化する操作は、教師と学生の対数確率比を報酬とするRLと等価になります。両者のインフラがほぼ共通化できる理由もここにあります。
違いは報酬の密度です。RLは1エピソードにつき正解か不正解かの1ビットしか得られませんが、OPDは全トークンに教師の評価が付きます。Thinking Machinesの報告によれば、Qwen3-8B-Baseを数学問題で訓練した際、OPDはRLと同等の性能に到達するまでの勾配更新回数が7分の1から10分の1で済み、総計算量では50倍から100倍の節約になったとされます。AIME 2024ベンチマークでは、オフポリシー蒸留のみの60%、RL後の67.6%に対し、OPDは74.4%を記録しました。GPU時間で見ると約17,920時間に対し約1,800時間です。
量子化やLoRAとの違い
「モデルを軽くする技術」として蒸留はよく量子化やプルーニングと並べられますが、扱っている対象がそもそも違います。量子化は重みの数値精度を落とす、プルーニングは重みを間引く、つまりどちらも既存モデルの構造をそのまま圧縮する操作です。
蒸留は違います。学生は別個のモデルであり、アーキテクチャもパラメータ数も自由に選べます。教師の知識を新しい器に移し替える工程なので、圧縮というより転移に近いのです。
項目 | 知識蒸留 | 量子化 | プルーニング | ファインチューニング/LoRA |
|---|---|---|---|---|
目的 | 能力の転移 | メモリ削減 | 計算量削減 | 特定用途への適応 |
モデル構造 | 別モデルを用意 | 同一 | 一部を削除 | 同一 |
教師モデル | 必須 | 不要 | 不要 | 不要(データが必要) |
学習コスト | 中から大 | ほぼ不要 | 小から中 | 小 |
主な効果 | 小型でも高い推論力 | VRAM が数分の1に | 推論高速化 | 出力スタイルの制御 |
実務上はこれらが競合するのではなく積み重なります。蒸留で8Bクラスの高性能モデルを作り、それを4bit量子化して端末に載せる、といった組み合わせが現実的な構成です。
実際に使われている事例
最も知られているのはDeepSeek-R1の蒸留モデル群でしょう。DeepSeek-R1が生成した80万件のサンプルでQwen2.5とLlamaをファインチューニングし、1.5Bから70Bまで6種類が公開されました。DeepSeek-R1-Distill-Qwen-32BはAIME 2024のpass@1で72.6%、7Bモデルでも55.5%を記録しています。
Qwen3は2段階の構成を採っています。まず教師の思考モードと非思考モードの出力を混ぜたオフポリシー蒸留で土台を作り、続くオンポリシー蒸留で学生自身の生成に対してロジットを揃えます。この手法は0.6Bから14Bの密なモデル5種と、MoE(Mixture of Experts)の30B-A3Bに適用されました。
導入時に確認すべき点
技術面の前に、ライセンスの確認が欠かせません。商用APIの出力を競合モデルの学習に使う行為は、多くの提供元の利用規約で明示的に禁止されています。ブラックボックス蒸留を検討する際は、まず規約を読むことから始めてください。
オープンウェイトであれば条件はかなり緩やかです。DeepSeek-R1系列はMIT licenseで公開され、蒸留を含む派生物の作成と商用利用が認められています。ただしベースモデル由来の条件は引き継がれるため、Qwen派生はApache 2.0、Llama派生はMetaのライセンスをそれぞれ確認する必要があります。
技術面では、教師のフィードバックが常に信頼できるわけではない点に注意が必要です。学生が教師の想定から大きく外れた文を生成した場合、教師の確率分布自体が較正されておらず、学習を不安定にする恐れがあるとサーベイは指摘しています。
これから解かれる課題
サーベイが挙げる未解決の論点は3つあります。1つ目は蒸留のスケーリング則で、教師サイズ、学生サイズ、データ量、そしてオンポリシー特有のロールアウト予算という4変数が品質にどう効くかを予測する枠組みがまだありません。
2つ目は先ほど触れた教師の不確実性の扱い、3つ目はエージェントレベルの蒸留です。単発の生成ではなく、ツール呼び出しを含む複数ターンの軌跡をどう蒸留するか、長い相互作用の中で貢献度をどう配分するかは手つかずの領域として残されています。小型モデルをエージェントとして動かす需要を考えると、ここが次の焦点になりそうです。


