 AI-Papers
- LLMの次トークン確率のみを活用し、ステップ単位の人手ラベルなしでプロセス報酬モデルを構築する新手法「uPRM」を提案
- ProcessBenchでLLM-as-Judgeより最大15%の絶対精度向上、多数決投票ベースラインを6.9%超上回る性能を達成
- 強化学習の報酬信号として使用すると、教師ありPRMより安定した方策最適化が可能で報酬ハッキングへの耐性も向上
研究の背景
大規模言語モデル(LLM)の推論精度を高める手法として、プロセス報酬モデル(Process Reward Model、PRM)が使われています。PRMは「最終的な答えが正しいか」だけを評価するアウトカム報酬モデルとは異なり、「各推論ステップが正しいか」を段階的に評価する仕組みです。
途中の論理ミスを早期に見つけられるため、数学・コーディング・科学的推論といった複雑な問題でモデルの性能を大きく引き上げる効果があります。
しかしPRMの学習には高いコストの壁がありました。各推論ステップに「正しい」「誤り」といったラベルを人手で付ける作業が必要で、大量のデータを用意するには膨大な専門家の労力が求められます。DeepSeek-R1やo3系列のモデルが普及してPRMへの需要は急速に高まりましたが、このアノテーションコストがスケールアップの障壁でした。
uPRMの提案手法
本研究が提案するuPRM(Unsupervised PRM)は、人手によるステップラベルも正解の検証情報も一切使わずにPRMを構築するアプローチです。核心となるのは、LLM自身の「次トークン予測確率」を活用した新しいスコアリング関数です。
具体的には、各推論ステップの後に「+」(正解)または「-」(誤り)という特殊なマーカーを挿入し、LLMがそのマーカーに割り当てる確率を読み取ります。あるステップまでの正解確率と、そのステップで初めて誤りが起きる確率を対数スケールで組み合わせることで、「どのステップが最初の誤りか」をスコアとして定量化できます。人間によるラベル付けを使わず、モデル自身の確信度から誤りを推定する点が最大の特徴です。
さらに、単一の推論軌跡だけでなく複数の軌跡をまとめてバッチ処理することで精度を高めています。複数の解答例を連結してLLMに一括入力し、文脈内学習(入力に並べた例からその場で規則を読み取る性質)の効果を使うことで、誤りステップの特定をより確実にします。ただし、この設計には問題もありました。すべての軌跡に対して同じラベルを割り当ててしまう「退化解」が生じやすいことが判明したのです。
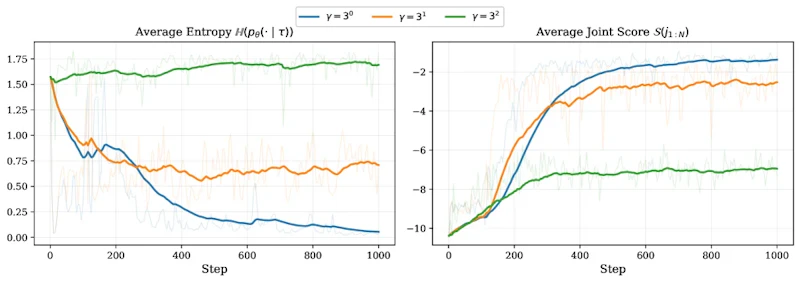
そこで研究チームは、コーナーケース(「最初のステップが誤り」または「すべてのステップが正解」という極端な予測)に対するペナルティ項を導入しました。加えて、学習目標にシャノンエントロピーの正則化項を組み込み、予測が極端に偏るのを防いでいます。正則化の強さをγ=3に設定すると、探索と精度のバランスが最も良くなることが実験で確認されました。
ProcessBenchでの実験結果
提案手法の性能は、推論ステップの誤り検出を測る標準ベンチマークであるProcessBenchで検証されました。uPRMは比較手法であるLLM-as-Judgeを最大15%の絶対精度差で上回り、最難度のデータセットであるOlympiadBenchでは13ポイント以上の改善が確認されています。
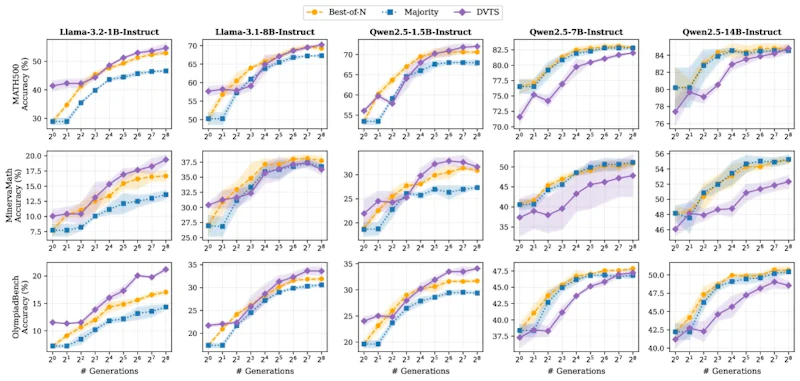
テスト時のスケーリング検証(Best-of-N選択。複数の解答候補から最も良いものを選ぶ方式)でも、ステップラベルで学習した教師ありPRM(sPRM)と同等の性能を発揮しました。人手を使わないベースラインである多数決投票と比べると、最大6.9%の精度向上です。主な比較結果は次のとおりです。
比較対象 | uPRMとの差 |
|---|---|
LLM-as-Judge(ProcessBench) | 最大15%の絶対精度向上 |
LLM-as-Judge(OlympiadBench) | 13ポイント以上の向上 |
多数決投票(Best-of-N) | 最大6.9%の精度向上 |
教師ありPRM(sPRM、Best-of-N) | 同等 |
アノテーションコストをかけずにsPRMと競合できる性能を示したことになります。DelTAのようなトークン単位の報酬配分手法と同様に、細かい粒度の報酬信号がLLMの推論改善に効くことが改めて示された形です。
強化学習への応用と安定性
uPRMは評価ツールにとどまらず、強化学習(RL)の報酬信号としても機能します。Qwen2.5シリーズのモデルを使った実験では、uPRMを報酬として使ったRL訓練が、正解ラベルで学習したsPRMよりも安定した訓練を実現しました。
Qwen2.5-Math-1.5Bモデルでは、sPRMを報酬に使った場合は訓練途中でモデルが崩壊したのに対し、uPRMでは最後まで安定した学習が続き、4%の精度向上を達成しています。教師ありPRMが陥りやすい「報酬ハッキング」(報酬信号の抜け穴を突いて意味のない高スコアを得る現象)への耐性も、uPRMのほうが高いことが確認されました。
この安定性の違いは、KLダイバージェンス(参照方策からのずれを測る指標)の推移にも明確に現れています。uPRMは訓練全体を通じて参照方策との距離を適切に保ちました。
まとめと今後の展望
uPRMはステップ単位の人手ラベルも最終回答の正誤情報も使わずに、既存の教師ありPRMと競合できる性能を達成した実用的な手法です。人手コストなしでスケールできるPRMが実現したことで、DeepSeek-R1やo3系列が示す大規模推論時代における報酬モデルの普及が現実味を帯びてきました。
一方で課題も残ります。スコアリングには基盤となるLLMの文脈長と数学推論能力が影響するため、小規模なモデルで実装する場合は、より大きなモデルで採点する設計上の工夫が必要です。また、報酬ハッキングへの耐性がなぜ高まるのかというメカニズムは完全には解明されておらず、今後の理論的な分析が待たれます。
教師なし設定でも高精度なPRMが構築できるという知見は、RL訓練の安定化や推論モデルの品質向上を目指す研究に幅広く応用できるでしょう。
論文情報: "Unsupervised Process Reward Models"(Artyom Gadetsky et al., 2026) arXiv:2605.10158
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


