 AI-Papers
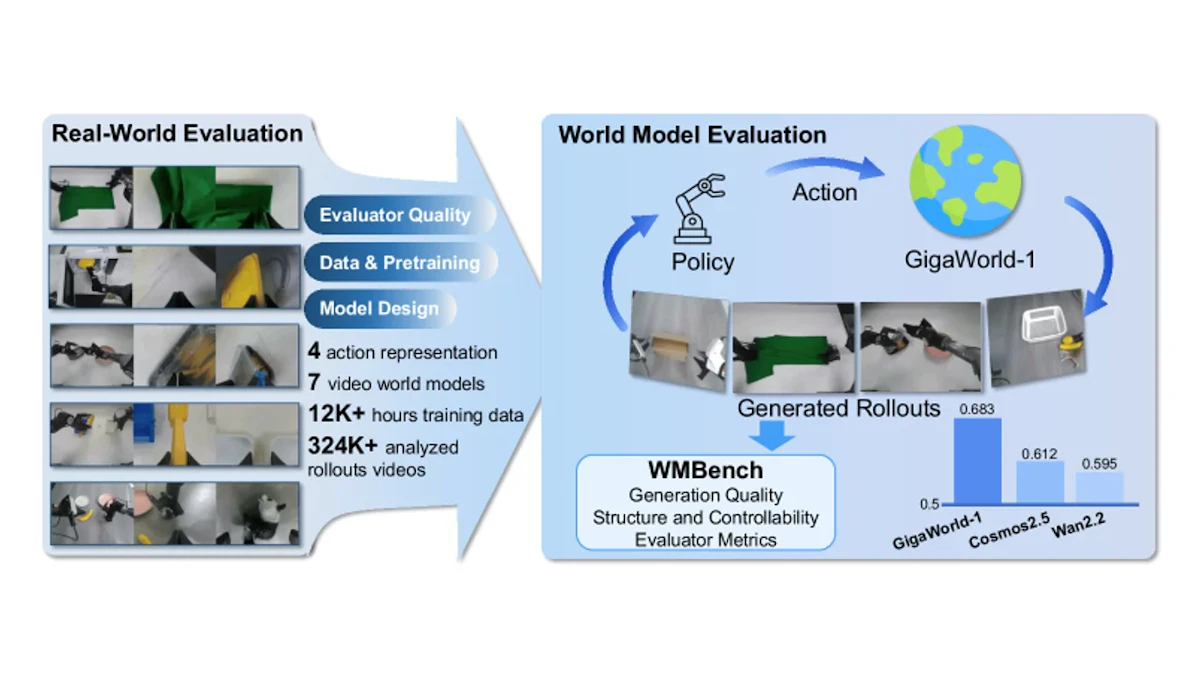
- 7種の動画世界モデルと32万件超のロールアウトを分析し、ロボットポリシー評価精度を左右する要因を特定した
- 評価品質のカギは映像のリアリズムではなく「長期的なアクション忠実度」にあることを実験で示した
- 1.2万時間超の訓練データを含むWMBenchとGigaWorld-1モデルをCVPR 2026と連動してオープン公開予定
研究の背景
大規模言語モデル(LLM)の能力評価はテキスト生成だけで完結しますが、ロボットの動作方策(ポリシー)を評価するには実機を動かして物理的な結果を確認する必要があります。実験ごとにロボットアームを稼働させ、センサーデータを収集する作業はコストも時間もかかり、研究のサイクルを大きく制限しています。
この課題を解決する手段として期待されているのが動画世界モデル(Video World Model)です。世界モデルとは現実環境をシミュレートするシステムで、ロボットがアクションを入力すると次の観測映像を予測します。実機なしで仮想的にポリシーを評価できれば、開発サイクルを大幅に短縮できます。WorldDirectorのような動画世界モデルでも長期的な動作生成は主要テーマですが、「どのような世界モデルが信頼できるポリシー評価を提供できるか」については、これまで体系的な研究がありませんでした。
WMBenchの評価手法
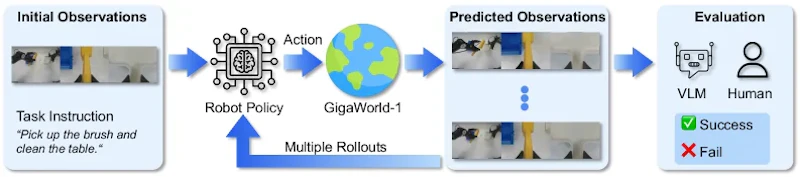
GigaWorld-1チームはこの問いに答えるため、WMBenchという評価基盤を構築しました。7種の動画世界モデル、4種のアクション表現方式、324,000件超のシミュレーションロールアウトを網羅した大規模な比較研究です。12,000時間を超えるロボット操作映像も収集されており、テレオペレーション専門家データとポリシーロールアウトデータの両方を含んでいます。
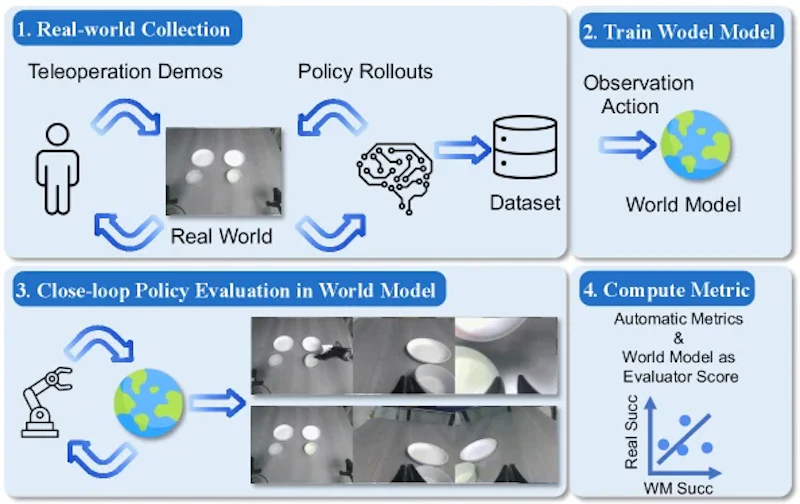
評価の中心となる指標はWMES(World Model Evaluation Score)です。世界モデル内でのロールアウトを4段階で人手評価し、実世界のポリシー成功率との相関を測定します。100チーム以上が参加したCVPR 2026のGigaBrainチャレンジで収集されたデータも分析対象に含まれており、指標とWMESの相関分析がさらに拡張されています。
評価精度を左右する要因
大規模な分析から、直感に反する重要な発見が得られました。従来は「映像のリアリズムが高いほど信頼性が高い」と考えられがちでしたが、実際には長期的なアクション忠実度こそが実世界のポリシー結果と一致するための最重要要素でした。
具体的には、Subject Consistency(被写体の一貫性、相関係数0.88)とPerspectivity(視点の整合性、0.86)が評価精度の最強の予測因子として特定されました。一方で、背景の一貫性を示す指標は評価品質と負の相関を持つことも判明しています。これは「背景が変化しない静止した映像が高評価を得ていても、実際のポリシー評価には役立たない」というトレードオフを示しており、見た目の綺麗さと評価としての有用性が必ずしも一致しないことを示しています。
事前学習については、「データ規模の大きさよりも、ロボット固有の制御可能性とのバランスが重要」という結果も得られました。広範な物理映像データとロボット特化データを組み合わせることが最適で、狭いドメインのみへの特化は過学習のリスクを高めます。アーキテクチャ面では、空間的に整列されたアクション制御インターフェース(チャネル連結方式)が最高性能を示し、軌跡精度のTrajectory Accuracyが0.1576から0.3528へと倍以上向上しています。
GigaWorld-1の設計
分析から得られた知見をもとに設計されたのがGigaWorld-1です。自己回帰型の拡散トランスフォーマー(DiT)を基盤とし、パラメータ効率の高いLoRA(Low-Rank Adaptation)で適応させた世界生成器です。
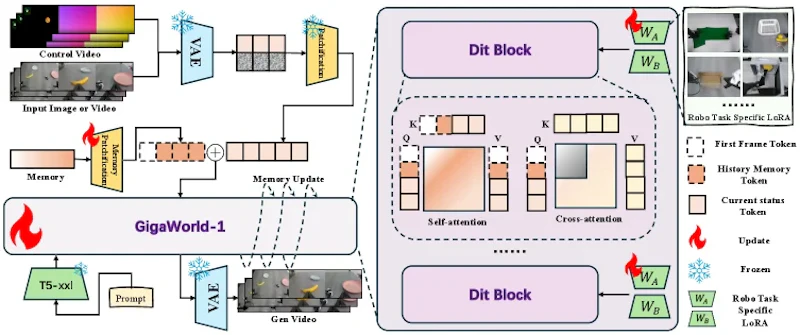
長期ロールアウトの安定性を実現する仕組みとして、階層的な履歴メモリが採用されています。第1フレームを固定アンカーとして保持しながら、短期・中期・長期の記憶層を重ね合わせることで、シーンの一貫性を維持したまま最近の動きのコンテキストを追跡します。メモリありとなしの比較実験では、画質指標のPSNRが14.46から19.82へと大幅に改善されています。
タスクの移行時に映像が不自然に切り替わる問題を解決するため、球面線形補間(Slerp)によるプロンプト遷移も導入されています。テキスト埋め込みを球面上の経路で徐々に補間することで、場面の変化をスムーズに表現できます。訓練データは合計約12,980時間にのぼり、インターネット動画、オープンソースロボットデータ(Open X、AgiBot)、自我中心的ビデオ、独自収集のヒューマノイド・デュアルアームデータから構成されています。
実験結果と公開予定
GigaWorld-1はチャレンジ参加の他モデルと比較して、タスクレベルの成功率が実世界の評価結果に近い分布を示しました。VLMベースの自動評価器(Qwen3-VLを微調整)は人手注釈との完全一致率87.80%、隣接一致率99.16%を達成し、実用的な品質保証ツールとして機能することが確認されています。
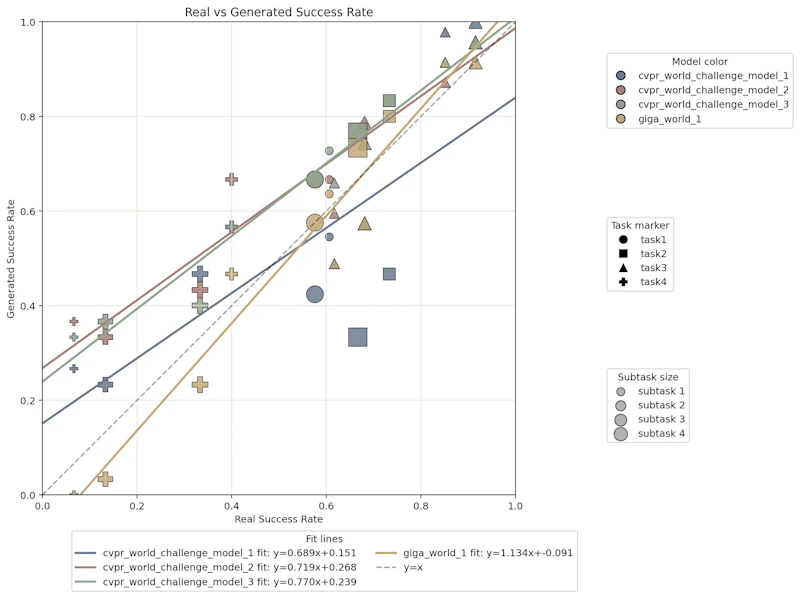
コード、モデル、データセット、評価ツールキットはすべて公開予定となっており、研究コミュニティが再現・拡張できる基盤が整えられています。なお、論文が明示している限界として、現在の評価はシミュレーション精度に依存するため、ドメインシフトが大きい環境での一般化性能はまだ検証が必要な段階です。
まとめ
GigaWorld-1が示したのは、「良い動画を生成するモデル」と「ロボット評価に使えるモデル」は必ずしも一致しないという点です。映像の美しさよりも、長期にわたってアクションを忠実に反映するロールアウト一貫性こそが評価精度を左右します。
実機実験のコストとリスクを抑えながら信頼性の高いポリシー評価を行う手段として、動画世界モデルの可能性を体系的に示したこの研究は、ロボット基盤モデルの開発を加速する実践的なロードマップとなっています。今後の課題は、世界モデル内での評価と実世界の結果のギャップをさらに縮める手法の探索です。
論文情報: "GigaWorld-1: A Roadmap to Build World Models for Robot Policy Evaluation"(GigaWorld Team et al., 2026) arXiv:2607.02642, CC BY 4.0
本記事の図(図1〜図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


