 AI-Papers
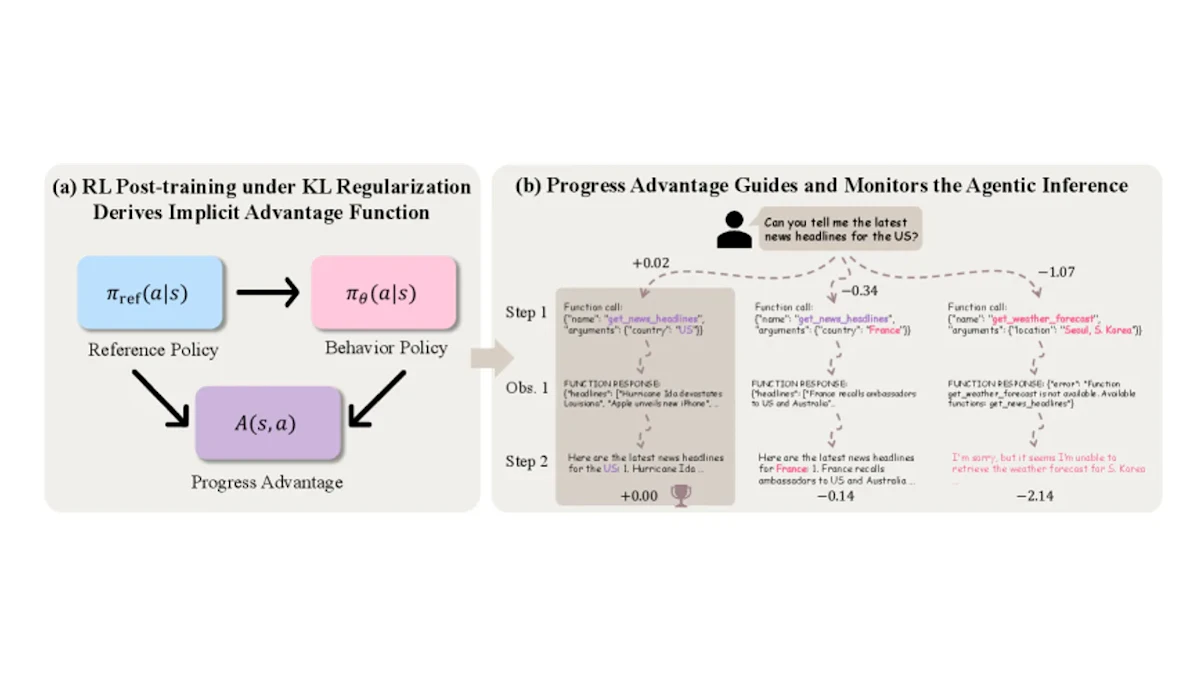
- RL後訓練の方策と参照モデルの対数確率比が、理論的に最適な優位関数と等価であることを証明
- 追加アノテーションなしで専用プロセス報酬モデルを上回る精度を5ベンチマーク・4モデルで達成
- テスト時スケーリング・不確実性定量化・失敗原因特定に即座に応用可能
プロセス報酬モデルの課題
LLMエージェント(Large Language Modelを用いた自律的なタスク実行システム)の性能向上には、各ステップの行動を評価するプロセス報酬モデル(Process Reward Model, PRM)が重要な役割を果たします。従来のPRMは、人間によるステップごとのアノテーション(正誤ラベル付け)を必要とします。そのためデータ収集コストが高く、ドメイン固有の学習も欠かせませんでした。
ウィスコンシン大学マディソン校のOhらは、この課題に対して「既存のRL後訓練パイプラインから暗黙的に得られるシグナルを活用すれば、追加コストなしで高精度なステップ評価が可能」という発見を報告しました。
理論的根拠
本研究の核心は、強化学習(Reinforcement Learning, RL)で訓練された方策モデル π と参照モデル π_ref の対数確率比が、最適な優位関数(Advantage Function)と等価になるという理論的証明です。優位関数とは、ある状態で特定の行動を取ることが平均的な行動と比べてどれだけ有利かを示す指標を指します。
研究チームは、マルコフ決定過程(行動の結果が確率的に決まる数学的枠組み)の枠組みで次の関係を導出しました。方策モデルと参照モデルの対数確率比を計算するだけで、追加の報酬モデル訓練なしに、各ステップの「進捗への寄与度」を定量化できます。この指標が Progress Advantage と名付けられています。
つまり、既にRL訓練済みのモデルペアがあれば、追加のデータ収集やモデル訓練を一切せずに、高品質なステップ評価シグナルが「無料」で手に入るのです。
5ベンチマーク・4モデルでの検証
研究チームは、3つの応用シナリオで Progress Advantage の有効性を検証しました。
まず、Best-of-N サンプリング(複数の候補から最良の軌跡を選択するテスト時スケーリング手法)では、WebShop・GAIA・HotpotQA・ALFWorld・WebArena の5つのベンチマークで評価しています。使用したのは Llama2-7B、Llama3-8B、Gemma4-4B、Qwen3.5-9B の4モデルファミリです。いずれのケースでも、自己信頼度ベースライン(モデル自身の出力確率を信頼度として使う従来手法)を上回る性能を達成しました。
次に、不確実性定量化(Uncertainty Quantification, UQ)では、τ²-bench の Airline および Retail ドメインで評価しました。性能の測定には AUROC(モデルの識別精度を0〜1で示す指標で、1に近いほど正確に成否を判別できる)を用いています。τ²-bench の Airline ドメインでの結果は次のとおりです。
モデル | AUROC(τ²-bench Airline) |
|---|---|
Gemma4-4B | 0.92 |
Qwen3.5-9B | 0.88 |
どちらも、専用訓練されたプロセス報酬モデルを上回る値でした。
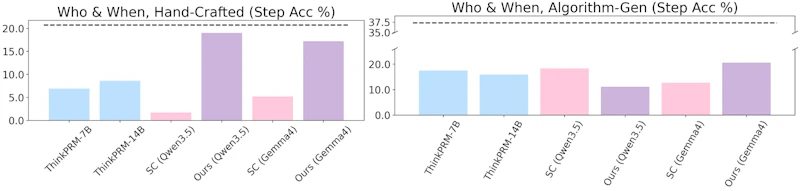
さらに、失敗原因特定(Failure Attribution)では、エージェントがいつ決定的なエラーを犯したかを特定するタスクに取り組んでいます。ここでは、タスク固有の訓練を受けた AgenTracer と同等の精度を達成しました。追加訓練なしでこの水準に達したことは、Progress Advantage の汎用性を示すものです。
即座に応用可能な実用性
Progress Advantage の最大の利点は、既存のRL訓練パイプラインにそのまま組み込める点にあります。方策モデルと参照モデルの対数確率比を計算するだけなので、新たなデータ収集やモデル訓練のコストが発生しません。
用途ごとの使い方は次のとおりです。
- テスト時スケーリング: 複数の候補軌跡を生成し、Progress Advantage でスコアリングして最良のものを選択する
- 不確実性定量化: モデルの予測の信頼度を定量的に評価し、重要な意思決定の場面で人間の介入を促すトリガーにする
- 失敗原因特定: エージェントのデバッグや改善に役立つ診断情報を得る
いずれも、同じ対数確率比から得られるシグナルを使い回せます。
LLMを組み合わせても限界がある:67モデル実験で判明した「共同失敗上限」の法則でも示されたように、エージェントの失敗パターンを理解することは性能向上の鍵です。Progress Advantage は、そのための手段の1つになります。
集約戦略の重要性
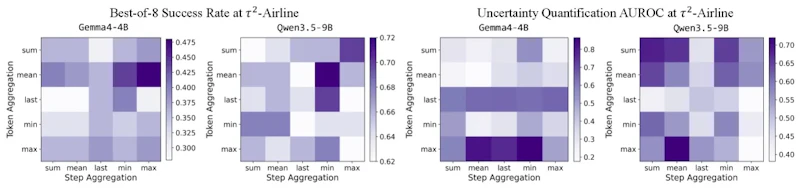
研究では、トークンレベルおよびステップレベルでの集約戦略(平均・最大・最小・最後のトークンなど)が性能に大きく影響することも明らかになりました。タスクやモデルによって最適な集約方法が異なるため、実際の応用では複数の戦略を試す価値があります。
例えば、Airlineドメインでは最大値集約が、Retailドメインでは最小値集約が効果的でした。この柔軟性により、Progress Advantage は多様なタスクに適応できます。
まとめと今後の展望
本研究は、RL後訓練の「副産物」として得られるシグナルが、専用モデルに匹敵する評価性能を持つことを理論と実験の両面から示しました。追加コストなしで高品質なステップ評価ができれば、LLMエージェントの開発・デバッグ・デプロイはより効率的になります。
今後は、より複雑なマルチモーダルエージェントや長期的なタスクへの応用、参照モデルの選択方法の最適化などが研究課題となるでしょう。既存のRL訓練パイプラインを持つ組織であれば、Progress Advantage はすぐに試せる手法です。
論文情報: "Neglected Free Lunch from Post-training: Progress Advantage for LLM Agents"(Changdae Oh et al., 2026) arXiv:2606.26080, CC BY 4.0
本記事の図とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


