 AI-Papers
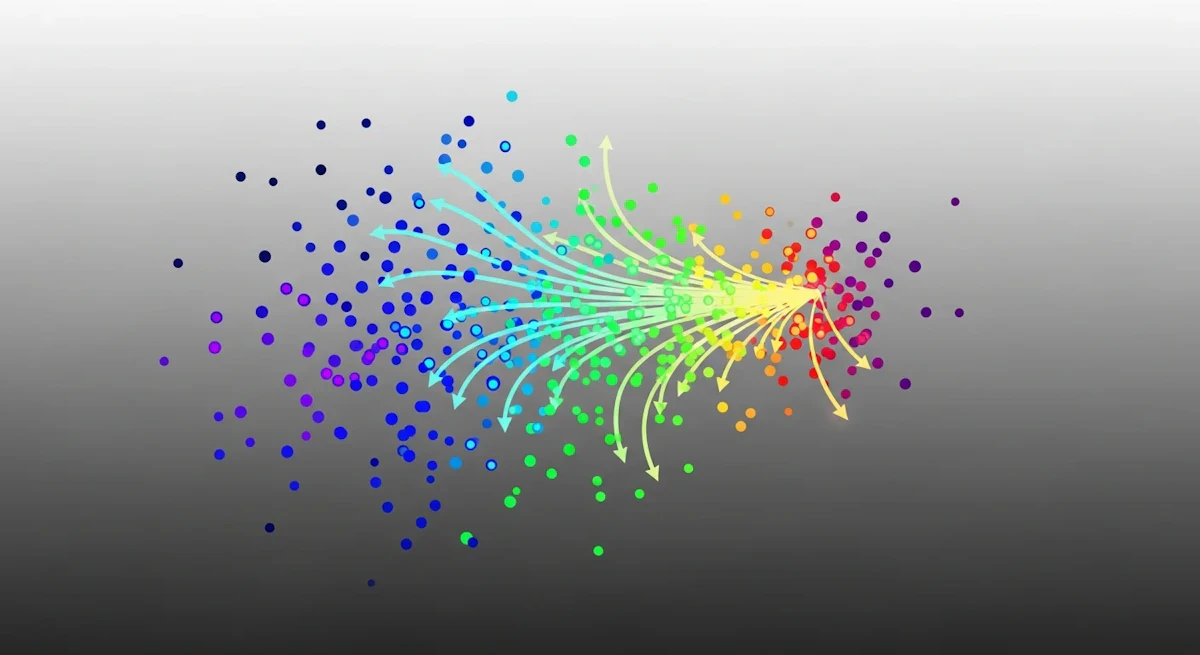
- PRM(プロセス報酬モデル)を粒子フィルタリング的に活用し、推論ステップ単位で候補解の集団を逐次洗練するアルゴリズム「PRISM」を提案
- gpt-oss-20bでAIME25 90.0%・GPQA Diamond 71.4%を達成し、約6倍大きなgpt-oss-120bと同等以上の性能を実現
- クローン上限付き再サンプリングと確率的受理が、多数決依存の誤り増幅を防いで正解少数解を救出する設計の鍵となる
研究の背景
大規模言語モデル(LLM)の推論精度を高めるアプローチとして、複数の候補解を生成して繰り返し洗練するDeepThink系の手法が注目されています。しかし既存手法には根本的な限界がありました。
候補解を多数決で評価すると、誤った推論パターンが多数派を占めた場合に正解を含む少数解が抑圧されてしまいます。また推論を深めるほど誤りが蓄積するという問題も残っていました。
推論モデルの仕組みと課題については別記事でも詳しく解説していますが、本研究はこの「多数決の罠」に正面から取り組みます。単純な多数決ではGPQA Diamondで65.8%が上限となり、多くの洗練手法がこの水準を超えられないことが実験で明らかになっています。
PRISMの提案手法
PRISM(Process Reward Model-Guided Inference)は、候補解の集団を物理学の粒子として捉え、PRMが出すステップ単位のスコアをエネルギー関数として集団を誘導するアルゴリズムです。確率論的な粒子フィルタリングの枠組みをLLM推論に応用した点が新しい切り口となっています。
アルゴリズムは3段階で構成されます。
- スコアリングと重み付け: PRMが各候補解の品質を評価し、重みを
w(τ) ∝ s(τ)^(1/T_smc)の形式で計算する - 有効サンプルサイズ(ESS)の監視と再サンプリング: 集団の確率質量が偏った状態を検知し、高スコア解を複製して低スコア解を除去する
- クローン上限付きの確率的洗練: 複製の割合を抑えつつ、確率的に改善案を受け入れて多様性を保つ
それぞれの段階を順に見ていきます。
重み付けの温度パラメータ T_smc は、探索と活用のバランスを制御します。これにより候補解の集団がボルツマン分布的な確率割り当てを持つ形になります。
ESS(集団の実質的な多様性を測る指標)の監視では、確率質量が特定の候補に過度に集中するとESSが閾値を下回ります。これを検知したときに再サンプリングを実施し、計算資源を有望な推論軌跡に集中させます。
3段階目の確率的洗練には2つの工夫があります。再サンプリングだけでは複製が集団の30%超を占める「クローン崩壊」が生じ、解の多様性が失われます。これを防ぐため複製数を集団の約30%以内に制限するClone Cappingを導入しました。
さらにMetropolis-Hastings法的な確率的受理を採用し、スコアが若干低い改善案も10〜18%の確率で受け入れることで解の多様性を維持します。この確率的な受理が、集団が局所解に固まることなく正解方向へ漸進的に収束する仕組みの中核を担います。
実験結果
PRISMの有効性はgpt-oss-20bを用いた評価で示されています。数学オリンピック系の難問集AIME25では90.0%を記録し、同条件での再帰的自己集約(87.8%)を上回りました。科学推論の難問集GPQA DiamondとHMMT25を含む結果は次のとおりです。
ベンチマーク | PRISM(gpt-oss-20b) | 比較対象 |
|---|---|---|
AIME25 | 90.0% | 87.8%(再帰的自己集約) |
GPQA Diamond | 71.4% | 65.8%(単純な多数決の上限) |
HMMT25 | 75.4% | - |
集団精度の推移を分析すると、基準手法では精度が振動するのに対し、PRISMは安定した上昇傾向を示します。誤りから正解への転換と正解から誤りへの後退の差分を測るNetFlip指標でも、PRISMは大きな正値を示しており、ランダムな更新でなく方向性ある誤り修正が機能していることが確認されました。
初期集団に正解がほとんど含まれない低正答率の状況でも、多数決依存の手法より50ポイント以上高い精度を維持するロバスト性も実証されています。
これらの成績は、約6倍のパラメータ数を持つgpt-oss-120bと同等以上の水準です。トークン消費量と精度のパレートフロンティア分析でも、PRISMは競合手法より効率的に精度向上を実現することが示されており、計算コストの観点でも実用上の優位性があります。
まとめと今後の展望
PRISMは、プロセス報酬モデルを推論時アルゴリズムとして積極的に活用するという新しい切り口を示しました。粒子フィルタリングの考え方をLLM推論に持ち込み、ESS監視・クローン上限・確率的受理という3つの機構を組み合わせることで、集団の多様性を保ちながら正解方向へ誘導する仕組みを実現しています。
今後の課題としては、PRMの品質がアルゴリズム全体の性能を左右する点が挙げられます。PRMが誤ったシグナルを出せば集団全体が誤った方向へ洗練されるリスクがあります。
また温度パラメータやクローン上限の最適値がタスクやドメインによって異なる可能性があり、汎化性の検証が今後必要となるでしょう。PRM技術そのものの発展と組み合わせることで、さらなる推論精度の向上が期待されます。


