 AI-Papers
- 拡散言語モデル(DLM)の並列デコードで複数マスク領域のキャプションを一括生成し、スループット3.44倍を達成
- 新ベンチマークParaDLC-Benchで62.4%のスコアを記録、既存のDLMベースVLMが示す35.2%を大きく超える
- 5.7Mキャプション規模のデータセットParaCaption-5.7MとコードをGitHubで公開しており、再現性が高い
研究の背景と課題
画像内の特定領域に対してテキスト説明を生成する「領域キャプション生成」は、ロボットビジョン・医療画像解析・自動運転など幅広い分野で求められる技術です。従来のマルチモーダル大規模言語モデル(MLLM)は自己回帰(AR)方式を採用しており、トークンを1つずつ順番に生成する仕組みです。
この方式の問題点は、1枚の画像に複数のマスク領域が指定された場合に顕著に現れます。領域を逐次処理するため、推論コストが領域数に比例して線形増加するのです。たとえば4つの領域を処理するなら、単純に4倍の時間がかかります。リアルタイム性が求められる場面では、このボトルネックは深刻でしょう。
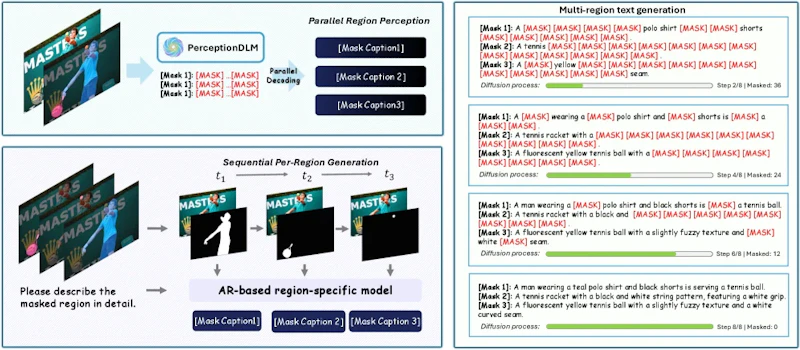
一方、近年注目を集める拡散言語モデル(Diffusion Language Model、DLM)は、ノイズからトークン列を復元するマスク拡散プロセスで文章を生成します。DLMの核心的な特性は「並列デコード」であり、複数のトークンを同時に生成できます。
ByteDanceと北京大学らが提案するPerceptionDLMは、この特性を複数領域の同時キャプション生成に応用した研究です。
3つの新機構で実現する並列処理
PerceptionDLMは、視覚エンコーダ(SigLIP-2)、2層の軽量コネクタ、そして拡散言語モデル(LLaDA-8B)の3要素で構成されます。複数マスクを同時処理するために、以下の3つの機構を新たに導入しています。
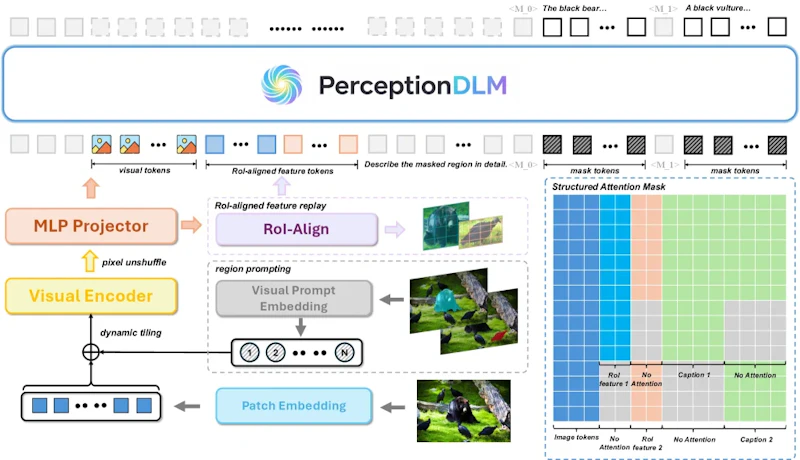
- Region Prompting: 各マスク領域に学習可能な埋め込みベクトルを関連付け、領域固有の視覚プロンプトとして機能させる
- RoI-aligned Feature Replay(関心領域特徴の再利用): マスク領域内の局所的な視覚特徴を直接抽出し、言語埋め込み空間に投影してプレースホルダートークンとして挿入する
- 構造化Attention Masking: 各領域のトークンが自分の領域のRoI特徴とグローバル視覚情報にのみ注目し、他の領域のトークンは参照しないよう制限する
Region Promptingにより、モデルは「どのトークン列がどの領域の説明か」を厳密に区別できます。RoI-aligned Feature Replayは全体画像の特徴だけに頼らず、対象領域の細部を別途補強することで精度の向上を図る狙いです。構造化Attention Maskingは、領域間の干渉、つまりある領域の記述に別の領域の特徴が混入する問題を根本から抑制します。これが並列生成において品質を保つ要となっています。
なお、基盤モデルとなるPerceptionDLM-Baseは、アライメント学習、大規模中間学習、指示チューニング、高品質SFTの4段階で訓練されています。単独でも16の一般ベンチマーク中15でLLaDA-Vを上回る性能を示し、強固な出発点となっています。
新ベンチマークとデータセット
複数マスク環境での評価に特化した既存のベンチマークが存在しなかったため、研究チームはParaDLC-Bench(並列詳細局所キャプションベンチマーク)を新規構築しました。100枚の画像と2,345問の検証済み質問から成り、キャプション品質と推論効率の両面を測定します。
採点方式も工夫されており、正確な属性の記述は加点、事実誤りは減点、誤った領域への説明(誤位置化)と幻覚は厳しく減点します。精度だけを追ってハルシネーション(事実と異なる内容の生成)を起こすモデルが有利にならない設計です。
学習データとして公開されたParaCaption-5.7Mは、SA-1Bの234万マスク(83,000枚)とCOCONutの340万マスク(334,000枚)を合わせた大規模データセットです。GAR-8Bで初期キャプションを生成しLLMで品質を検証するパイプラインで構築されており、既存の領域キャプションデータセットを規模で大きく上回ります。
実験結果と比較
ParaDLC-BenchではPerceptionDLMが62.4%のスコアを達成しました。比較対象の既存DLMベースVLMが35.2%にとどまる中、大幅な改善です。ARベースの代表モデルDAM-8BとGAR-8Bは精度面では上回りますが、これらは領域を逐次処理するため複数領域の処理時間が増加します。主要な数値を整理すると次の通りです。
モデル | ParaDLC-Bench スコア | ベンチマーク処理時間 |
|---|---|---|
PerceptionDLM | 62.4% | 276秒 |
GAR-8B(AR) | 72.2% | 479秒 |
DAM-8B(AR) | 71.1% | - |
既存DLMベースVLM | 35.2% | - |
推論効率の面では、4マスクを処理する際にスループット3.44倍を実現しています(処理時間10.04秒から2.92秒へ短縮)。自己回帰型の推論高速化手法とは根本的に異なるアプローチで、マスク数が増えるほど恩恵が大きくなる点もポイントです。図1(b)が示すように、マスク数に対してスループットがほぼ線形に向上するため、大量領域を扱う用途ほど速度優位が拡大します。
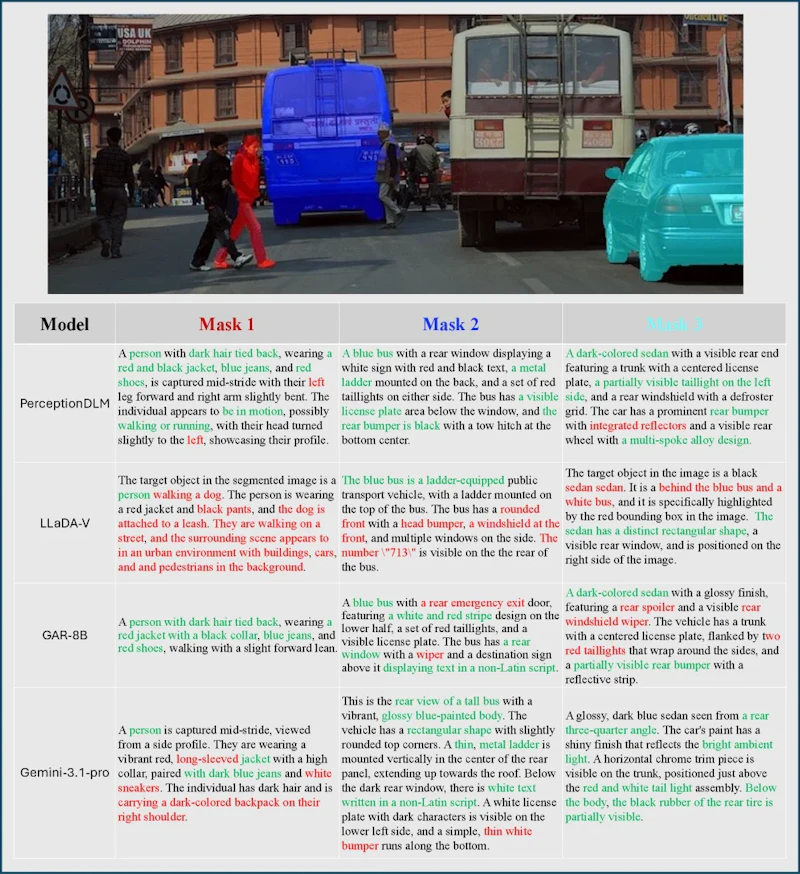
定性的な比較(図6)では、既存手法で目立つ領域間干渉、たとえば「隣の領域の属性が混入して誤った記述が生成される」問題を、PerceptionDLMが構造化Attention Maskingで効果的に抑制していることが確認されています。
まとめ
PerceptionDLMは、拡散言語モデルの並列デコード特性を複数領域の同時キャプション生成に応用した研究です。Region Prompting、RoI-aligned Feature Replay、構造化Attention Maskingの3機構を組み合わせることで、領域間干渉を抑えながら高品質なキャプションを並列生成できます。
現状ではARモデルに精度面での差があります。しかし、スループット3.44倍という実測値は、DLMが実用アプリケーションに近づきつつあることを示しています。
ParaDLC-BenchとParaCaption-5.7Mというインフラも同時に整備されたことで、後続研究が取り組みやすい環境が整いました。コードも公開されているため、DLMを活用したマルチモーダル認識がどこまで精度を伸ばせるかが次の焦点となります。
論文情報: "PerceptionDLM: Parallel Region Perception with Multimodal Diffusion Language Models"(Yueyi Sun et al., 2026) arXiv:2606.19534
本記事の図(図1、図2、図6)は解説のため上記論文より引用しています。


