 AI-Papers
- HuggingFace PEFTチームがLoRA・OFT・GraLoRAなど6手法を実測比較し、OFTが画像生成タスクでLoRAを精度・VRAM効率ともに上回ることを確認した
- 数学推論タスクではLoRAにランク安定化を加えるだけで正答率が48.1%から53.2%に上昇し、手法の細かな設定が精度に大きく影響することが示された
- GraLoRAはLoRA形式への変換に対応しており、既存ワークフローとの互換性を保ちながら異なる最適化アプローチを活用できる
なぜLoRAだけでは不十分なのか
Parameter-Efficient Fine-Tuning(PEFT)とは、モデル全体を再学習せず少数のパラメータだけを更新してモデルをカスタマイズする技術群の総称です。なかでもLoRA(Low-Rank Adaptation)は、導入の手軽さとライブラリサポートの充実から事実上のデファクトスタンダードとなっています。
しかし「とりあえずLoRAを使う」という選択が本当に最善かどうかは、これまであまり体系的に検証されてきませんでした。HuggingFaceのPEFTチームは公式ブログで、6つのPEFT手法を2種類のベンチマークで実測し、その結果を公開しました。タスクによってはLoRA以外の手法がより優れた選択肢になり得ることを、具体的な数値で示しています。
比較対象の6手法
今回の実測に含まれる手法は以下の6つです。
- LoRA: 重み行列に低ランク行列の積を追加する最も普及した手法
- OFT(Orthogonal Fine-Tuning): 直交変換を利用してニューロン間の関係を保ちながら重みを更新する手法
- GraLoRA: 勾配情報を活用し、LoRA形式への変換にも対応する手法
- Lily: 精度を重視した設計で、メモリ消費はやや大きい
- BEFT: メモリ効率を優先した設計の手法
- LoRA-FA: LoRAのメモリ最適化バリアントで、一方の低ランク行列を固定して学習する
いずれもHuggingFace PEFTライブラリのAPIから同一のコードパターンで利用でき、手法の切り替えは設定を1行変えるだけで行えます。
画像生成ベンチマークの結果
画像生成の実験では、FLUX.1-kleinをベースモデルとして使用し、猫のぬいぐるみ画像を題材にDreamBooth(少数枚の参照画像から被写体の特徴を学習する手法)形式で各手法をファインチューニングしました。評価指標にはDINO類似度(画像間の視覚的特徴の一致度を示す指標で、1に近いほど元画像に忠実)とVRAM使用量を用いています。
LoRAのDINO類似度は0.697、VRAM使用量は9.97GBでした。これに対してOFTはDINO類似度0.708、VRAM使用量9.01GBと、精度・メモリ効率の両面でLoRAを上回りました。単一手法が精度とメモリ効率を同時に改善することは珍しく、OFTの直交変換という設計が画像生成タスクの特性と相性がよい可能性を示す結果です。
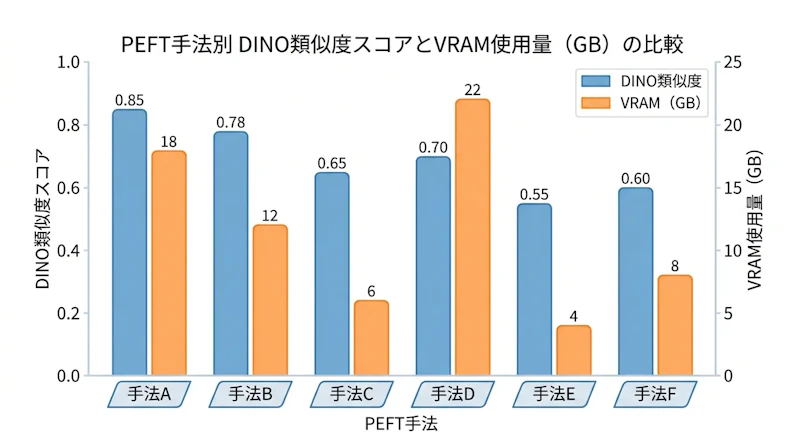
Lily(DINO類似度0.714)はOFTを上回る精度を達成していますが、VRAM使用量は25.6GBと大幅に増加します。精度を最優先する場合はLily、精度と効率のバランスを重視するならOFTが有力な選択肢となるでしょう。
数学推論ベンチマークの結果
数学推論タスクでは、Llama-3.2-3Bを数学推論ベンチマークデータセットのMetaMathQA(学校から競技数学まで段階的な難易度の問題を含むデータセット)でファインチューニングし、数学的問題への正答率で評価しました。
標準的なLoRAの正答率は48.1%(VRAM 22.5GB)でした。一方、LoRAにランク安定化(rank stabilization)を加えるだけで正答率は53.2%に上昇し、VRAM消費はほぼ同じ22.6GBに留まりました。最高精度はLilyの54.9%ですが、VRAM消費は25.6GBに増えます。メモリ効率を優先してLoRA-FAを選択した場合は20.2GBまで削減できますが、正答率は大きく低下します。
この結果が示すのは、同じLoRAでも設定の違いだけで精度に5ポイント以上の差が生じ得るという事実です。手法の選択だけでなく、ランク安定化のようなハイパーパラメータ設計も実測で確かめる価値があります。また、HuggingFaceが公開した別の評価フレームワーク「agent-eval」と組み合わせることで、タスク特性に合った手法の絞り込みをより体系的に行えるでしょう。
手法選択の実践的指針
PEFTチームが示す推奨は明確です。使用できるVRAMの上限、求める精度の水準、タスクの種類(画像生成か言語タスクか)を整理したうえで、候補となる複数の手法を実測することが重要です。HuggingFace PEFTライブラリではAPIが統一されているため、設定を1行変えるだけで手法を切り替えられるコストの低さがあります。
GraLoRAはLoRA形式への変換に対応しており、学習後に変換してLoRA対応ツールとの互換性を確保できる点も実務上の利点です。「とりあえずLoRA」を見直すコストは低く、数時間の追加実験がモデルの品質とインフラコストの双方に影響を与える可能性があります。


