 AI-Papers
- 外部ビジョンエンコーダとアダプタを完全に排除し、ピクセルとテキストの対応をエンドツーエンドで学習するネイティブアーキテクチャを提案
- 空間・時間位置をT/H/W次元で統一的にエンコードするNative RoPE(NRoPE)により、単一モデルで1枚画像・複数画像・動画を横断処理
- 8Bモデルが空間知能ベンチマーク(MindCube)で90.0を達成し、モジュラー手法(85.7)を上回る性能を実証
研究の背景
視覚言語モデル(VLM)の主流設計は、CLIPやSigLIPなどの事前学習済みビジョンエンコーダと言語モデルを組み合わせる「モジュラー構成」です。この構成はベンチマーク性能に優れる一方、視覚側と言語側が独立したコンポーネントとして存在するため、両者の特徴表現を同一の目的関数で一貫して最適化しにくいという構造的な制約を抱えます。
特にマルチ画像や動画の時空間推論では、外部エンコーダが静止画向けに設計されていることが足かせになりやすく、空間的・時間的な文脈をまたぐ細粒度の認識が苦手な場面があります。NEO-ovはこの課題に正面から向き合い、あらゆる外部モジュールを排除したネイティブなマルチモーダルアーキテクチャを提案しました。
NEO-ovのアーキテクチャ
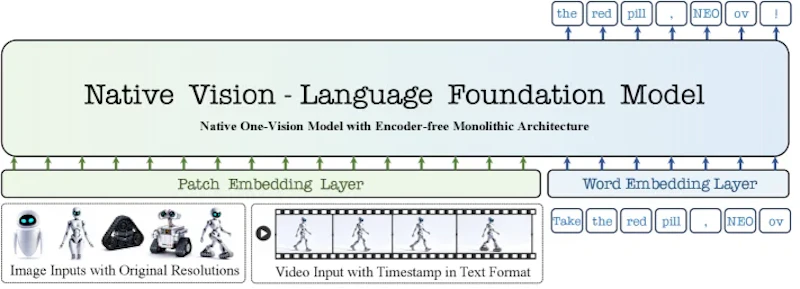
NEO-ovのアーキテクチャは、次の3つの要素で構成されます。
- パッチ埋め込み層: 画像をストライド16の畳み込みで視覚トークンに変換する
- Pre-Buffer: 視覚トークンを言語バックボーンに渡す前に前処理するTransformerブロック群
- デコーダのみの単一バックボーン: 視覚トークンとテキストトークンを統合的に処理する
外部のビジョンエンコーダやアダプタはどこにも登場せず、ピクセルの入力から言語の出力までを1つの学習対象としてつなぎます。
Pre-Bufferの層数はモデルサイズによって異なり、2Bモデル(Qwen3-1.7Bバックボーン使用)では12層、8Bモデル(Qwen3-8Bバックボーン使用)では6層です。
これは設計上の意図によるもので、より小さなバックボーンを持つ2Bモデルは視覚特徴の変換に多くの前処理層を必要とします。一方、8Bモデルは大きく表現力豊かなバックボーンを持つため、少ない前処理層でも十分な視覚表現が構築できます。
Native RoPEによる時空間統合
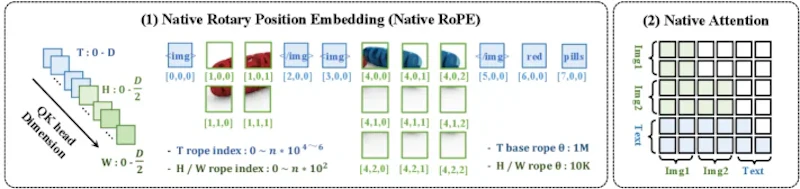
位置情報の表現に使われる「Native Rotary Position Embeddings(NRoPE)」は、トークンの並び順を回転で表すテキスト専用RoPEを、時間(T)・高さ(H)・幅(W)の3次元に拡張したものです。テキストトークンにはH=0・W=0が割り当てられ、画像・動画トークンは共有の時間インデックス内でH・Wにより空間位置をエンコードします。1つの位置エンコーディング体系がテキストと視覚の両方を統一的に扱えるようになります。
Attentionの設計にも工夫があり、画像内では双方向Attention、テキストや動画フレーム間では因果的(左から右への)Attentionを使い分ける統合Attentionマスクを採用しました。1枚画像の空間推論、複数画像の比較理解、動画の時系列認識がすべて同一モデル内で処理できるのは、このNRoPEと統合Attentionマスクの組み合わせによるものです。
3段階の学習レシピ
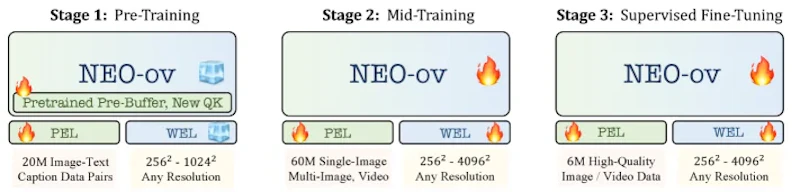
NEO-ovの学習は3段階で行われます。第1段階(アライメント)では約2000万件の画像テキストペアを使い、Pre-Bufferとバックボーンを対応づけながら、Qwen3から引き継いだ言語能力を維持したまま視覚認識の基礎を構築します。
第2段階では約6000万件の多様な画像・動画データで空間時間推論を強化し、第3段階では約600万件の高品質な指示チューニングデータで細粒度の視覚認識と時間的ダイナミクスの理解を仕上げます。段階的にデータの難度と多様性を高めることで、ピクセルから直接学習する不安定さを抑えつつ、安定した収束につなげました。
実験結果と性能比較
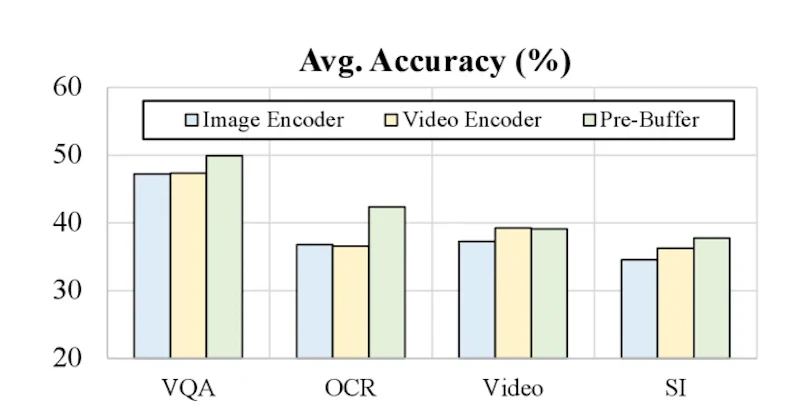
8Bモデル(Qwen3-8Bバックボーン)の主要ベンチマーク結果を以下に示します。
ベンチマーク | NEO-ov(8B) | 比較モジュラーモデル |
|---|---|---|
MMBench | 67.8 | InternVL3.5: 69.3 |
VideoMME | 67.4 | Qwen3-VL: 71.4 |
MindCube(空間知能) | 90.0 | SenseNova-SI: 85.7 |
DocVQA | 78.5 | 比較なし |
空間知能ベンチマーク(MindCube)ではモジュラー手法を上回る90.0を達成しており、時空間的な視覚推論でネイティブ設計の優位性が現れました。MMBenchやVideoMMEでもモジュラー手法との差は数ポイント以内に収まり、「エンコーダなしでは性能が出ない」という前提を覆す結果です。
ただし、LLaVA-OneVision-2のような動画特化モジュラーモデルと比べると、文字を読み取るOCRを多用するドキュメント理解タスクでは依然として差があります。この点は論文内でも正直に記載され、今後の改善課題として示されています。
まとめと今後の展望
NEO-ovは、大規模な実証を通じて「ネイティブ設計でも競争力のある性能が達成できる」ことを示した研究です。2BモデルではPre-Bufferを12層と多めに設けて小さなバックボーンを補い、8BモデルではPre-Bufferを6層に絞りつつ強力なQwen3-8Bバックボーンで性能を確保するという、サイズに応じた設計の最適化が行われました。
現時点ではOCR集約的なタスクで事前学習済みエンコーダを持つモジュラー手法に及ばない場面があります。とはいえ、エンドツーエンドの学習設計はパラメータの共有最適化や将来的なスケールアップに有利に働く可能性があります。
コードと学習済みモデルはGitHubで公開されており、マルチモーダル基盤モデルのアーキテクチャ設計を見直すための出発点になる研究です。
論文情報: "From Pixels to Words -- Towards Native One-Vision Models at Scale"(Haiwen Diao et al., 2026) arXiv:2605.28820
本記事の図(図1〜図4)は解説のため上記論文より引用しています。


