 AI-Papers
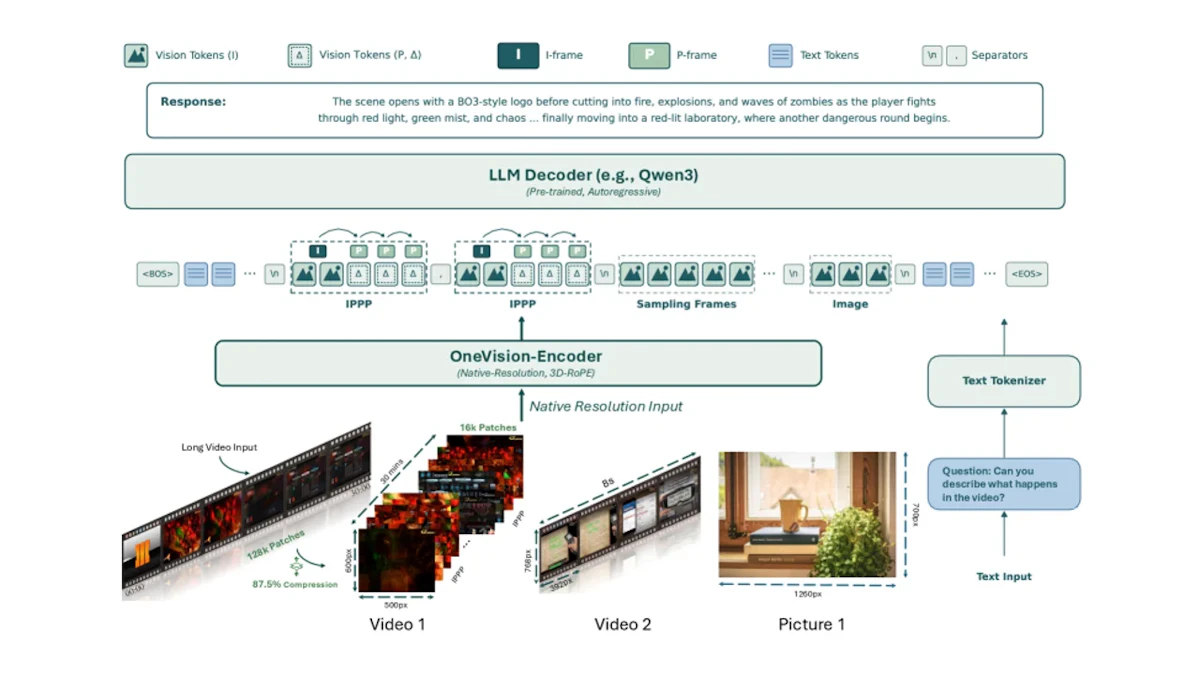
- 圧縮動画をデコードせずビットコストストリームとして直接入力する「codec-stream tokenization」を動画LLMに初めて導入した
- 独自ベンチマーク「JumpScore」でQwen3-VL-8Bの30.1に対して74.9を達成し、+44.8ポイントの大差をつけた
- 動画タスク+4.3・空間推論+5.3・追跡+15.6ポイントを同時達成し、H.264/H.265など既存コーデックを活かした低コスト動画理解を実現した
研究の背景
動画を理解するマルチモーダルLLM(大規模言語モデル)の主流アプローチは、動画から等間隔にフレームを抜き出してトークン化する「フレームサンプリング」でした。しかし、この方法には根本的な限界があります。フレームを均等に間引くと、動きが激しい場面では重要な変化を見落とし、静止した場面では似たフレームが重複する無駄が生じます。
動画ファイルはH.264やH.265などのコーデック(動画の圧縮・伸張を担う規格)によって、もともと「どこが動いているか」という情報を持った構造で保存されています。コーデックは変化の大きい場面に多くのビット数を割り当てるため、ビット量の分布を見るだけで「動きが多い区間」を精度よく検出できます。LLaVA-OneVision-2はこの点に着目し、動画をデコード(元の映像に戻す)することなく、圧縮されたデータストリームのままモデルへ入力するcodec-stream tokenization(コーデックストリームトークン化)を提案しました。
codec-stream tokenizationの仕組み
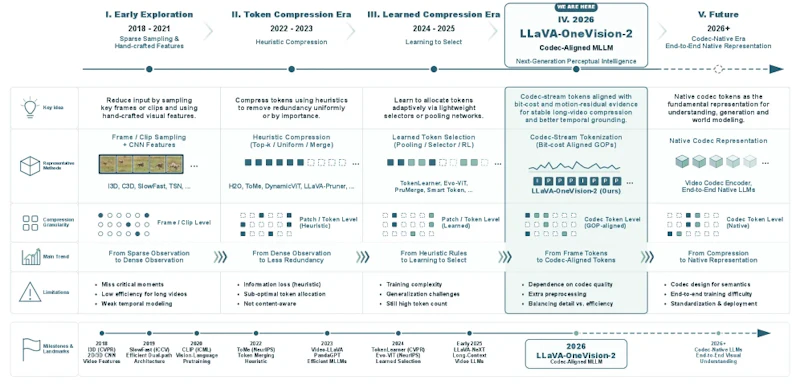
従来のフレームサンプリングとの最大の違いは、「どこを見るか」を映像の内容に応じて動的に決める点です。具体的には3つのステップで動作します。
- 適応的GOP分割: GOP(Group of Pictures、映像の処理単位)の境界をビットコストの累積値で決める。累積コストが閾値に達すると新しいグループを開始するため、動きが多い区間には短いGOPが、静止場面には長いGOPが割り当てられる
- 空間的顕著性のスコアリング: 各GOP内で動きの大きさとルマ残差(輝度成分のフレーム間差分)から2×2パッチブロック単位のスコアを計算し、重要な領域だけを抽出する
- I/Pキャンバスの構築: 各GOPのキーフレームを「Iキャンバス」、選択されたパッチを「Pキャンバス」として格納し、コンパクトな視覚トークンを生成する
この設計により、均一なフレームサンプリングでは検出しにくかった「急な動き」「カット転換」「微細な繰り返し動作」を高精度で捉えられます。WorldKVのようなKVキャッシュ効率化とは異なり、入力表現そのものをコーデック構造に合わせる点が本手法の特徴です。
モデルアーキテクチャ
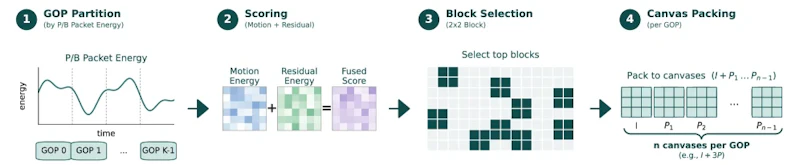
LLaVA-OneVision-2は、3種類の入力を統一インタフェースで扱えるアーキテクチャを採用しています。コーデックストリーム動画はI/Pキャンバスとして視覚トークン化され、フレームサンプリング動画は従来のフレームトークン列として処理され、静止画像はネイティブ解像度を保った空間トークンとして処理されます。
これら3つはすべてOneVision-Encoder(窓付きAttentionでネイティブ解像度を維持するビジョンエンコーダ)を経由します。得られた視覚埋め込みはテキストトークンと結合され、事前学習済みの自己回帰型言語モデルでデコードされます。空間座標と時間座標を統一した3D RoPE(相対位置エンコーディング)を採用することで、動画と画像を一つの座標系に収めており、単一のアーキテクチャで動画・画像の両タスクを処理できます。
JumpScoreベンチマーク
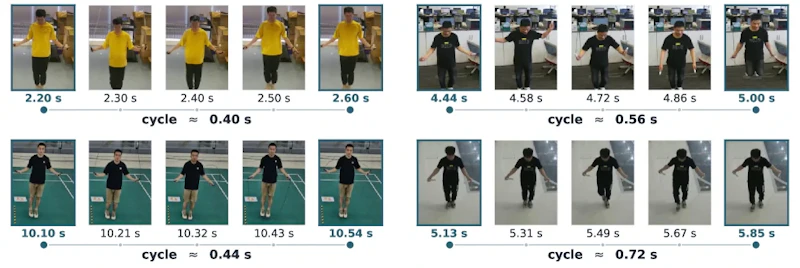
本研究は、既存の動画ベンチマークが「高頻度で繰り返す微細な動作の時間的定位」を評価できていないという課題を指摘し、JumpScoreという新ベンチマークを提案しました。縄跳びの映像189本を使用し、ロープが脚の後ろを通過するタイミング(サイクル開始点)を小数点以下1桁の精度でアノテーションしたデータセットです。
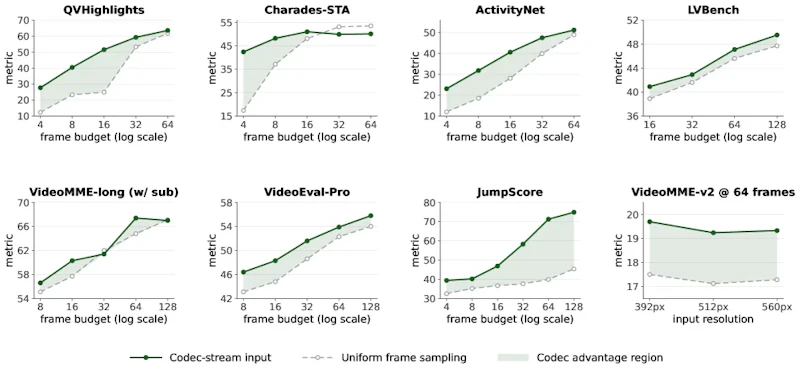
予測と正解のタイミングの一致度を、0.1秒・0.2秒・0.3秒のトレランス窓でmAP(平均適合率)として測定します。このベンチマークはフレームサンプリングの弱点を正確に突いており、均一128フレームサンプリングではmIoU 0.116にとどまるのに対し、codec-streamサンプリングは同じ視覚トークン予算でmIoU 0.894を達成しています。
実験結果
LLaVA-OneVision-2-8B(8Bパラメータ)をQwen3-VL-8Bと比較した主要な結果は以下のとおりです。
評価カテゴリ | LLaVA-OV-2-8B | Qwen3-VL-8B | 差分 |
|---|---|---|---|
JumpScore | 74.9 | 30.1 | +44.8 |
動画タスク(18タスク平均) | 62.5 | 58.2 | +4.3 |
空間推論(11タスク平均) | 63.5 | 58.2 | +5.3 |
追跡(J&F) | 48.0 | 32.4 | +15.6 |
時間的グラウンディング平均 | 45.2 | 35.5 | +9.7 |
codec-streamとフレームサンプリングを同一の視覚トークン設定で比較した実験では、時間的グラウンディングで+9.7ポイントの改善が確認されました。一方、フレームサンプリングが有利なタスクも存在しており、動きの少ない静的なシーン理解ではフレームサンプリングの方が高いスコアを示す場合もあります。
まとめと今後の展望
LLaVA-OneVision-2が提示した「圧縮映像の構造をそのまま活用する」というアプローチは、動画LLMの効率化に新しい方向性を示しています。H.264/H.265は現在のストリーミングインフラで最も普及したフォーマットであり、デコード処理を省略できる点は計算コストの削減にも直結します。
著者らは今後の課題として、静的シーン理解タスクとのさらなる統合と高解像度動画への対応を挙げています。また、JumpScoreは縄跳びという特定ドメインで設計されたベンチマークであるため、スポーツや製造ラインなど他の高頻度反復動作への汎化についても追加検証が必要です。コーデック構造を入力表現に活用するという着想は、今後の動画マルチモーダルモデルの設計に幅広く影響を与える可能性があります。
論文情報: "LLaVA-OneVision-2: Towards Next-Generation Perceptual Intelligence"(Xiang An et al., 2026) arXiv:2605.25979, CC BY 4.0
本記事の図(図1〜図5)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


