 AI-Papers
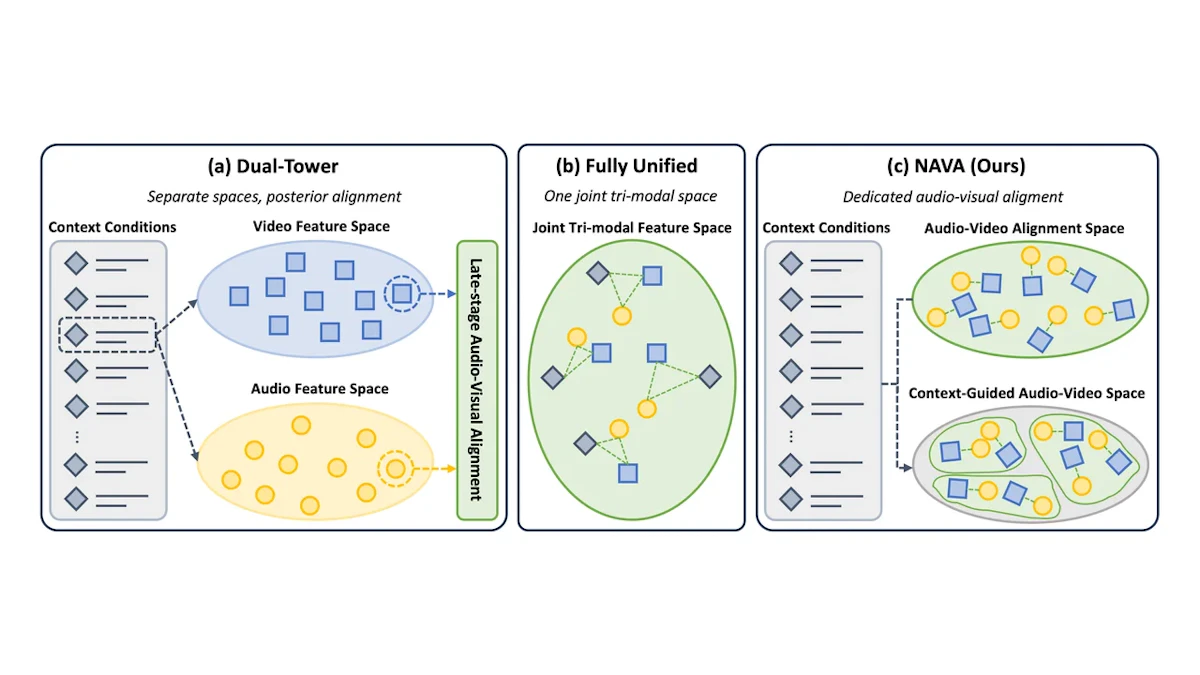
- Align-then-Fuse MMDiTアーキテクチャが音声・映像の専用対応空間と共同デノイジングを段階的に分離し、時間的同期精度を向上させる
- Verse-Benchの全指標で6.3Bパラメータながら10B〜32Bの大規模既存手法を上回る同期精度と映像品質を達成
- Timbre-in-Context Conditioningで多話者の音色を文脈内に符号化し、Seed-TTSで話者類似度66.7を記録(比較手法の35.7を大幅に超過)
研究の背景と課題
映像に合わせた音声を自動生成する技術は、アバター合成や映画の吹き替え、ゲームのNPC音声など幅広い応用が期待されています。しかし、音声と映像を同時に高品質で生成しながら、フレーム単位で正確に同期させることは技術的に難しく、従来手法はいくつかの根本的な問題を抱えていました。
既存のアプローチは大きく2種類に分けられます。1つ目は「Dual-Tower方式」で、音声と映像をそれぞれ独立した特徴空間で処理し、最終段階でのみ対応付けます。この設計では細かな時間的同期が後段の処理に委ねられるため、緻密なフレーム単位の対応が弱くなりがちです。2つ目は「Fully Unified方式」で、音声・映像・テキストの3モダリティ(情報の種類)を単一のAttention空間に統合して処理します。一見すると理想的ですが、高レベルの意味制御(どんな内容か)と低レベルの同期(音と映像のタイミング合わせ)が同じ表現空間で干渉し合い、専用の同期構造が形成されにくいという欠点があります。
BaiduのERNIE研究グループが発表したNAVA(Native Audio-Visual Alignment for Generation)は、この2つの問題を「まず音声と映像を対応付け、その後に文脈情報を融合させる」という分離設計で解決するフレームワークです。
Align-then-Fuse構造の概要
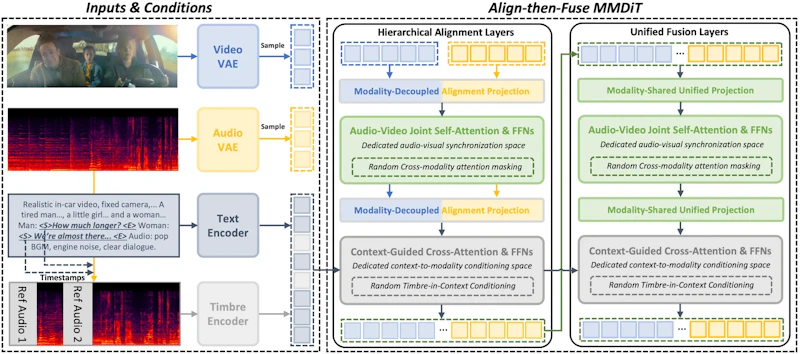
NAVAの核心は「Align-then-Fuse MMDiT(Multi-Modal Diffusion Transformer)アーキテクチャ」にあります。全30ブロックの構成で、前半と後半でまったく異なる役割を担います。
前半10ブロックは「階層的アライメント層(Hierarchical Alignment Layers)」です。ここでは音声と映像それぞれに専用のプロジェクション(次元変換)を適用し、2つのモダリティ間の性質の違いを吸収した上で、音声・映像間の自己注意(Self-Attention)で共進化を学習します。音声と映像ではトークンの時間密度が異なるため、ロータリー位置埋め込み(RoPE)をスケール比に応じて再調整することで位置情報のずれも補正しています。テキストなどの文脈情報はこの段階では交差注意(Cross-Attention)として別途注入され、同期学習への干渉を防ぎます。
後半20ブロックは「統一融合層(Unified Fusion Layers)」です。前半でアライメントが確立された音声・映像の特徴をモダリティ共有のプロジェクションで統合し、安定した共同デノイジング(拡散モデルのノイズ除去処理)を行います。パラメータを共有することでモデルの効率化も図られており、6.3Bという比較的小さなパラメータ数での高性能化を支えています。
多話者音色の制御方法
複数の話者が登場する動画を生成する際には、「誰がどの区間で話しているか」を音色(タイムブル)のレベルで制御する必要があります。NAVAはこれを専用の制御ブランチを追加することなく、文脈情報の構造として表現する「Timbre-in-Context Conditioning(TCC)」で実現しています。
具体的には、各話者区間を「開始トークン・参照音色・テキスト・終了トークン」の形式でシーケンス化し、文脈トークンとして注入します。この設計により、複数の話者に対して異なる参照音色を別々の区間に割り当てるだけで、追加パラメータなしに多話者の音色制御が可能になります。VideoMLAのようなビデオ拡散モデルの効率化研究と同様に、モデルを大規模化せずに機能拡張を実現している点が特徴です。
実験結果と性能比較
NAVAはVerse-BenchとSeed-TTSの2つのベンチマークで評価されました。比較対象には、Ovi(10B)、MoVA(32B)、daVinci(15B)、LTX-2.3(19B)といったより大規模なモデルが含まれます。以下の表でVerse-Benchの結果を示します。Sync-Cは音声映像の同期度合い(高いほど良い)、Sync-Dは音声映像のタイミングのずれ(低いほど良い)、WERは音声認識の誤り率(低いほど良い)を表します。
モデル | パラメータ数 | Sync-C↑ | Sync-D↓ | 映像品質↑ | WER↓ |
|---|---|---|---|---|---|
NAVA | 6.3B | 7.791 | 7.566 | 0.659 | 0.099 |
Ovi | 10B | 7.484 | 7.979 | 0.636 | 0.102 |
MoVA | 32B | 7.289 | 7.808 | 0.603 | 0.126 |
daVinci | 15B | 7.149 | 7.816 | 0.600 | 0.151 |
LTX-2.3 | 19B | 7.248 | 7.690 | 0.576 | 0.106 |
NAVAはすべての指標で比較手法を上回りました。特に音声映像同期(Sync-C)と映像品質での差が顕著です。さらに話者類似度を評価するSeed-TTSベンチマークでは、NAVAが66.7を記録したのに対しDreamID-Omniは35.7にとどまり、音色制御の精度の高さを示しています。
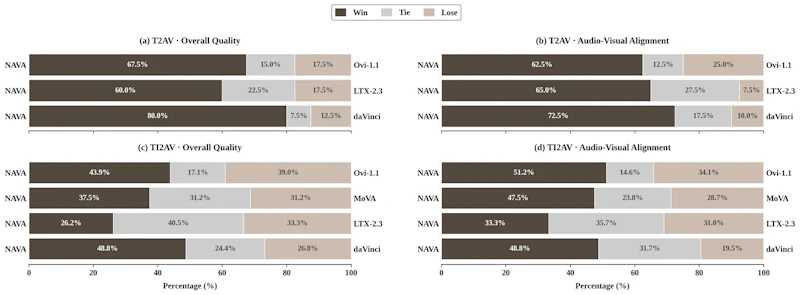
人間の評価(ユーザー研究)においても、T2AV(テキストから音声・映像を生成)設定でdaVinciに対して80.0%の勝率を達成し、全体品質・同期精度の両面でNAVAへの支持が確認されました。LTX-2.3とは接戦になる場面もありましたが、そのモデルが19Bであるのに対してNAVAは6.3Bと大幅に小さいことを踏まえると、スケール効率の面で顕著な優位性があります。
まとめと今後の展望
NAVAは、音声と映像の同期を意味理解と分離した専用空間で学習するという設計思想により、6.3Bというコンパクトなパラメータ数で既存の大規模手法を超える性能を実現しました。Align-then-Fuse構造とTimbre-in-Context Conditioningの組み合わせは、アバター生成・映画吹き替え・多話者ポッドキャスト動画など実用的な用途への応用が見込まれます。
一方で、非常に複雑な音響環境(多数の環境音が混在するシーンなど)や長尺動画への対応は今後の課題です。多言語対応やリアルタイム生成への最適化なども引き続き研究が必要な領域であり、音声映像同時生成の実用化に向けた今後の展開が注目されます。
論文情報: "Native Audio-Visual Alignment for Generation"(Longbin Ji et al., 2026) arXiv:2605.30073, CC BY 4.0
本記事の図(図1、図2、図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


