 AI-Papers
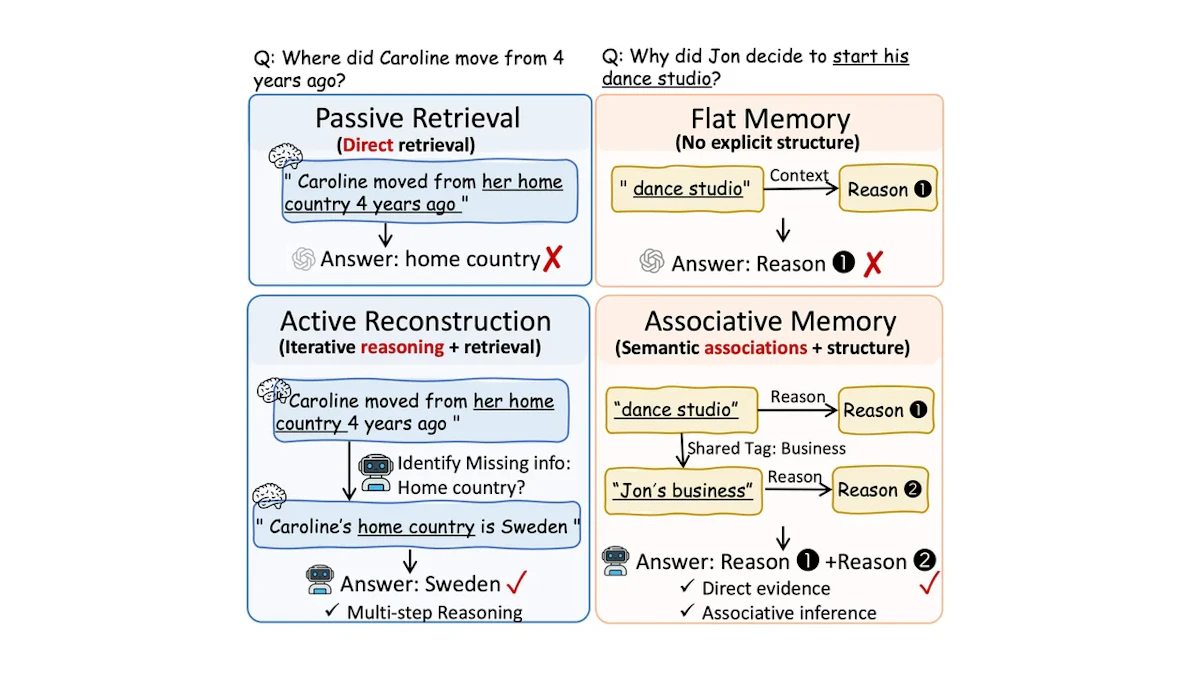
- 人間の記憶科学に倣い、LLMが推論しながらグラフを能動的に探索する「記憶の再構成」を実現したMRAgentをICML 2026で発表
- 会話履歴をCue-Tag-Contentの3層グラフに整理し、多段階推論で多ホップ質問にも連鎖的に対応できる仕組みを構築
- LoCoMoで最大23.3%、LongMemEvalで約32.8%の精度向上を達成しながら、A-Memと比較してトークン消費を約5.4分の1に削減
研究の背景と課題
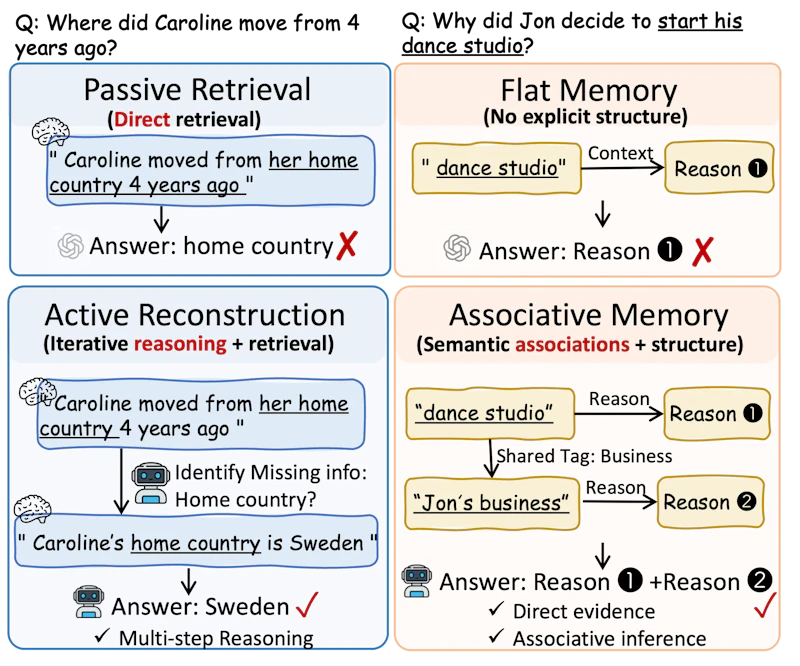
AIチャットボットやエージェントが長期間にわたって会話を続けると、膨大な過去のやりとりを参照しながら回答しなければならない場面が増えます。従来の多くのシステムはRAG(Retrieval-Augmented Generation、検索拡張生成)と呼ばれる方式を採用しており、クエリに意味的に近い記憶を一度に引き出す「受動的な検索」を行います。
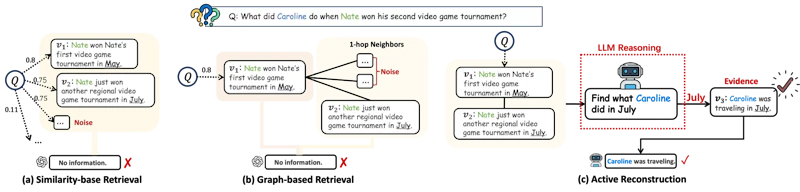
この方式には根本的な限界があります。たとえば「Aさんが夏に参加したトーナメントで知り合ったBさんは、その後どんな活動をしていましたか?」のような複数のステップを踏む質問(多ホップ質問)では、最初のクエリだけでは必要な記憶にたどり着けません。途中の推論で得られた中間情報「夏」「トーナメント」「Bさん」を手がかりにして初めて関連記憶が見つかるからです。
人間の記憶研究では、記憶は固定的に保存されて検索されるのではなく、想起の文脈によって能動的に「再構成」されることが分かっています。シンガポール国立大学のShuoらは、この認知科学の知見をLLMエージェントに適用した手法「MRAgent」をICML 2026に発表しました。
記憶の仕組み:Cue-Tag-Content
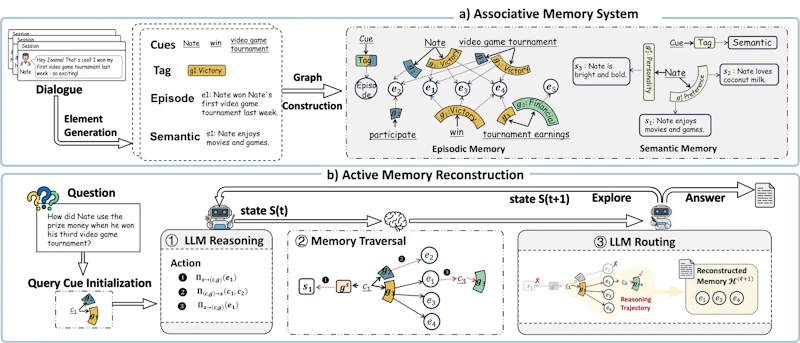
MRAgentの核心は、会話履歴を「Cue-Tag-Contentグラフ」として整理することにあります。3種類の情報がグラフのノードとなりエッジで結ばれ、関連情報が意味的に連鎖したネットワークを形成します。
Cue(手がかり)は人名・場所・属性など細かいキーワードです。Tag(タグ)はそのキーワードに関連するトピックや意味的な橋渡し情報であり、CueとContentをつなぐ中間層として機能します。Content(内容)は実際の記憶の詳細、すなわちエピソード記憶や意味記憶の具体的な本文にあたります。
このグラフ構造により、直接的な類似度では見つからない関連記憶でも、タグを経由した意味的な連鎖をたどって到達できます。人間が「あのとき」「あの場所で」という文脈を手がかりに記憶を呼び起こすプロセスと対応する設計です。
能動的記憶再構成の動き
記憶を取り出すときの動作も従来手法と大きく異なります。受動的検索がクエリとの類似度で記憶を一括取得するのに対し、MRAgentはLLMを使ってグラフを段階的に推論します。
まず最初の手がかり(Cue)を起点にタグを選択し、そのタグから関連するContentを取り出します。取り出した情報のなかに次の手がかりが含まれていれば、それを新たなCueとして再びグラフを探索します。
このサイクルの繰り返しにより、最初のクエリだけでは届かなかった深い記憶にもたどり着けます。探索の打ち切り条件を設けることで、組み合わせ爆発も防いでいます。
実験結果
MRAgentは長期会話評価の代表的なベンチマーク2種で性能を検証しました。
LoCoMo(複数セッションにわたる長期会話理解)では、Geminiバックボーン使用時のLLM評価スコアで84.21を達成しました。最良ベースラインのMem0(68.31)との比較で相対改善は23.3%です。Claudeバックボーンでも88.32を記録しています。複数の推論ステップが必要な多ホップ質問や、時系列を追った質問で改善が大きく出ました。
LongMemEvalでは72.95を記録し、最も近いベースラインのMemoryOS(54.92)からの相対改善は約32.8%に達しました。
計算コストの面でも良好な結果が出ています。比較したシステムとのトークン消費量は次の通りです。
手法 | トークン消費量 |
|---|---|
LangMem | 約327万トークン |
A-Mem | 約63万トークン |
MRAgent | 約11.8万トークン |
A-Memとの比較で約5.4倍の効率にあたります。グラフ探索の範囲を推論によって絞り込むため、全ての記憶を一括処理する必要がなく、精度とコストを両立できます。
なおEvoArenaのようなエージェント評価フレームワークと組み合わせることで、より動的な環境での記憶能力を継続的に測定する研究も今後期待されます。
まとめと今後の展望
MRAgentは、認知科学の「記憶は再構成される」という知見をLLMエージェントの設計に落とし込んだ研究です。Cue-Tag-ContentグラフとLLMによる能動的な推論探索を組み合わせることで、多ホップ質問への対応力と計算効率を同時に高めることに成功しています。
課題としては、会話の初期段階ではグラフが小さいため恩恵が限られること、グラフが大規模になったときの探索効率の検証が挙げられます。また、現在は対話形式のデータを前提としており、構造化の異なるドメインへの適用には追加の調整が必要になる可能性もあるでしょう。
長期的なパーソナライズを必要とするAIアシスタントや、複数ターンにわたる複雑なタスクを扱うAIエージェントへの応用が見込まれます。コードはGitHubで公開予定とされており、実応用や追随研究が広がる余地があります。
論文情報: "Memory is Reconstructed, Not Retrieved: Graph Memory for LLM Agents"(Shuo Ji, Yibo Li, Bryan Hooi, 2026) arXiv:2606.06036, CC BY 4.0
本記事の図(図1、図2、図4)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


