 AI-Papers
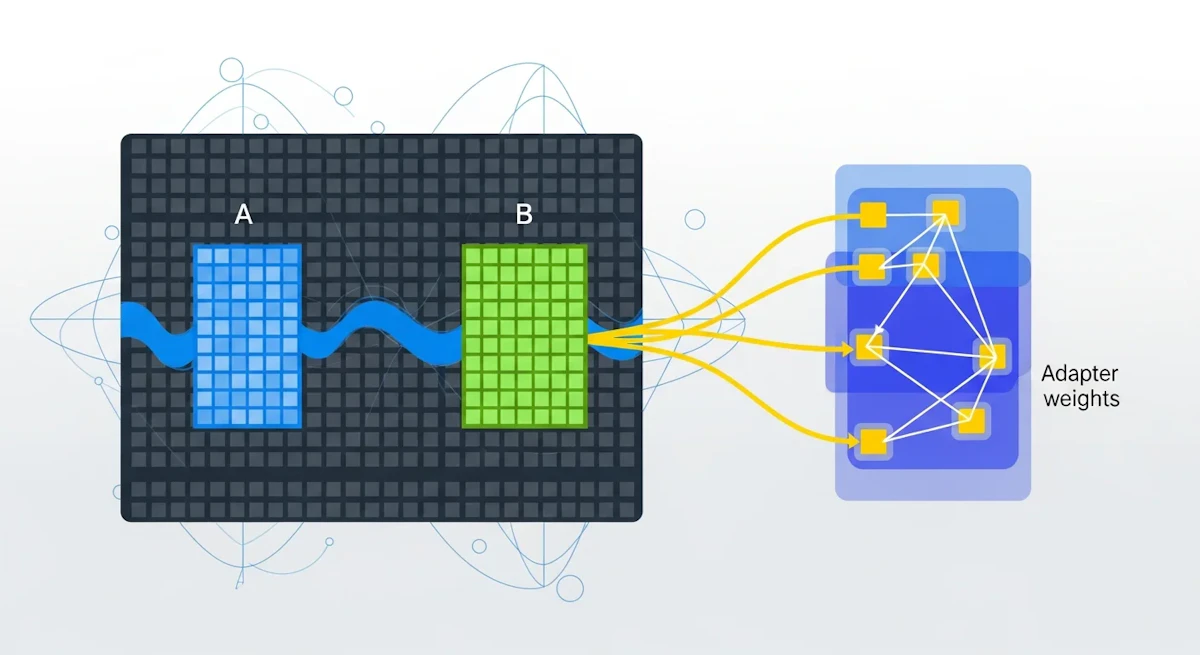
- LoRAは巨大モデルの重みを凍結し、小さな2つの行列(A・B)だけを学習することでファインチューニングのコストを大幅に削減するPEFT手法
- QLoRAは4ビット量子化とLoRAを組み合わせ、単一の家庭用GPUでも70億〜700億パラメータのLLMをファインチューニング可能にした技術
- DoRA・RSLoRAなど2024〜2025年の発展形は、学習の安定性と精度をさらに高め、Stable DiffusionからLLaMAまで幅広い用途で実用化されている
LoRAとは何か
LoRA(Low-Rank Adaptation: 低ランク適応)は、大規模AIモデルを少ないリソースで効率よくファインチューニングするための手法です。2021年にMicrosoftの研究者が発表した論文「LoRA: Low-Rank Adaptation of Large Language Models」が起点となり、その後LLM(大規模言語モデル)から画像生成AIまで、AI開発の現場に広く普及しました。
そもそもファインチューニングとは、事前学習済みの大規模モデルに対して特定のタスクや知識を追加学習させる作業です。しかし、GPT系やLLaMAのような数十億パラメータを持つモデルをゼロから全パラメータで再学習しようとすると、数十〜数百GBのGPUメモリと膨大な計算時間が必要になります。個人や中小規模の組織には到底手が届かない規模です。
LoRAはこの課題を根本的に解決します。元のモデルの重みを「凍結(フリーズ)」したまま変更せず、ごく小さな追加行列だけを学習するという発想です。百科事典の本体に手を加えず、差分だけを記した薄い補足冊子を追加するイメージです。学習が終われば、この補足をそのままモデルに融合(マージ)して推論時のオーバーヘッドもゼロにできます。
LoRAの数学的な仕組み
低ランク分解とは
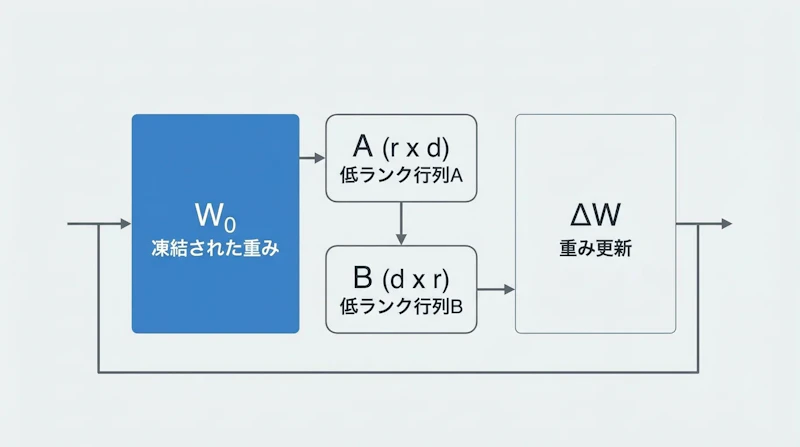
LoRAのコアアイデアは「低ランク分解」にあります。通常のニューラルネットワーク層では、入力ベクトルに対して巨大な重み行列 W₀(たとえば1024×1024)を掛け算して出力を得ます。ファインチューニングでは、この W₀ を更新量 ΔW だけ変化させることになりますが、ΔW を1024×1024の行列全体として保持するのは非常にコストが高くなります。
LoRAは「ΔW は実質的に低いランクで表現できる」という仮説に基づきます。つまり、巨大な更新行列ΔWを、ランクrが小さい2つの行列 A(r×d)と B(d×r)の積で近似します。
出力 = W₀ × 入力 + ΔW × 入力
     = W₀ × 入力 + (B × A) × 入力

W₀ : 元の重み行列(凍結・変更しない)
A  : r × d の小行列(学習対象)
B  : d × r の小行列(学習対象)
r  : ランク(ハイパーパラメータ、通常4〜64)
たとえば d=1024、r=8 のとき、本来必要な更新パラメータは 1024×1024=約100万個ですが、LoRAでは (1024×8)+(8×1024)=約16,000個で済みます。パラメータ数が約60分の1に圧縮されるわけです。学習後、AとBの積をW₀に加算してマージすれば、モデル構造が変わらないため推論速度の低下もありません。
重要なパラメータ: ランクrとlora_alpha
LoRAを使いこなすうえで最も重要な設定が「ランクr」と「lora_alpha(スケーリング係数)」です。rが小さいほど学習パラメータが少なくなりメモリ効率が良くなりますが、表現力も下がります。一般的にはr=4〜32が多く使われ、複雑なタスクではr=64以上を使う場合もあります。
lora_alphaはスケーリングのための係数で、実際の更新量は (lora_alpha / r) × B×A として計算されます。慣例的に lora_alpha = 2 × r が初期値として使われることが多いです。
LoRAを使う具体的な手順
HuggingFaceのPEFTライブラリを使えば、数行のコードでLoRAを適用できます。
from transformers import AutoModelForCausalLM
from peft import LoraConfig, get_peft_model

# ベースモデルの読み込み
base_model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-3.1-8B")

# LoRAの設定
lora_config = LoraConfig(
    r=8,                           # ランク
    lora_alpha=16,                 # スケーリング係数
    target_modules=["q_proj", "v_proj"],  # 適用対象レイヤー
    lora_dropout=0.05,
    bias="none",
)

# LoRAを適用(元モデルの重みは自動的に凍結される)
model = get_peft_model(base_model, lora_config)
model.print_trainable_parameters()
# trainable params: 3,407,872 || all params: 8,033,669,120 || trainable%: 0.04
上記の例ではLLaMA 3.1 8Bの全81億パラメータのうち、わずか0.04%(約340万個)だけを学習対象にできます。学習後は merge_and_unload() でLoRA重みをベースモデルにマージし、通常のモデルとして保存・配布できます。
QLoRAとは?量子化との組み合わせ
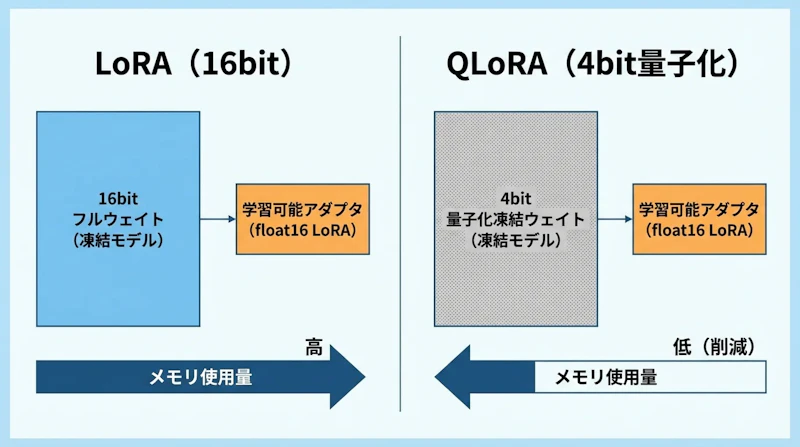
QLoRA(Quantized LoRA)は、2023年にワシントン大学の研究チームが発表した手法で、LoRAをさらに進化させた技術です。「4ビット量子化」と「LoRA」を組み合わせることで、単一のコンシューマー向けGPU(VRAM 24GB程度)で70億パラメータ以上のLLMをファインチューニング可能にしました。
量子化とは何か
AIモデルの重みは通常、32ビット(float32)や16ビット(float16)の浮動小数点数で保存されています。量子化はこれをより少ないビット数(4ビットや8ビット)に圧縮することで、メモリ使用量を削減する技術です。
QLoRAでは「NF4(4ビット NormalFloat)」と呼ばれる特殊なデータ型を使います。これはモデルの重みが正規分布に従うという統計的性質を利用して、4ビットの数値表現の精度を最大化したものです。通常の4ビット整数量子化よりも情報損失が少ない点が特徴です。
QLoRAの3つの技術
- 4ビットNF4量子化: ベースモデルを4ビットに圧縮(メモリを約4分の1に削減)
- 二重量子化(Double Quantization): 量子化定数自体もさらに量子化し、追加のメモリ節約を実現
- ページドオプティマイザー: GPU/CPU間でグラジェントを動的に転送し、OOMエラーを防止
これらの工夫により、QLoRAは通常のLoRA(16ビット)と比べてさらにメモリを半分以下に削減しながら、精度はフルファインチューニングに近い水準を維持できます。
DoRA・RSLoRAなど最新の発展形
DoRA(重みを大きさと方向に分解)
DoRA(Weight-Decomposed Low-Rank Adaptation)は2024年にNVIDIAと台湾国立大学の研究チームが提案した手法で、ICML 2024に採択されました。LoRAをさらに精度面で改善することを目的としています。
DoRAのアイデアはシンプルです。重み行列を「大きさ(Magnitude)」と「方向(Direction)」の2成分に分解します。大きさは各行の長さ(L2ノルム)であり、方向は正規化された単位ベクトルです。DoRAは大きさをスカラーとして直接学習し、方向の更新にはLoRAを適用します。
この分解によりフルファインチューニングの学習パターンに近い挙動が得られ、LoRAと同じランクを使った場合でも精度が向上します。特に低ランク(r=4〜8)での改善が顕著で、LoRAと比べてランクを半分にしても同等以上の性能を示す実験結果が報告されています。PEFTライブラリでは use_dora=True を指定するだけで利用できます。
lora_config = LoraConfig(
    r=8,
    lora_alpha=16,
    use_dora=True,  # DoRAを有効化
    target_modules=["q_proj", "v_proj"],
)
RSLoRA(ランク安定化スケーリング)
RSLoRA(Rank-Stabilized LoRA)は、スケーリングの計算式を改善することで高ランク設定での学習安定性を高めた手法です。通常のLoRAでは更新量のスケーリングを lora_alpha / r で計算しますが、RSLoRAはこれを lora_alpha / √r(rの平方根)に変更します。
この変更は小さく見えますが、高ランク(r=64以上)でのファインチューニングにおいて学習が不安定になる問題を軽減し、より高い最終精度を達成できることが実証されています。PEFTライブラリでは use_rslora=True で有効化できます。
LoftQ(量子化誤差を最小化する初期化)
LoftQ(LoRA-Fine-Tuning-Aware Quantization)は、量子化とLoRAを組み合わせる際に生じる量子化誤差を最小化する初期化手法です。通常、モデルを量子化してからLoRAを適用すると初期の重み行列が歪み、学習の出発点が悪化します。LoftQは量子化誤差を考慮した最適な初期値を計算することで、QLoRAより高い精度を実現できます。
各手法の比較
手法 | メモリ削減 | 精度 | 主な用途 | 推奨シナリオ |
|---|---|---|---|---|
フルFT | なし | 最高 | 小〜中規模モデル | リソースが豊富な場合 |
LoRA | 中程度 | フルFTに近い | LLM全般 | GPU 1〜2枚でのFT |
QLoRA | 大(約4分の1) | LoRAに近い | 大規模LLM | コンシューマーGPU |
DoRA | 中程度 | LoRAより高い | 高精度が必要なFT | 低ランクで高精度を狙う |
RSLoRA | 中程度 | 高ランクで改善 | 高ランクLoRA | r=64以上の設定 |
LoftQ | 大(量子化) | QLoRAより高い | 量子化+LoRA | 精度を妥協したくない場合 |
画像生成AIでのLoRA活用
LoRAはLLMだけでなく、Stable DiffusionやFLUXなどの画像生成AIでも広く使われています。特定のキャラクター・画風・スタイルを少枚数の学習画像(20〜100枚程度)から習得させるために使われ、CivitAIなどのプラットフォームには数万個以上のLoRAモデルが公開されています。
画像生成AIでのLoRAは、LLMとは少し異なる使われ方をします。学習済みLoRAは .safetensors ファイルとして配布され、生成時にベースモデルに重ね合わせて使います。複数のLoRAを同時に適用することも可能で、たとえば「特定キャラクターのLoRA」と「特定画風のLoRA」を組み合わせて、そのキャラクターを指定のスタイルで描画させることができます。
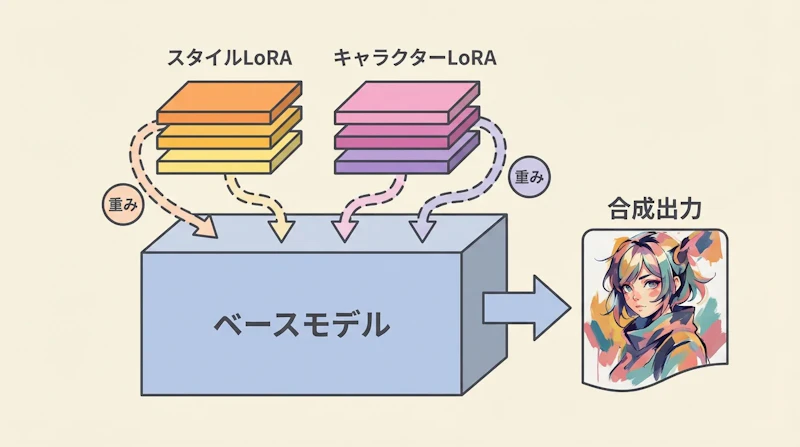
テキスト生成AIと比べた特徴として、画像生成AIのLoRAはベースモデルのAttention層だけでなくConvolution層にも適用されることが多く、ランクr=4〜32が標準的です。DreamBoothと組み合わせることで特定の人物や物体を少枚数で学習させる「DreamBooth LoRA」という使い方も一般的になっています。
LLMでのLoRAファインチューニング実践
実際にLLMをLoRAでファインチューニングする際のポイントを整理します。まず、どのレイヤーにLoRAを適用するかが重要です。Transformerアーキテクチャでは一般に q_proj(クエリ)と v_proj(バリュー)への適用から始め、効果が不十分なら k_proj、o_proj、さらには全Attention層や FFN(フィードフォワード層)へと広げていきます。
GPUメモリが限られている場合はQLoRAが有効です。VRAM 24GBのGPU(RTX 4090やA10など)では、QLoRAを使えばLLaMA 3.1 70Bクラスのモデルも単一GPU上でファインチューニングできます。より精度を重視する場合はDoRAを、高ランク設定での安定学習を優先する場合はRSLoRAを選択します。
なお、LLMのファインチューニング技術はLoRAだけに留まりません。推論能力の強化を目的としたo3やDeepSeek-R1のような推論モデルでは、LoRAによるSFT(教師ありファインチューニング)の後にRLHFやRLVRなどの強化学習を組み合わせる多段階アプローチが主流になっています。
LoRAの適用対象レイヤーの選び方
LoRAを適用するモジュールの選択は精度に大きく影響します。HuggingFaceのPEFTでは target_modules="all-linear" と指定することで、モデル内のすべての線形層を自動的に対象にできます。手動で選択する場合の一般的なガイドラインは以下の通りです。
- 最小構成:
q_proj+v_proj(オリジナル論文の設定) - 標準構成:
q_proj+k_proj+v_proj+o_proj(Attentionレイヤー全体) - 拡張構成: 上記 +
gate_proj+up_proj+down_proj(FFNレイヤーも含む)
精度とリソースのトレードオフを考えると、まず標準構成で試してみることをお勧めします。タスクによっては最小構成でも十分な精度が出る場合も多くあります。
LoRAを始めるために必要な環境
LoRAを試す最低限の環境として、VRAM 8GB以上のGPUがあれば7B(70億)パラメータ程度のモデルをQLoRAでファインチューニングできます。クラウド環境ではGoogle Colab Pro(A100 40GB)やAWS p3.2xlarge(V100 16GB)が手軽な選択肢です。
必要なライブラリは主に4つです。transformers(モデル読み込み)、peft(LoRA適用)、datasets(データ管理)、そして bitsandbytes(QLoRAの量子化処理)です。これらはすべてPyPI経由でインストールでき、HuggingFaceのコミュニティには無数の学習済みLoRAアダプタが公開されているため、既存アダプタを試すところから始めることも可能です。


