 AI-Papers
- GPT-4.1生成の平均109語キャプション8億件で構成するLens-800Mデータセットが、データ品質を通じた学習効率の劇的な向上を実現
- A100とH800のGPU性能差を考慮した計算量換算で、Z-Image(7B)の約19.3%というコストで6B以上の大規模モデルと同等のベンチマーク性能を達成
- 4ステップ蒸留によるLens-TurboはH100で0.84秒推論を実現し、最大1440解像度・多言語対応もサポート。コードはGitHub公開済み
研究の背景
テキストから画像を生成するモデル(T2I)は近年急速に性能が向上しています。しかし、高品質な生成を実現するには数十億パラメータの大規模モデルと膨大な学習計算量が必要とされるのが一般的な課題でした。
Microsoftが発表した「Lens」は、この前提に切り込む3.8BパラメータのT2Iモデルです。データ品質の向上・アーキテクチャの改良・強化学習(RL)後学習を組み合わせることで、より大きなモデルに匹敵する性能を大幅に少ない計算量で達成しました。近年、SEGAのようにDiTベースの推論効率を改善するアプローチが相次いでいますが、Lensは学習側の効率化に正面から取り組んでいる点が特徴です。
Lens-800Mデータセット
Lensの性能向上の土台となるのが、独自に構築した「Lens-800M」データセットです。約8億件の画像テキストペアから構成され、テキスト部分はGPT-4.1によって生成されたキャプションを採用しています。
従来のT2Iモデルが使う短いキャプション(多くは10〜20語程度)と異なり、Lens-800Mのキャプションは平均109語という高密度な記述になっています。この豊富なセマンティック情報(意味的な記述内容)が、モデルのテキスト指示への追従性を底上げします。
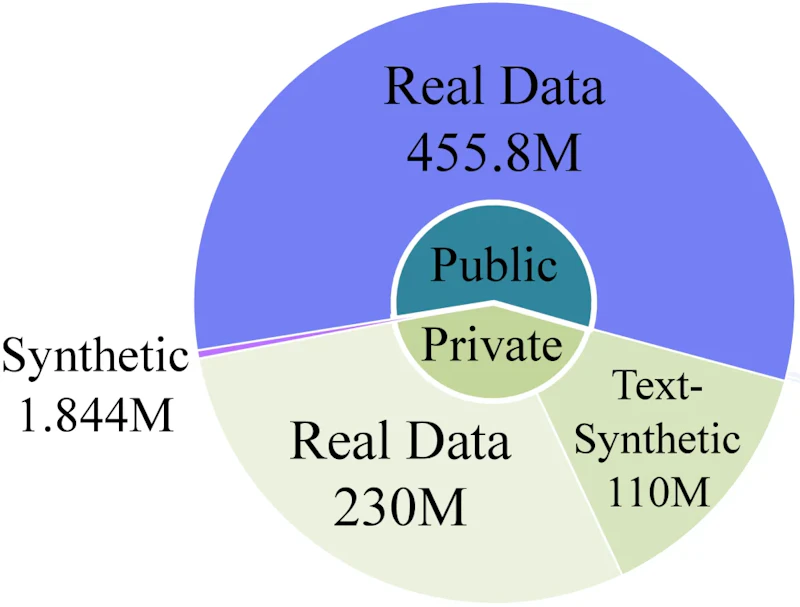
複数解像度とアスペクト比を組み合わせたバッチ構成も採用しており、1回の最適化ステップあたりの視覚的カバレッジを広げることで収束効率を高めています。
モデルアーキテクチャ
Lensのアーキテクチャには、Multimodal Diffusion Transformer(MMDiT)を採用しています。MMDiTは画像の潜在表現とテキスト表現を独立したストリームで処理し、Attention(注意機構)によって両者を結合する構造です。
潜在空間の品質向上には「セマンティックVAE」を導入しました。通常のVAE(変分オートエンコーダ)が画素レベルの再構成を重視するのに対し、セマンティックVAEはより意味的な情報を保持した潜在表現を学習します。これにより収束速度が向上し、最終的な生成品質も高まります。
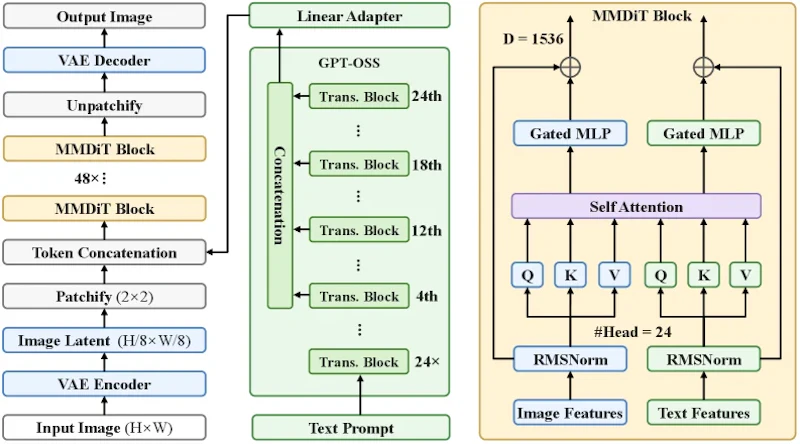
テキスト側の言語エンコーダには強力なモデルを採用しており、英語だけでなく中国語・フランス語・日本語・スペイン語といった多言語への対応も実現しています。
学習コストを19.3%に抑えた仕組み
Lensの学習に要した計算量は192,000 A100 GPU時間(BF16精度、ピーク312 TFLOPS)です。比較対象のZ-Image(7B)は314,000 H800 GPU時間(BF16精度、ピーク989.5 TFLOPS)を要しています。
単純なGPU時間だけ比較すると約61%ですが、A100とH800ではBF16のピーク演算性能が約3倍異なります。そこでGPU性能差を考慮した総計算量(TFLOPS×GPU時間)に換算すると、LensはZ-Imageの約19.3%の計算量で同等の性能を達成しているというのが正確な比較です。
データ品質の向上がモデルサイズ不足を補うという考え方が、このコスト削減の核心にあります。高密度キャプションによる情報密度の向上とセマンティックVAEによる収束速度の改善が組み合わさることで、少ない学習ステップ数でも高品質な表現を獲得できます。
さらに事後学習として、約8,000件の精選データ(Lens-RL-8K)を用いた強化学習(RL)を実施しています。美的品質・テキスト描画・人物表現のバランスを改善し、ユーザーの好みに合った生成品質へと調整します。
ベンチマーク性能と推論速度
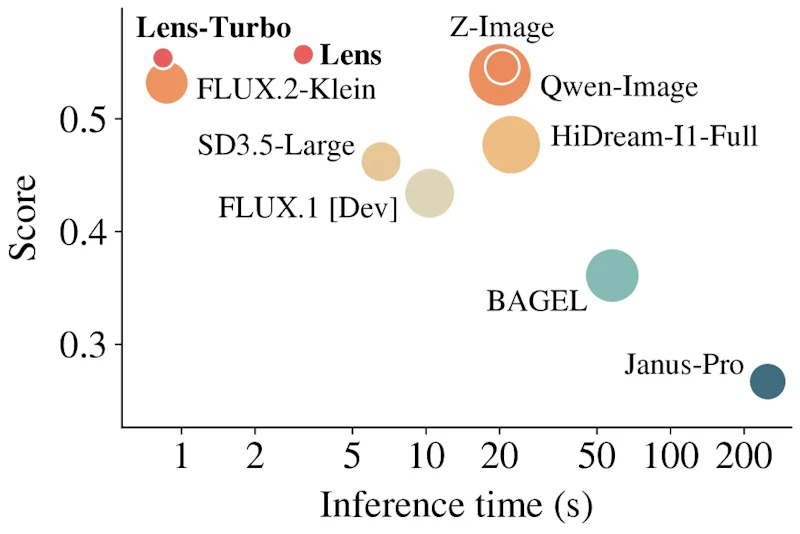
OneIGやGenEvalといったT2Iベンチマークで、LensはFLUX.2-dev(9B)やQwen-Image(20B)といった大規模モデルと同等の評価を獲得しています。3.8Bというパラメータ数を考えると高い計算効率です。
推論速度については、フルモデルで1024×1024画像をH100で3.15秒で生成します。4ステップ蒸留を施したLens-TurboはH100で0.84秒での生成を実現しており、インタラクティブな用途も視野に入ります。最大1440解像度・1対2から2対1のアスペクト比もサポートしています。
まとめと今後の展望
Lensは「モデルを大きくする」以外の方向性、つまりデータ品質の追求と学習設計の改善によって高性能を達成した点が際立っています。8億件という大規模データを高品質なキャプションで整備するコストは小さくありませんが、一度構築すれば学習計算量の削減という形で還元されます。
コードはGitHubで公開されており、研究者がデータパイプラインや学習設定を再現・改良しやすい環境が整っています。高密度キャプションとセマンティックVAEの組み合わせは、動画生成や3D生成といった周辺分野にも応用が期待できる方向性です。一方で、GPT-4.1によるキャプション生成コスト自体が小規模研究者の参入障壁になりうる点は課題として残ります。
論文情報: "Lens: Rethinking Training Efficiency for Foundational Text-to-Image Models"(Dong Chen et al., 2026) arXiv:2605.21573
本記事の図(図1〜図3)は解説のため上記論文より引用しています。


