AI-Papers
- コンテキストエンジニアリングは、プロンプトだけでなく推論時にモデルへ渡すトークン全体を設計・維持する技術です
- 文脈が長くなるほど想起精度が落ちる「context rot」があり、注意力を有限の予算として扱う発想が前提になります
- 長時間タスクでは圧縮(compaction)、構造化メモ、サブエージェントの3手法を使い分けるのが定石です
コンテキストエンジニアリングとは?
コンテキストエンジニアリング(context engineering)とは、Large Language Model(LLM)に推論のたびに渡すトークン一式を、どう選び、どう整え、どう捨てるかを設計する実践のことです。Anthropic は公式の技術記事でこれを「プロンプトエンジニアリングの自然な延長」と位置づけ、指示文の書き方にとどまらず、ツールの定義、ツールの実行結果、会話履歴、外部から取ってきた文書など、文脈窓に入るすべてを対象にすると説明しています。
違いを一言でまとめると、プロンプトエンジニアリングが「何を書くか」の最適化であるのに対し、コンテキストエンジニアリングは「毎ターン、何をモデルの目の前に置いておくか」の最適化です。AIエージェントはツールをループで呼び続けるため、文脈は会話が進むたびに自動的に膨らんでいきます。1回書いて終わりではなく、ループのたびに繰り返し判断が発生する、という点が決定的な差になります。
Anthropic はこの設計の指針となる問いを、「どういう文脈の構成なら、望む振る舞いが最も起きやすいか」と表現しています。正解のプロンプト文を探すのではなく、状態の管理方法を設計する作業だと考えると理解しやすいでしょう。
プロンプトとの違いを整理
両者は対立する概念ではなく、後者が前者を包含する関係にあります。実務上の守備範囲の違いを表にすると次のようになります。
観点 | プロンプトエンジニアリング | コンテキストエンジニアリング |
|---|---|---|
対象 | システムプロンプト、指示文 | 指示文+ツール定義+履歴+検索結果+メモ |
タイミング | 基本は事前に1回 | 推論のたびに反復的に判断 |
主な課題 | 指示の明確さ、出力形式の安定 | トークン量と情報密度のトレードオフ |
典型的な失敗 | 曖昧な指示で出力がぶれる | 文脈が肥大化して必要な情報を見失う |
主な利用場面 | 単発のチャット、分類タスク | ツールを使うエージェント、長時間タスク |
なぜ長い文脈で精度が落ちるのか
コンテキストエンジニアリングが必要になる根拠が、いわゆる context rot(文脈の腐敗)です。Chroma の技術レポート「Context Rot」は GPT-4.1、Claude 4 系、Gemini 2.5、Qwen3 など18種類のモデルを対象に、入力長を変えながら同じ難度のタスクを解かせました。結果は一貫していて、入力が長くなるほど性能が下がります。単純な作業でも例外ではありませんでした。
この検証では、質問と探すべき情報の意味的な近さが低いほど劣化が速いこと、紛らわしい情報(distractor)が1つ混じるだけで正答率が下がり4つで悪化が重なること、さらに論理的につながった文章よりシャッフルされた文章の方が成績が良いという直感に反する結果まで報告されています。長い文脈は「入っていれば読まれる」ものではない、というわけです。
Anthropic はこの現象の背景として、Transformer があらゆるトークン同士の関係を計算するため、n トークンに対して n² の組み合わせが生じること、学習データに長い系列が相対的に少ないこと、位置エンコーディングの補間で位置の精度が落ちることを挙げています。そこから導かれるのが「注意力は有限の予算(attention budget)である」という考え方です。トークンを1つ増やすたびに予算を取り崩していると捉えれば、情報を足す判断は常にコストを伴います。1Mトークン級の文脈長をうたうモデル(Metaが816BのMoE「Muse Spark Open」公開、1Mトークン対応)も登場していますが、窓が広いことと使い切れることは別の話です。
良い文脈をつくる3要素
システムプロンプトの「高度」
Anthropic はシステムプロンプトを適切な「altitude(高度)」に置くべきだと表現します。低すぎると if-else のような場合分けを人手で書き連ねることになり、壊れやすく保守できません。高すぎると「丁寧に対応すること」のような、具体的な手がかりのない指示になります。
推奨されるのは、XML タグや Markdown 見出しでセクションに分け、振る舞いを完全に規定する最小限の情報を書く方法です。ここでの「最小限」は短さではありません。まず最良のモデルで最小のプロンプトを試し、観測された失敗に応じて指示や例を足していく進め方が勧められています。
ツール定義の設計
ツールはエージェントが情報と行動にアクセスする契約そのものです。自己完結していること、エラーに強いこと、機能の重複が少ないこと、返す出力がトークン効率的であることが条件として挙げられています。よくある失敗は、似たようなツールを大量に並べてしまい、どれを選ぶべきか判断できなくなるケースです。人間のエンジニアが迷う道具立ては、エージェントにも選べません。
少数の良質な例示
few-shot の例は、例外ケースの規則を長々と列挙するより、多様で典型的な例を少数そろえる方が効きます。記事中では例を「千の言葉に値する絵」と表現しています。網羅しようとして例を増やすのは、注意力の予算を無駄に使う典型です。
必要になった時に取りに行く
従来の Retrieval-Augmented Generation(RAG: 検索拡張生成)は、推論前に埋め込み検索で関連文書を集めて文脈に詰め込みます。エージェント型の設計では、これに代えて just-in-time retrieval(必要時検索)が増えています。文脈にはファイルパス、保存済みクエリ、URL といった軽量な識別子だけを置き、実行時にツールで中身を読み込む方式です。
Claude Code が大きなデータを扱うとき、オブジェクト全体を読み込まずに head や tail で確認するのがその例です。フォルダ構成、命名、タイムスタンプといったメタデータ自体が、何が重要かを推測する手がかりになります。情報を層状に、段階的に開示していく(progressive disclosure)設計といえます。
ただし実行時の探索は遅く、よい判断基準がなければ文脈を無駄に消費します。現実的なのはハイブリッドで、Claude Code は起動時に CLAUDE.md を文脈へ入れつつ、残りは glob や grep で随時取得します。変化の少ない法務や金融のような領域では、前もって入れておく比率を上げる方が合理的です。Anthropic 自身の指針も「うまくいく最も単純なことをする」でした。
長時間タスクを支える3手法
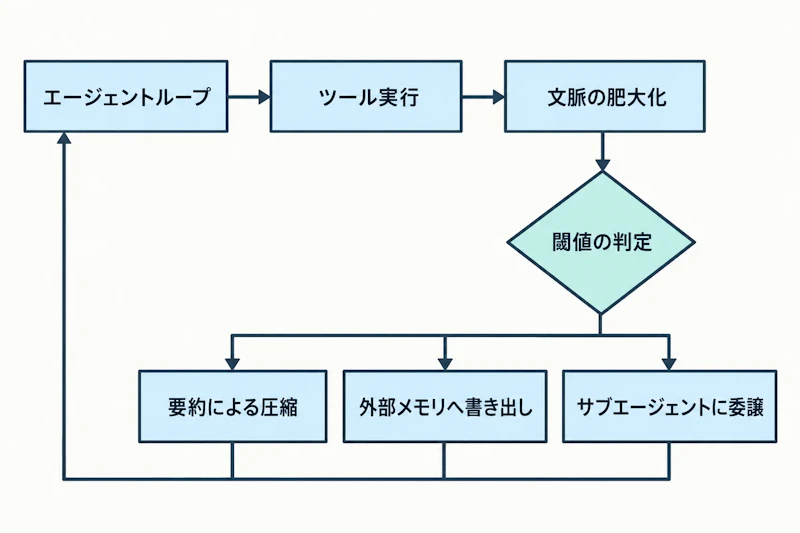
数十分から数時間にわたるタスクでは、作業ログが文脈窓を超えます。Anthropic は3つの対処法を挙げており、図1のように文脈量が閾値に達した時点で、どれを発動させるかという設計になります。
圧縮(compaction)
文脈上限が近づいた段階で会話を要約し、その要約を起点に新しい窓を開く手法です。Claude Code の場合、アーキテクチャ上の決定、未解決のバグ、実装の詳細を残し、冗長なツール出力を捨て、直近でアクセスしたファイル5件を保持します。圧縮プロンプトの調整は、まず取りこぼしを減らす(recall重視)方向で詰めてから、余計な記述を削って精度を上げる順序が勧められています。最も軽い圧縮は、不要になったツール実行結果を消すだけの操作です。
構造化メモ(エージェントメモリ)
文脈の外にあるファイルへエージェント自身がメモを書き、必要なときに読み戻す方式です。ToDo リストや NOTES.md がその典型になります。Anthropic が紹介した Pokémon のプレイ例では、1,234 ステップにわたる進行状況、たとえば目標レベル10に対して Pikachu が8レベル上がったことなどを記録し、マップや戦闘メモを蓄積して、文脈がリセットされた後も作業を再開できました。
サブエージェント構成
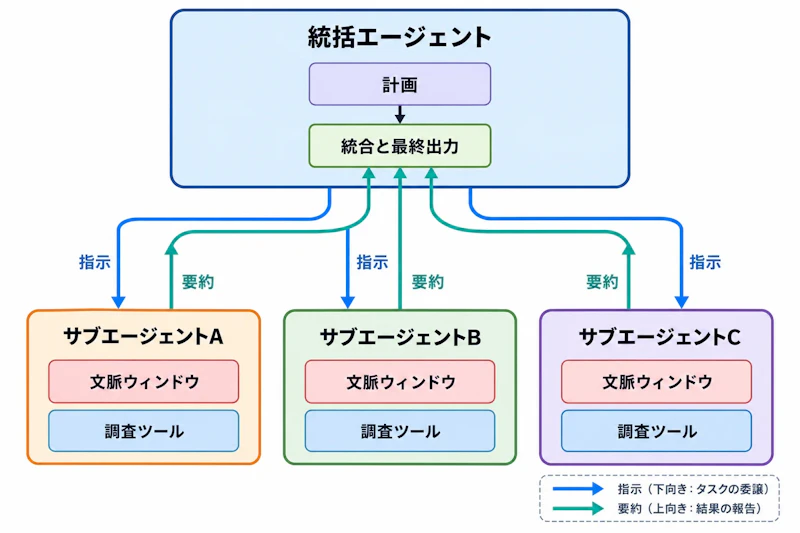
統括エージェントが計画を持ち、専門サブエージェントがそれぞれ綺麗な文脈窓で調査を担当する構成です(図2)。サブエージェントは探索中に数万トークンを使っても、親へ返すのは 1,000 から 2,000 トークン程度に凝縮した要約です。Anthropic のマルチエージェント研究システムでは、Claude Opus 4 を統括、Claude Sonnet 4 をサブエージェントにした構成が単体の Claude Opus 4 を社内の調査評価で 90.2% 上回り、並列検索によって複雑なクエリの所要時間が最大 90% 短縮されました。
ただしコストは跳ね上がります。同じ記事では、エージェントはチャットの約4倍、マルチエージェントは約15倍のトークンを消費すると報告されており、BrowseComp 評価では性能のばらつきの約 80% がトークン使用量で説明できたとされています。使いどころは、価値の高い、並列化しやすい調査タスクに限られます。共有文脈が必要なコーディング作業のような依存関係の強いタスクには向きません。
手法 | 向いているタスク | 主なコスト |
|---|---|---|
圧縮 | やり取りが長く続く対話的な作業 | 要約生成の遅延、細部の喪失 |
構造化メモ | 節目が明確な反復的開発 | メモの保守、読み書きの手数 |
サブエージェント | 並列探索が効く複雑な調査 | トークン消費が大幅増 |
APIでの実装方法
これらの手法の一部は、Claude の API 側機能として提供されています。context editing(文脈編集)は会話履歴の一部をサーバー側で削除する機能で、手元のクライアントには完全な履歴が残ったままです。ベータ機能のため、ヘッダー context-management-2025-06-27 が必要になります。
代表的な clear_tool_uses_20250919 は、古いツール実行結果から順にプレースホルダへ置き換えます。既定値は、入力 100,000 トークンを超えたら発動(trigger)、直近3組のツール呼び出しは保持(keep)です。clear_at_least で1回あたりの最低削除量を指定でき、これは削除がプロンプトキャッシュを無効化してしまうため、割に合う量だけ消すための安全弁になります。
response = client.beta.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "..."}],
    tools=[{"type": "memory_20250818", "name": "memory"}],
    betas=["context-management-2025-06-27"],
    context_management={
        "edits": [
            {
                "type": "clear_tool_uses_20250919",
                "trigger": {"type": "input_tokens", "value": 30000},
                "keep": {"type": "tool_uses", "value": 3},
                "clear_at_least": {"type": "input_tokens", "value": 5000},
                "exclude_tools": ["web_search"],
            }
        ]
    },
)
上の例のようにファイルベースの memory tool(memory_20250818)と組み合わせると、削除の閾値が近づいた時点でモデルに警告が入り、消される前に重要な情報をメモへ書き出せます。構造化メモの考え方が、そのまま API の機能として実装されている形です。実際に削除が走ると、レスポンスの context_management に削除したツール数と削減トークン数が返ります。count_tokens エンドポイントに同じ設定を渡せば送信前に削減量を試算でき、公式ドキュメントでは 70,000 トークンのプロンプトが 25,000 トークンになる例が示されています。
要約による圧縮については、現在はサーバーサイド compaction が推奨経路です。古いターンをモデルが書いた要約へ置き換える処理をサーバー側で行うため、自前の要約コードが不要になります。呼び出し側で明示的に要約を要求する on-demand 方式と、入力トークンが閾値に達したら API が自動で実行する threshold 方式(compact_20260112)があり、ドキュメントでは前者が推奨されています。SDK 内でクライアント側圧縮を行う compaction_control は非推奨となり、Python SDK では v1.0 で削除されました。
どこから手をつけるか
導入順としては、まずツール定義の棚卸しから始めるのが効率的です。重複した曖昧なツール群は、呼び出しミスと無駄なトークンを同時に生みます。次にシステムプロンプトを最小構成に削り、失敗を観測してから足していく。この2つだけで、文脈量が目に見えて減るケースは珍しくありません。
その上で、タスクの長さに応じて圧縮、メモ、サブエージェントを足します。やり取りが長引くなら圧縮、節目のある開発作業ならメモ、並列調査ならサブエージェント、という切り分けが出発点になります。サーバーサイド compaction のように API 側へ寄せられる部分は寄せ、自前実装を減らすのも現実的な選択です。
共通する原則は、Anthropic が繰り返し述べている通り「最小限の高シグナルなトークンを見つける」ことに尽きます。モデルが賢くなるほど細かい指示は不要になりますが、何を見せて何を見せないかという判断そのものは、むしろ自律性が上がるほど効いてきます。