AI-Papers
- RAGの精度不足は生成側ではなく検索側に原因が集まる。チャンク設計、検索方式、順位付けの3層に分けて診断する
- BM25とベクトル検索を並列実行してRRFで融合し、上位だけをリランカーで再採点する多段構成が実務の定石
- スコアの範囲は手法ごとに違う。BM25は上限なし、ベクトルは0.333から1.00、セマンティックリランカーは0.00から4.00
RAGの精度が落ちる原因
社内文書でRAG(Retrieval-Augmented Generation: 検索拡張生成)を構築したものの、肝心の質問に答えられない。この相談の多くは、生成側ではなく検索側に原因があります。LLM(Large Language Model: 大規模言語モデル)は渡された文書を読んで答えるだけなので、正解を含む文書が上位に入っていなければ、どれだけ強力なモデルに差し替えても回答は良くなりません。
Anthropicが公開した検索実験は、この事実を数字で示しています。埋め込みベクトルだけで検索した場合、上位20件に必要な情報が入らない確率が5.7%ありました。同じデータに文脈付与とBM25の併用、さらにリランキングを重ねると、この失敗率は1.9%まで下がっています。検索段階の設計だけで、取りこぼしが3分の1以下になったわけです。
精度が出ない原因は、だいたい次の3つに分類できます。
- チャンクの切り方が悪く、答えが2つのチャンクに分断されている
- 検索方式が単一で、固有名詞や型番のような完全一致に弱い(または逆に言い換えに弱い)
- 候補は取れているが順位が低く、LLMに渡す上位数件に入っていない
多段ランキングという設計
この3つに個別に対処するのではなく、検索パイプライン全体を段階に分けて設計するのが現在の主流です。Microsoftは Azure AI Search の公式ドキュメントで、この構造をL1からL3という段で整理しています。
L1は最初の候補取得です。テキストクエリはBM25、ベクトルクエリはHNSW(Hierarchical Navigable Small World)または全探索のKNN(K-Nearest Neighbor: k近傍法)で採点されます。複数のクエリを並列実行した場合は、RRF(Reciprocal Rank Fusion: 逆順位融合)でひとつの順位に統合されます。
L2がリランキングです。L1が返した結果に対して機械読解モデルを当て、クエリの意味に合うものを上位へ押し上げます。公式ドキュメントはL2をL1の代わりに使わない理由を明確に書いています。全文書にリランカーを当てるのは時間と費用の面で成立しないため、安価なL1で絞ってから高価なL2を当てる、という役割分担です。
L3は反復検索です。1回の検索では足りないとエンジンとLLMが判断したときに、2回目の検索を走らせます。Azure AI Search では agentic retrieval の中位の推論設定でプレビュー提供されています。
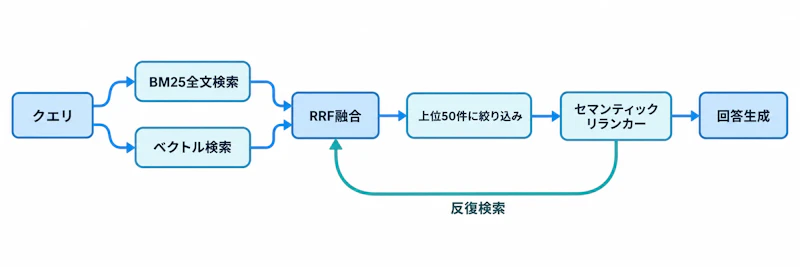
図1のように、検索は一直線ではなく並列と絞り込みと反復の組み合わせになります。以下、段ごとに具体的な改善策を見ていきます。
対策1、チャンキングの設計
チャンキングは文書を検索単位に分割する処理です。埋め込みモデルの入力上限を超えないためという説明をよく見かけますが、実務上はそれよりも「1つのベクトルで表現しきれない文書を細かくする」目的のほうが重要です。
上限の話も押さえておきましょう。text-embedding-3-small の入力上限は8,191トークンで、英語なら約6,000語に相当します。この範囲に収まる文書でも、複数の話題を含むページなら細かく割ったほうが検索は当たります。
推奨の初期値
Microsoftの推奨は、まず512トークン(約2,000文字)のチャンクに、25%すなわち128トークンのオーバーラップを付けるところから始める方法です。Text Split skill を使う場合の既定の推奨値も、最大2,000文字でオーバーラップ500文字となっています。オーバーラップは最大長の半分未満という制約があるので、極端な値は設定できません。
分割の粒度が結果にどう響くかは、公式ドキュメントが同じPDFで比較しています。
分割モード | 最大長 | オーバーラップ | チャンク数 |
|---|---|---|---|
pages | 1000文字 | 0 | 172 |
pages | 1000文字 | 200文字 | 216 |
pages | 2000文字 | 500文字 | 113 |
pages | 5000文字 | 0 | 34 |
sentences | 該当なし | 該当なし | 13,361 |
文単位で割ると13,361個という極端な数になり、1チャンクあたりの文脈はほぼ残りません。チャンクを小さくすれば検索が当たる、という思い込みは危険です。小さすぎるチャンクは単体で意味をなさず、埋め込みも曖昧になります。
文脈の欠落を防ぐ
固定長で切ると「当社」「同製品」といった指示語の参照先が失われます。対策として公式ドキュメントが挙げているのは、文書の中盤以降のチャンクに文書タイトルを付け足す方法です。Anthropicの文脈付与もこの発想の発展形で、各チャンクに元文書内での位置づけを短く書き添えてから埋め込みを作ります。これだけで上位20件の取りこぼしが5.7%から3.7%へ、35%削減されました。
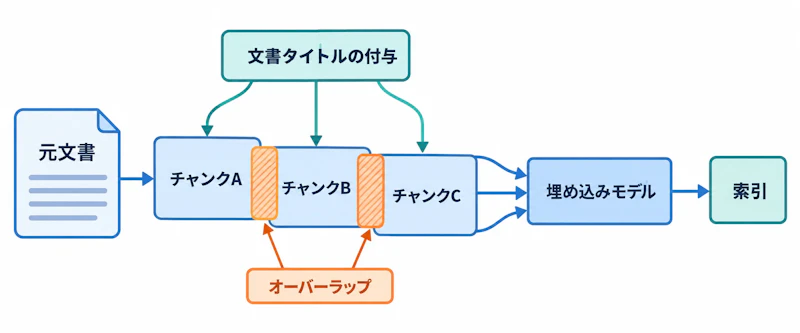
図2の構成では、隣接チャンクの重複部分とタイトル情報の2つが文脈の切れ目を埋めます。文脈をどう設計して渡すかという観点は、コンテキストエンジニアリングとは?プロンプトとの違いと圧縮・メモリ設計を解説でも扱っています。
対策2、ハイブリッド検索とRRF
ベクトル検索だけに頼る構成は、型番や人名、社内の略語といった文字列の完全一致で崩れます。埋め込みは意味の近さを測る仕組みなので、「XR-220」と「XR-221」を近いものとして扱ってしまうためです。一方BM25は語の一致には強いものの、「解約したい」と「退会の手続き」のような言い換えには届きません。
ハイブリッド検索は、同じクエリ文字列をそのままBM25へ、ベクトル化してベクトル検索へと並列に投げて結果を統合します。公式ドキュメントの表現を借りれば、両者を併用することで単独運用時の弱点を打ち消し合う構図です。
RRFはスコアではなく順位を足す
統合に使われるRRFの計算は単純です。各検索結果でその文書が何位だったかを見て、1/(rank + k) を割り当て、全リストぶんを合計します。kは定数で、実験上は60のような小さい値が最も良い結果になるとされています。
ここで押さえておきたいのは、RRFが生スコアではなく順位だけを使う点です。BM25の上限なしのスコアとベクトル検索の0.333から1.00のスコアは、そのままでは足し合わせられません。順位に変換してから合算することで、尺度の違う検索結果を無理なく混ぜられます。なお、RRFのkはベクトル検索で「上位何件取るか」を指定するkとは別物なので混同しないよう注意してください。
並列実行の数え方も実装時に効いてきます。全文検索1本とベクトルクエリ1本なら2回、ベクトルクエリが2つのベクトルフィールドを対象にするなら3回、全文検索1本とベクトルクエリ2本で5フィールドを対象にすると11回の実行になります。RRFスコアの上限は融合するクエリ数で決まり、1クエリあたり最大およそ 1/k ぶん寄与するため、クエリ数が増えるほどスコアの絶対値も大きくなります。
重み付けで寄り方を調整する
テキスト寄りかベクトル寄りかは、ベクトルクエリへの重みで調整できます。既定値は1.0で、0.5にすればそのベクトル結果の影響が半分に、2.0にすれば2倍になります。日本語の社内文書のように表記ゆれが多い場合はベクトル寄り、法令や仕様書のように用語が固定されている場合はテキスト寄りが効きやすい傾向があります。
再現率の設定も忘れがちです。全文検索側は既定で最大1,000件までしか候補を探さず、1,000件に達した時点で探索を止めます。母集団を広げたい場合は maxTextRecallSize を引き上げます。
対策3、リランキング
ハイブリッド検索で候補が揃っても、LLMに渡すのは上位数件です。ここで効くのがリランキングで、クエリと文書を一緒にモデルへ入力して関連度を採点し直します。Azure AI Search のセマンティックランカーは、Bingと Microsoft Research 由来の多言語モデルを使い、BM25またはRRFで並べ替えられた結果を再採点します。
効果は検索実験でも確認できます。Anthropicの構成では上位150件を取得してからリランカーで上位20件へ絞り、取りこぼしを2.9%から1.9%まで下げました。渡すチャンク数は20件が5件や10件より良い結果だったとも報告されています。広く取ってから絞るのがリランキングの基本形です。
見落としやすい制約
リランカーは全文書を見直してくれる仕組みではありません。Azure AI Search の場合、L2に進むのはL1の上位50件だけで、51位以下の正解は永久に拾われません。つまりL1の再現率を確保してからでなければ、リランカーを足しても効果は出ません。
入力長の制約もあります。要約モデルは1文書あたり最大2,000トークンを受け取り、セマンティック構成に指定した title(128トークン)、keywords(128トークン)、content(残り)の順に組み立てます。長すぎる文字列は切り捨てられるため、フィールドは優先度順に並べる必要があります。リランカーへ渡される要約文字列の上限は2,048トークンです。
クエリ側の工夫も用意されています。クエリ書き換えを有効にすると、誤字修正や同義語による言い換えを含む最大10通りのクエリ変種が生成され、それぞれの結果がBM25またはRRFで採点されたうえでリランカーに渡ります。
スコアの範囲を取り違えない
閾値を設けて低品質な結果を捨てる実装はよくありますが、手法ごとにスコアの範囲が違うため、ここを誤ると大量の取りこぼしや的外れな回答を招きます。
スコア | 範囲 | アルゴリズム |
|---|---|---|
@search.score | 0から上限なし | BM25(全文検索) |
@search.score | 0.333から1.00 | HNSWまたは全探索KNN(コサイン類似度) |
@search.score | 0からクエリ数で決まる上限 | RRF(ハイブリッド) |
@search.rerankerScore | 0.00から4.00 | セマンティックランキング |
リランカーのスコアは意味が定義されています。4.0は質問に完全に答えている、3.0は関連するが詳細が足りない、2.0は部分的に答えている、1.0はごく一部に触れている、0.0は無関連です。閾値を決めるならこの基準が使えます。ただしスコア分布はインフラ条件やモデル更新で多少動くため、細かすぎる閾値は避けるよう公式も注意しています。
BM25のスコアも絶対値で比較してはいけません。シャード単位で統計量が計算されるため、同じ文書でも配置されたシャードが違えばスコアが変わります。全シャード横断で採点したい場合は scoringStatistics=global を指定できますが、性能面の代償があります。
ハイブリッドかつセマンティックなクエリは、実際には次のような形になります。
{
  "search": "cloud formation over water",
  "vectorQueries": [
    {
      "kind": "text",
      "text": "cloud formation over water",
      "fields": "text_vector,image_vector"
    }
  ],
  "queryType": "semantic",
  "semanticConfiguration": "my-semantic-configuration",
  "select": "title,chunk",
  "top": 5
}
同じ文字列を search と vectorQueries の両方に渡す点がハイブリッドの要です。レスポンスにはRRF由来の @search.score とリランカー由来の @search.rerankerScore が別々に返るので、どの段で順位が入れ替わったのか切り分けられます。
改善の進め方
手法を全部入れれば良いというものではありません。コストと効果を考えると、次の順で検証するのが現実的です。
- 失敗したクエリを50件ほど集め、正解チャンクが何位にいたか調べる
- 圏外ならチャンク設計とL1の再現率を直す。順位が低いだけならリランキングを足す
- ハイブリッド検索を入れ、ベクトルの重みを振って最適点を探る
- フィールド重みや鮮度といった業務ルールはスコアリングプロファイルで加える
リランキングは従量課金の機能なので、効く場面を見極めてから入れたほうが無駄がありません。公式ドキュメントも、情報量が多く文章として書かれたナレッジベースや製品ドキュメントで効果が大きいと述べています。短いラベルや表形式のデータが並ぶ索引では、投資対効果は下がります。
結局のところ、RAGの精度改善は「正解がどの段で落ちているか」を特定する作業です。チャンキング、ハイブリッド検索、リランキングはそれぞれ別の落ち方に対応する道具なので、原因を見ずに導入しても期待した効果は得られません。