 AI-Papers
- VLM事前学習に深度マップ生成タスクを組み込み、3D空間・物理理解を強化するフレームワーク「GEM」を提案。LIBEROベンチマークで平均96.1%の成功率を達成した
- グラウンディング・空間推論・計画データ約400万件で構成する大規模データセット「GEM-4M」を構築し、研究者向けにGEM-250K(25万件)サブセットを公開
- 実世界ロボット実験で成功率43%を達成し、従来手法(28.7%)を大きく上回る。衣類の折り畳みや長時間タスクにも対応
研究の背景と課題
近年、大規模な言語・視覚モデル(VLM)を活用して、テキスト指示に従ってロボットが行動する「Vision-Language-Action(VLA)」モデルの研究が急速に進んでいます。しかし既存のVLMは主にテキストと画像の対応関係から学習しており、物体の3D的な位置関係や物理的な操作感覚を理解する能力が不足しています。
この問題は「意味理解と物理理解のギャップ」として知られています。たとえばテキスト指示「コップを棚に置いて」を理解することと、実際に手先の位置を3D空間内で正確に制御することは、モデルが求められる能力として大きく異なります。NEO-ovのようなネイティブ統合マルチモーダルモデルも視覚情報の構造的な扱いに取り組んでいますが、ロボット操作に特有の空間・物理理解をVLMへ効率的に組み込む手法はまだ十分に確立されていませんでした。
GEMのアーキテクチャ
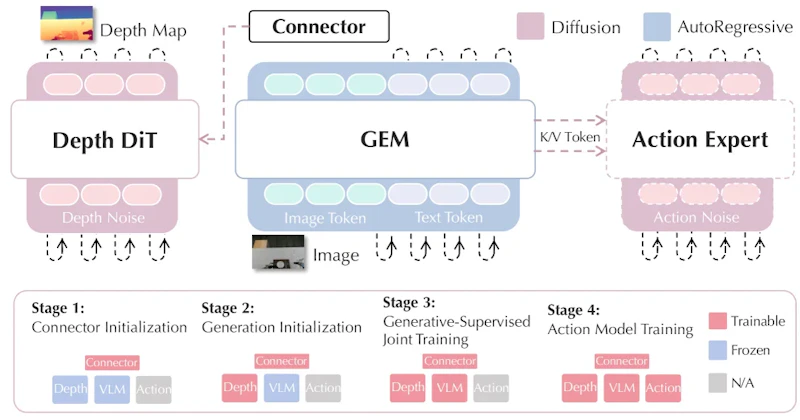
GEM(Generative Embodied Model)は、VLMバックボーン(Qwen3-VLを採用)に深度マップ生成モジュールを付加したフレームワークです。深度マップとは、カメラから各ピクセルまでの距離を2D画像として表現したもので、シーンの3D構造を直接反映します。
深度生成には、DiT(Diffusion Transformer)ベースのモジュールが使われます。このモジュールはVLMの最終層から得られる視覚的な特徴量を条件として受け取り、フロー・マッチング(ランダムなノイズを段階的に正確な深度分布へ変換していく生成モデルの手法)によって高精度な深度マップを生成します。軽量な2層MLPがコネクタとして両者を橋渡しします。
訓練は以下の4段階で段階的に進みます。
- Stage 1: コネクタのみを最適化(500ステップ)
- Stage 2: 深度生成モジュールをウォームアップ(4,000ステップ)
- Stage 3: モデル全体をエンドツーエンドで共同訓練(1エポック)
- Stage 4: アクション予測モジュールを、前の状態から順番に次の行動を予測する形式(自己回帰的)で訓練
GEM-4Mデータセット
GEMの訓練には、新たに構築した大規模データセット「GEM-4M」が使用されます。名称の「4M」は約400万件という規模を表しており、高品質な深度マップの教師信号とペアになった以下の3カテゴリで構成されています。
- 具体化グラウンディング: 物体のどこをどう操作できるかを判断するアフォーダンス認識や位置特定のQAペア
- 空間推論: 物体間の距離・方向・サイズなど3D空間的な理解を問うQAペア
- 時空間計画: タスク完了の確認や次ステップの予測など、行動計画に関するQAペア
研究者向けには25万件のサブセット「GEM-250K」が公開されています。内訳は具体化グラウンディング約10万件、空間推論約10万件、時空間計画約5万件で、公開データだけでも手法の再現・検証が可能です。
実験結果
GEM-VLA(GEMをVLAとして実装したモデル)は、シミュレーションと実世界の両方で幅広く評価されています。
シミュレーションベンチマーク「LIBERO」では、4種類のタスク全体で平均96.1%の成功率を達成し、従来手法を大きく上回りました。また「Simpler WidowX」ベンチマークでも平均67.0%の成功率で最高性能を記録しています。
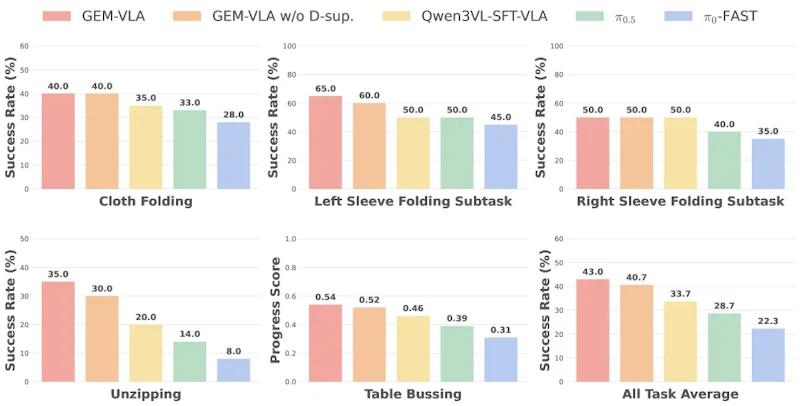
実世界ロボット実験では、テーブルの片付け(長時間タスク)・衣類の折り畳み・バックパックのジッパー開閉という3種類の難易度の高いタスクで評価が行われました。GEM-VLAは平均成功率43%を達成し、従来手法の28.7%を大きく上回っています。
空間推論ベンチマーク「VSI-Bench」では、2Bパラメータモデルで50.4→62.8ポイント、8Bモデルでは57.9→70.6ポイントへ大幅に改善しました。深度マップ生成の補助学習が、ロボット制御だけでなく汎用的な空間推論能力の向上にも寄与することが確認されました。
まとめと今後の展望
GEMは、生成モデルの学習目標をVLAの事前訓練に組み込むという新しいアプローチを提案しています。テキスト指示への対応能力を保ちながら、深度マップ生成という具体的なタスクを通じて3D空間・物理理解を同時に強化できる点が最大の特徴です。
課題としては、深度生成モジュール追加による計算コストの増加や、実世界での成功率(43%)にまだ改善の余地がある点が挙げられます。一方で大規模な公開データセット(GEM-250K)と段階的訓練パラダイムの提案により、研究コミュニティがこの方向性をさらに発展させるための基盤が整っています。生成モデルとロボット制御を橋渡しする訓練フレームワークとして、今後の応用が期待されます。
論文情報: "GEM: Generative Supervision Helps Embodied Intelligence"(Ruowen Zhao et al., 2026) arXiv:2605.28548
本記事の図(図1〜図2)は解説のため上記論文より引用しています。


