 AI-Papers
- Diffusion Transformerの推論を再学習なしに最大3.52倍高速化
- 早期ステップで粗いパッチ、後期ステップで細かいパッチを動的に割り当て
- FLUX-1.DevとWan 2.1の両方で品質を維持したまま大幅な高速化を実現
研究の背景
Diffusion Transformer(DiT)は画像や動画生成において最先端の性能を示していますが、計算コストの高さがリアルタイム応用の障壁となっています。従来のDiTsは、ノイズ除去の全ステップにわたって固定サイズのパッチを使用します。しかし、ノイズ除去の段階によって必要な情報の粒度は異なります。早期段階では大まかな構造の形成が主な目的であり、細かい詳細は後期段階で洗練されます。
この観察に基づき、研究チームは「すべてのノイズ除去ステップで同じパッチサイズを使う必要はない」という仮説を立てました。必要に応じてパッチサイズを動的に調整することで、計算量を削減しながら生成品質を維持できる可能性があります。
DDiTの提案手法
DDiT(Dynamic Diffusion Transformers)は、ノイズ除去の各タイムステップにおいて、早期ステップでは粗いパッチ(大きいパッチサイズ)を、後期ステップでは細かいパッチ(小さいパッチサイズ)を動的に使い分けます。この戦略により、大域的構造の形成には少ないトークンを割り当て、細部の洗練には多くのトークンを配分できます。
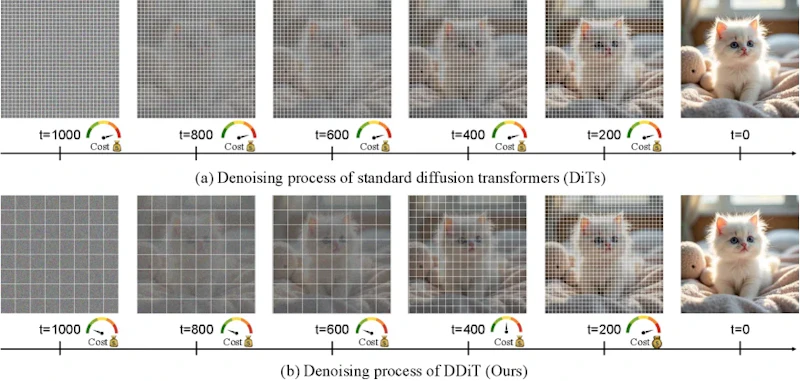
DDiTの核心的な仕組みは、各タイムステップにおける潜在表現の複雑さを評価し、その結果に基づいてパッチサイズを自動決定することにあります。具体的には、ノイズ除去の加速度を計測し、パッチ内の標準偏差を計算することで、そのタイムステップに必要な空間解像度を推定します。この推定値が閾値を下回る場合、より大きなパッチサイズに切り替えてトークン数を削減します。
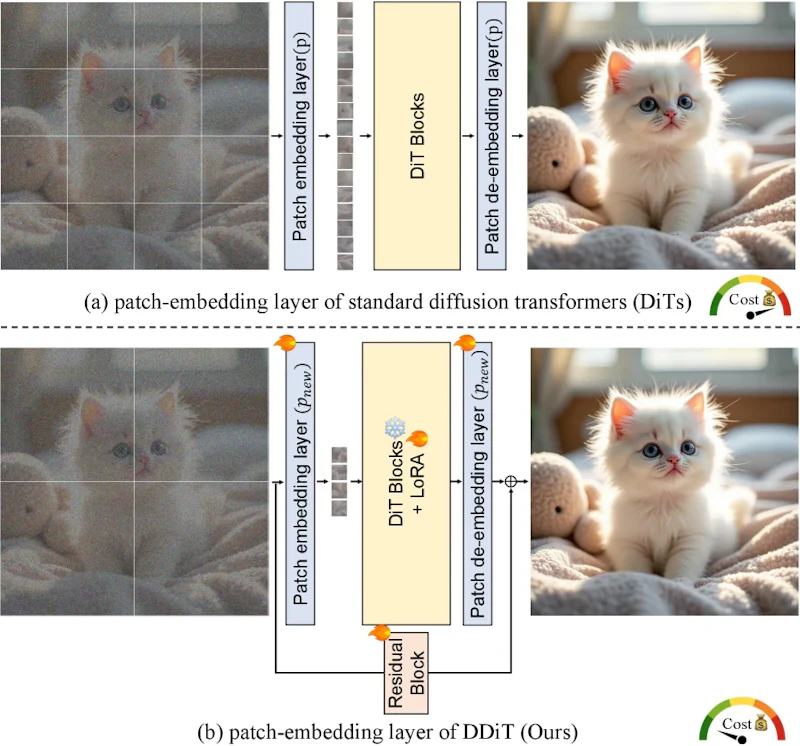
この手法を実装するには、パッチ埋め込み層を複数のパッチサイズに対応するよう拡張する必要があります。図2に示すように、標準的な固定パッチサイズpの埋め込み層に加えて、2pや4pといった大きなパッチサイズにも対応できるよう、重みを適切に初期化・共有する仕組みが導入されています。
実験結果と性能検証
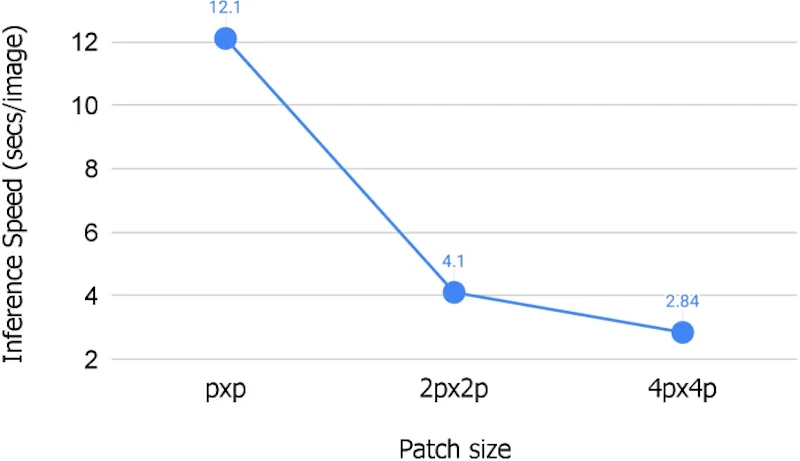
FLUX-1.Devを用いた実験では、DDiTは最大3.52倍の推論高速化を達成しました。図3に示すように、パッチサイズを大きくすることでトークン数が二次的に減少し、計算量が大幅に削減されます。重要なのは、この高速化がモデルの再学習を一切必要とせず、推論時の動的スケジューリングのみで実現される点です。
既存の高速化手法であるSpargeAttention2と比較して、DDiTはパッチサイズという異なるアプローチで効率化を図ります。TeaCacheやTaylorSeerといった従来のキャッシュベース手法と比較しても、DDiTは細かいディテールやポーズ、空間レイアウト、色分布をより忠実に保持します。
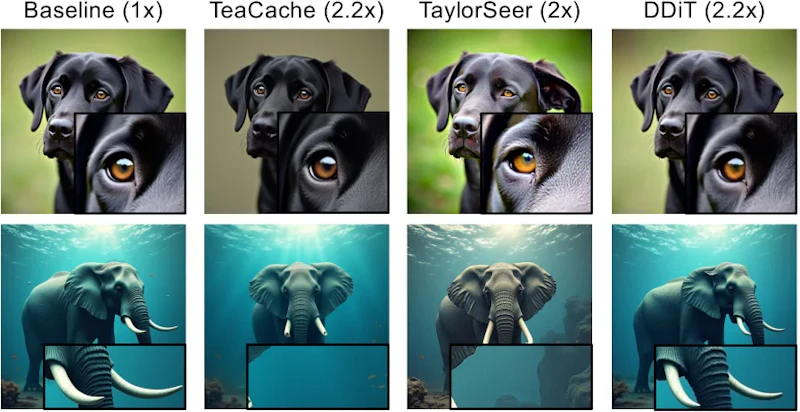
DrawBenchを用いた定性評価では、図4に示すように、DDiTは同等の高速化レベルでベースモデルに匹敵する視覚品質を維持しています。複雑なプロンプトや細かいテクスチャが要求される場合でも、DDiTは意味内容の深い理解を必要とするシーンで堅牢性を示しました。
実用性と今後の展望
DDiTの最大の利点は、既存のDiffusion Transformerモデルに対して再学習なしで適用できる点です。FLUX-1.DevやWan 2.1といった事前学習済みモデルに対し、パッチ埋め込み層の拡張とスケジューリングロジックの追加のみで高速化を実現できます。GitHubでコードが公開されているため、実装の再現性も高く、すぐに実用環境に導入できます。
今後の展望としては、動的パッチスケジューリングの最適化アルゴリズムのさらなる洗練や、テキスト-動画生成への本格的な適用、さらには3D生成タスクへの拡張が考えられます。また、他の高速化技術(アテンション機構の最適化やキャッシング戦略など)との組み合わせにより、さらなる推論効率の向上が期待されます。
まとめ
DDiTは、Diffusion Transformerの推論効率を大幅に向上させる実用的な手法です。早期ノイズ除去ステップでは粗いパッチで大域構造を形成し、後期ステップでは細かいパッチで詳細を洗練するという、ノイズ除去プロセスの特性を活かした動的スケジューリングにより、再学習なしで最大3.52倍の高速化を実現しました。既存モデルへの適用が容易で、コードも公開されているため、推論コストの削減を求める実用環境への導入が期待されます。
論文情報: "DDiT: Dynamic Patch Scheduling for Efficient Diffusion Transformers"(Dahye Kim, Deepti Ghadiyaram, Raghudeep Gadde, 2026) arXiv:2602.16968
本記事の図(図1〜図4)は解説のため上記論文より引用しています。

