 AI-Papers
- Ai2が約150名の研究者と88〜1024GPU規模のクラスタを対象に、優先度ベースのスケジューラをGPU時間の予算制へ移行した
- 最小実行時間(上限8時間)を宣言する「スケジューリング契約」と階層型フェアシェアを組み合わせ、割当分の98%を実際に配分した
- デバッグ用ジョブの待ち時間P90は2時間から30秒へ、人手を介するホスト修復は74%減少した
需要が供給の2〜3倍
Allen Institute for AI(Ai2)のAIインフラチームが、社内GPUクラスタのスケジューラを再設計した経緯と実測値をHugging Face上で公開しました。対象はNVIDIA H100、B200、B300で構成される88〜1024GPUのクラスタ群で、利用者は約150名の研究者です。
ワークロードはLLM・VLMの学習、ロボティクスの強化学習シミュレーション、科学分野のエージェント的ポストトレーニングと幅広く、いずれの時点でも利用可能なGPUの2〜3倍の要求が積み上がっていました。計算資源が常に足りない状況で、誰にどれだけ配るかという問題が運用の中心になっていたわけです。
優先度制が崩れた理由
旧方式では、チームごとに同時利用できるGPU数の上限を設け、その範囲内のワークロードはプリエンプション(実行中ジョブの強制停止)から保護される仕組みでした。上限を超える分はプリエンプション可能な扱いで、空いているGPUに載せられました。
この設計は複数の形で破綻します。デバッグ用のジョブをすぐに起動できないため、研究者は何もしないワークロードをGPU上に居座らせ、必要なときに接続する「GPUの場所取り」を覚えました。さらに優先度のインフレが進み、最終的にスケジュールされるワークロードの100%がHIGH優先度を指定する状態に至り、優先度という仕組み自体が機能を失いました。
運用担当者の負担も大きく、オンコール対応の大半は、不調なホスト上で動く保護されたジョブの停止をユーザーと交渉する作業に費やされていたといいます。個々のチームが自分の成果を最適化する一方、インフラチーム側の手当て(特定チームへのGPU専有割当)は研究の季節性によってGPUを遊ばせる結果を招きました。
スケジュールではなく予算を配る
新方式の中核は、GPUそのものを割り当てるのをやめ、GPU時間のシェアを予算として配るという転換です。経営層は総容量に対する割合(例えばあるプロジェクトに35%)という形で研究活動へ投資を行い、その配分は階層的に細分化されます。プロジェクト内はリード研究者が、プログラム内の複数プロジェクトは主任研究員が、プログラム間はリードプログラムマネージャーまたはCEOが配分を決めます。
保護されたいワークロードは必ずどこかの予算から支払われます。スケジューラを騙そうとしても、その分は自分の配分を食いつぶすため、場所取りの動機が消える構造です。
配分の執行には階層型フェアシェアを使います。既定で過去7日間のスライディングウィンドウで占有実績を集計し、割当に対して使い足りていないワークロードを使い過ぎのものより前に並べます。アルゴリズム自体はHadoop Fair SchedulerやSLURM Fair Tree、YARN Fair Schedulerと同系統で、新しいのは入力側です。ツリー構造が研究プログラムの組織構造をそのまま写し、重みはマネージャーが決めた予算になっています。GPUメモリの見積もりという観点はLLMのVRAM必要量とは?計算式と推論・学習別のGPU選び方を解説でも扱っていますが、ここで問題になるのは時間軸の配分です。
最小実行時間という契約
利用者側の約束事として導入されたのが「スケジューリング契約」です。ワークロードを投入する際、最小実行時間を宣言します(上限8時間)。
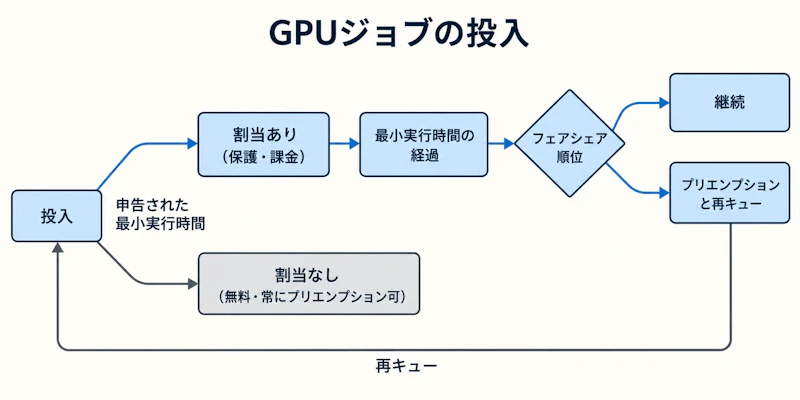
図1のように、最小実行時間の間はプリエンプションから保護され、その時間は自分の配分に課金されます。経過後も、フェアシェアの順位が他より上であれば実行を続けられますが、順位が下がればプリエンプションされ、再開可能なワークロードは自動で再キューされます。これがタイムスライシングとして働きます。
最小実行時間をゼロに設定すると、その時間は配分外(unallocated)となり、課金されない代わりに常にプリエンプション対象になります。デバッグや試し打ちはこの枠を使えば待たずに走り、資金のついた仕事が来れば即座に譲る形です。優先度という概念は残っていますが、同一チーム内の並び替えにしか効きません。
30日間の実測値
展開後30日間の計測では、各チームは配分されるべきGPU時間の98%を実際に受け取りました(実需要で上限を切った値で測定)。15のチーム割当のうち13が95%以上を受け取り、最も低いものでも90%でした。
指標 | 移行後 | 移行前 |
|---|---|---|
デバッグジョブの待ち時間P90 | 30秒 | 2時間 |
最大H100クラスタの待ち時間中央値 | 24秒 | 5分 |
同クラスタの待ち時間P90 | 1.8時間 | 2.8時間 |
人手を介するホスト修復 | 74%減 | 基準 |
占有率 | 98% | 98% |
占有率は移行前後とも98%で、需要が供給の2〜3倍という条件も変わっていません。配分された時間のうち18%は配分外の枠で、資金のついた仕事が立ち上がっていない間もGPUを回す役割を果たしました。修復作業の削減は、ワークロードが最小実行時間に達するたび不調なホストが自動的に空いていくためです。事前に作ったシミュレータはデバッグジョブのP90を約6時間から5分と予測していましたが、実測はそれを上回りました。
残る課題
移行には摩擦もありました。クラスタごとに段階的に切り替えたため挙動が一貫せず、「優先度」のような既存の用語が意味を変えたことも混乱を生みました。文書よりも、実例を示す説明会のほうが理解に効いたと報告されています。
8時間という保護の上限は、長時間維持したい対話的な開発セッションと相性が悪く、データ前処理向けのCPU専用クラスタや復元可能なセッションの提供が計画されています。最小実行時間の保護によって非常に大きなジョブ用の空きを作りにくくなる容量断片化も調査中です。チームが次に見据える指標は、占有率ではなく実際の計算効率を表す稼働率で、起動処理やチェックポイント、学習コードの改善が対象になります。記事中では研究者の声として「計算資源が30%増えたように感じる」というコメントが紹介されています。


