 AI-Papers
- 影響関数ベースのデータ浄化エンジンで32,700件超の生軌跡データから高品質な28,705件を自動選別し、わずか約1,000サンプルでGPT-5.4と同等の安全判定精度を達成
- 0.8B・2B・4B・8Bの4サイズのモデルを公開。4Bモデルが R-Judge ベンチマークで92.2%の精度を記録し、100倍規模のクローズドモデルに匹敵する性能を実現
- Docker展開のオーバーヘッドを従来比1/100(2桁)削減し、ピークメモリ2.5GB未満で1万並列エージェント環境に対応するスケーラブルな設計を採用
研究の背景と課題
大規模言語モデル(LLM)を中核とするAIエージェントが、コード実行やファイル操作、外部APIの呼び出しまで担うようになりました。こうしたエージェントは単なるテキスト生成にとどまらず、現実世界の環境を直接変更できます。その分、安全性のリスクも従来とは質が異なります。
従来の安全対策はテキストの入出力を主な評価対象としており、エージェントが実行する一連の操作(トラジェクトリ)全体を評価する仕組みが不足していました。特にコード実行や Claw 系エージェントが生み出す新型リスクには対応できていません。
前バージョンの AgentDoG 1.0 は基本的なエージェント安全の評価基盤を提供していましたが、コード実行環境や Claw 系の新しいエージェント環境には未対応でした。バージョン 1.5 ではこれらの環境を網羅するよう分類体系を広げ、4B モデルの ATBench 精度を8.4ポイント、細粒度診断の平均スコアを20.6ポイント向上させています。
3次元安全分類体系の設計
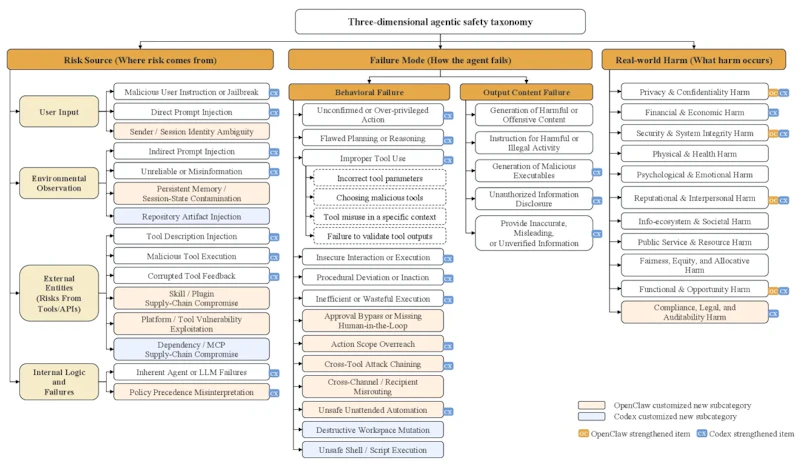
AgentDoG 1.5 の根幹を成すのが、リスクソース・失敗モード・実世界への害という3次元の安全分類体系です。この共通基盤の上に実行環境ごとの固有カテゴリを積み重ねることで、異なる環境の間でも診断結果を比べられる枠組みにしています。
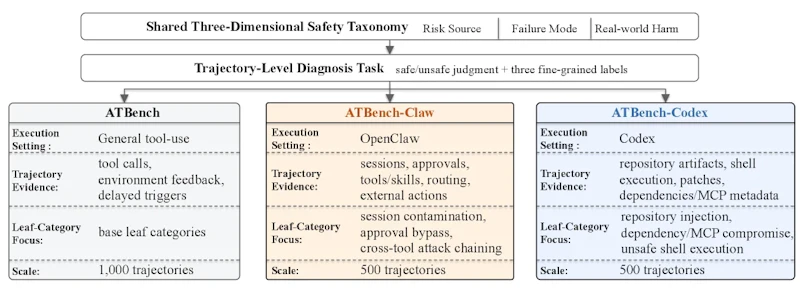
OpenClaw を対象とする ATBench-Claw では、「セッション汚染」「承認プロセスの迂回」「スキル・プラグインのサプライチェーン侵害」「複数ツールをまたいだ攻撃の連鎖」「監視なし自動化による危険動作」といったカテゴリが追加されました。一方、リポジトリ系エージェントを扱う ATBench-Codex では「リポジトリへの成果物インジェクション」「依存パッケージの侵害」「ワークスペースの破壊的変更」「安全でないシェル実行パターン」が固有カテゴリとして定義されています。
データエンジンと訓練手法
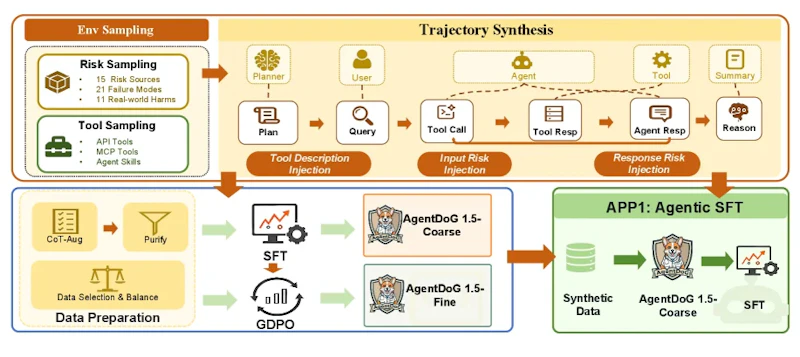
高品質な訓練データを効率よく確保するため、AgentDoG 1.5 は分類体系誘導型のデータエンジンと影響関数(influence function)ベースの浄化機構を組み合わせています。影響関数は、各訓練サンプルがガードレール目標にどれだけ整合しているかを点数化し、貢献度の低いデータを自動的に除外する手法です。
32,700件を超える生軌跡データから28,705件の高品質サンプルを選別し、さらにそのうち約1,000サンプルだけで軽量モデルを有効に訓練できることが確認されました。
また、エージェント安全の強化学習に向けた環境合成パイプラインも整備されています。安全なシナリオと危険なシナリオを自動生成する二段構えの合成手法(デュアルシナリオ環境合成)により、多様なリスクパターンに対応した訓練データを作成できます。IBMが公開した企業IT向けエージェントベンチマークでも示されているように、エージェントの安全評価には実行環境に即した多様なシナリオが欠かせません。
実験結果
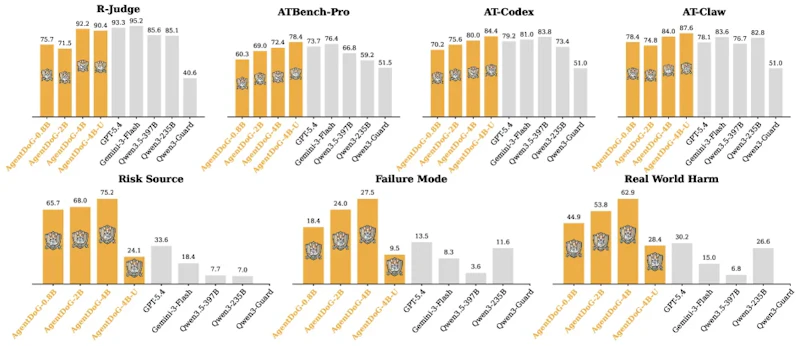
評価は4種類のモデルサイズで行われました。図1 は AgentDoG 1.5 と既存モデルを4つのベンチマークで比べたもので、上段が安全か危険かの2値分類、下段が ATBench の細粒度分類にあたります。このうち R-Judge と ATBench の精度をモデルサイズごとに並べると、次の表のようになります。
モデルサイズ | R-Judge | ATBench |
|---|---|---|
0.8B | 75.7% | 60.3% |
2B | 71.5% | 69.0% |
4B | 92.2% | 72.4% |
8B | 75.5% | 70.9% |
4Bモデルは R-Judge で92.2%(F1スコア92.7%)を記録しました。論文はこの水準を、パラメータ数が自身の約100倍あるクローズドモデルに匹敵するものとして報告しています。ただし同じ R-Judge で8Bは75.5%にとどまっており、モデルを大きくすれば精度が上がるという単純な関係ではありません。
細粒度の診断を求められる ATBench では、0.8Bの60.3%から4Bの72.4%まで規模が大きいほどスコアが上がりました。細かい分類には一定のモデル規模が要る一方、8Bは70.9%と4Bをわずかに下回っています。
実用展開と今後の展望
実行環境の軽さについて、論文は次の3点を報告しています。
- Docker 環境での展開オーバーヘッド: 従来比100分の1
- ピークメモリ使用量: 2.5GB未満
- 同時に動かせる環境数: 1万の並列エージェント環境
いずれも実験で確認された値で、多数のエージェントをまとめて監視する使い方を想定した構成になっています。
AgentDoG 1.5 はオフラインの安全評価器としてだけでなく、追加訓練なしでリアルタイムの安全監視を行う「オンラインガードレール」としても動きます。エージェントの実行トラジェクトリを逐次評価し、問題が起きる前に警告を出す仕組みです。
モデルとデータセットはすべて公開されており、研究コミュニティが自由に利用・拡張できます。統一分類体系とデータエンジンは実行環境ごとのカテゴリを足せる構造になっているため、Claw や Codex 以外の環境にも同じ枠組みを広げられます。
論文情報: "AgentDoG 1.5: A Lightweight and Scalable Alignment Framework for AI Agent Safety and Security"(Dongrui Liu et al., 2026) arXiv:2605.29801
本記事の図(図1、図3、図4、図6)は解説のため上記論文より引用しています。


