 AI-Papers
- トークナイザーはLLMがテキストを処理可能な単位(トークン)に分割する仕組みで、API料金はトークン数で決まる
- BPE(Byte Pair Encoding)は頻出する文字列を段階的にマージしてトークンを生成し、GPT・Llama・Gemmaなど主要LLMで採用されている
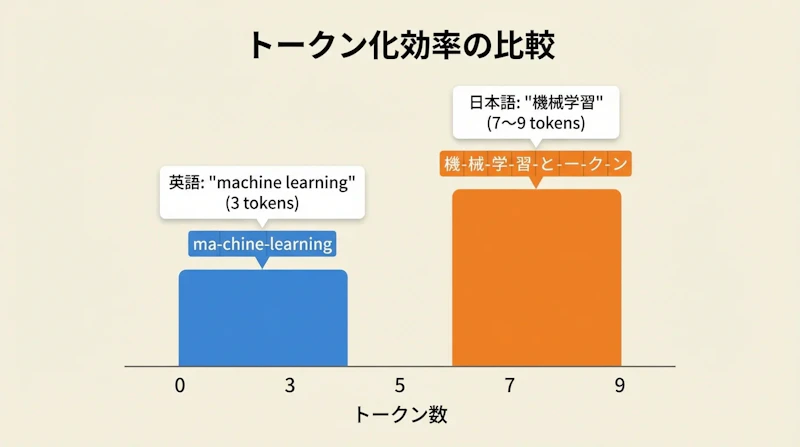
- 日本語は英語より約2倍のトークンを消費するため、同じ文字数でもAPI料金が高くなる傾向がある
トークナイザーとは何か
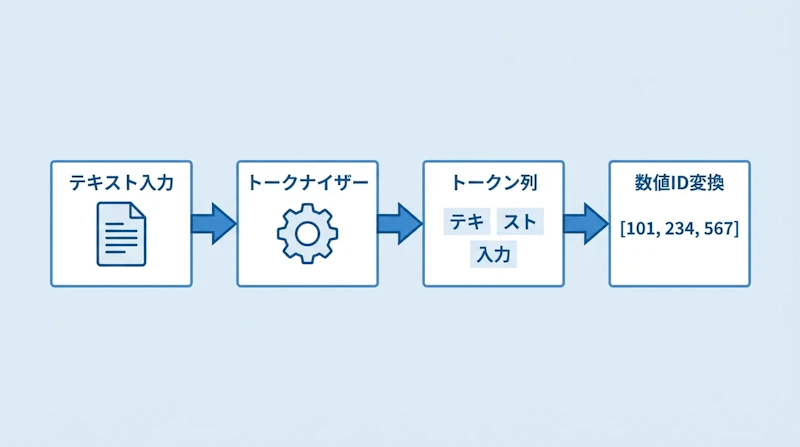
トークナイザー(Tokenizer)とは、テキストをLLM(大規模言語モデル)が処理できる単位に分割し、数値IDに変換するプログラムです。人間が読む文章をそのまま機械学習モデルに入力することはできないため、トークナイザーが「トークン」と呼ばれる小さな単位に分解し、それぞれに番号を付けることでLLMが理解できる形式に変換します。
例えば「annoyingly」という単語は、トークナイザーによって["annoying", "ly"]や["annoy", "ing", "ly"]のように分割されます。この分割方法は使用するアルゴリズムや語彙セットによって異なりますが、いずれも「よく使われる単語はそのまま1トークン、珍しい単語は小さなサブワードに分割」という基本原則に従います。
トークナイザーは単なる前処理ツールではありません。ChatGPTやClaudeなどのLLM APIでは、利用料金がトークン数で決定されるため、同じ内容でもトークナイザーの性能次第でコストが大きく変わります。特に日本語を扱う場合、この影響は顕著です。
なぜトークンが必要なのか
LLMがトークンという単位を使う理由は、計算効率と柔軟性のバランスにあります。仮にすべての単語を個別に登録する「単語レベルトークナイゼーション」を採用すると、語彙数が膨大になり、計算コストが爆発的に増加します。一方、一文字ずつ処理する「文字レベルトークナイゼーション」では、単語としての意味のつながりを捉えにくくなります。
トークンはこの中間に位置し、頻出する単語は1トークンのまま保持し、珍しい単語や造語は既知のサブワードの組み合わせで表現します。この仕組みにより、LLMは限られた語彙サイズで多様な表現に対応でき、学習データに存在しない新しい言葉(例:「ChatGPTる」)も適切に処理できるのです。
BPE(Byte Pair Encoding)の仕組み
BPE(Byte Pair Encoding)は、現在最も広く使われているトークナイゼーションアルゴリズムです。GPT-5、Llama 4、Gemma 4など主要なLLMで採用されており、シンプルながら効果的な圧縮が可能です。
BPEの基本動作
BPEは以下の手順でトークンを生成します。まず、テキストを空白やルールに基づいて単語に分割し、各単語の出現頻度を集計します。例えば以下のようなデータがあるとします。
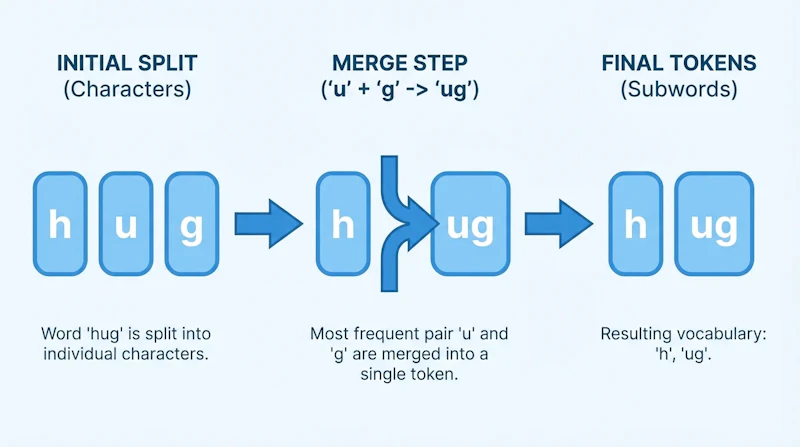
("hug", 10), ("pug", 5), ("pun", 12), ("bun", 4), ("hugs", 5)次に、すべての文字から基本語彙を作成します。この例では["b", "g", "h", "n", "p", "s", "u"]が基本語彙となり、各単語は文字に分解されます。
BPEは隣接する文字ペアのうち、最も頻繁に出現するものを探します。この例では「u」と「g」が"hug"、"pug"、"hugs"に現れるため、最頻出ペアとしてマージされ、"ug"が新しいトークンとして語彙に追加されます。
この処理を繰り返すことで、次は「u」と「n」がマージされて"un"が追加され、語彙は["b", "g", "h", "n", "p", "s", "u", "ug", "un"]に成長します。目標の語彙サイズに達するまでこのマージを続けることで、効率的なトークンセットが完成します。
バイトレベルBPE
標準的なBPEでは、基本語彙にすべてのUnicode文字を含める必要があり、語彙サイズが大きくなりすぎる問題があります。この解決策として、GPT-2で導入されたのが「バイトレベルBPE」です。
バイトレベルBPEは、文字ではなく256個のバイト値を基本語彙として使用します。これにより、どんな言語のどんな文字でも、必ず256個のバイトの組み合わせで表現できるため、未知文字トークン(<unk>)を完全に排除できます。GPT-2では256バイト + 50,000マージ + 特殊トークンで、合計50,257トークンの語彙を実現しました。
その他の主要アルゴリズム
Unigram
UnigramはT5、BigBird、Pegasusなどで採用されているアルゴリズムで、BPEとは逆のアプローチを取ります。まず大きな候補トークンセットから始めて、各トークンに確率スコアを付与し、スコアの低いトークンを段階的に削除していきます。
例えば"hugs"という単語は、["hug", "s"]、["h", "ug", "s"]、["h", "u", "g", "s"]など複数の方法でトークン化できます。Unigramはそれぞれの確率を計算し、最も尤度(もっともらしさ)が高い分割を選択します。BPEが決定論的なのに対し、Unigramは確率的であり、学習時に異なるトークン化をサンプリングできる特徴があります。
WordPiece
WordPieceはBERTファミリーのモデル(DistilBERT、Electraなど)で使用されるアルゴリズムです。BPEと似ていますが、ペアを選択する基準が異なります。BPEは単純に出現頻度が最も高いペアをマージしますが、WordPieceは学習データの尤度を最大化するペアを選びます。
具体的には、各ペアのスコアをfrequency("ug") / (frequency("u") × frequency("g"))で計算します。この方法により、単に頻繁に出現するだけでなく、統計的に意味のある単位が優先的にマージされます。
SentencePiece
SentencePieceはGoogleが開発したライブラリで、空白を特別扱いせず、生のテキストストリームとして処理します。空白文字を「▁」という記号で表現し、語彙に含めることで、日本語や中国語のように空白を使わない言語でも統一的に処理できます。
例えば「こんにちは」は"▁こんにちは"として処理され、デコード時には「▁」を空白に戻すことで元のテキストを再現します。この仕組みにより、多言語対応が容易になり、GoogleのGeminiシリーズなどで広く採用されています。
日本語とトークンの課題
日本語を扱う際、トークナイザーには特有の課題があります。最大の問題は、同じ文字数でも英語より多くのトークンを消費することです。これはAPI料金に直結する重要な問題です。
英語と日本語のトークン数比較
OpenAIのtiktokenで「Hello World!」を処理すると3トークンになりますが、「こんにちは、世界!」は14トークンに分割されます。日本語は漢字・ひらがな・カタカナという3種類の文字種を含み、UTF-8エンコーディングでは1文字が複数バイトになるため、バイトレベルBPEでは細かく分割されてしまうのです。
実際のビジネス文書でのトークン効率を実測した調査では、以下の結果が報告されています。
モデル | 1トークンあたりの平均文字数 |
|---|---|
GPT-5 | 1.17 |
Claude Sonnet 4.5 | 1.02 |
Gemini 2.5 Pro | 1.52 |
PLaMo 2.1 Prime | 1.85 |
Claude Sonnet 4.5では1トークン≒1文字という非効率な結果となり、日本語特化のPLaMo 2.1 Primeが最も効率的です。Gemini 2.5 Proも比較的良好で、語彙数の多いSentencePieceベースのトークナイザーが日本語に有利であることを示しています。
日本語トークナイザーの進化
この課題に対応するため、日本語に最適化されたトークナイザーの開発が進んでいます。PFNのPLaMoシリーズは、日本語・英語・プログラミング言語のいずれでも高い圧縮率を実現するトークナイザーを独自開発しました。
PLaMoのトークナイザーは単なる圧縮率だけでなく、「各トークンの生成難易度が偏らないこと」「モデル内部で重みを共有しやすい構造」「同じ語が一貫して同じトークン列で表されること」といった、LLMにとって学習しやすい分割を重視して設計されています。この結果、語彙数100kという比較的小さなサイズでありながら、高い効率を達成しています。
API料金とトークンの関係
ChatGPT、Claude、Geminiなどの主要LLMは、API利用料金をトークン数ベースの従量課金で設定しています。料金は「入力トークン」と「出力トークン」で異なり、通常は出力トークンの方が高額です。
実質コストの計算例
トークンあたりの料金は各社のWebサイトで確認できますが、実際のビジネスでは「文字あたりのコスト」の方が重要です。先ほどのトークン効率データを用いて、100万文字あたりの実質コストを計算すると以下のようになります(1ドル=150円換算)。
モデル | 100万文字あたり入力コスト | 100万文字あたり出力コスト |
|---|---|---|
GPT-5 | ¥159.81 | ¥1,278.52 |
Claude Sonnet 4.5 | ¥439.60 | ¥2,198.00 |
Gemini 2.5 Pro | ¥123.46 | ¥987.70 |
PLaMo 2.1 Prime | ¥32.43 | ¥135.13 |
同じトークン単価でも、実質コストには大きな差があります。Claude Sonnet 4.5はトークン効率が低いため、他モデルの約2倍のコストがかかります。一方、PLaMo 2.1 Primeは日本語に最適化されており、約1/4〜1/10のコストで済むことがわかります。
tiktokenでトークン数を確認する
OpenAIはトークン数を確認できるツール「tiktoken」をオープンソースで公開しています。これを使えば、実際にプロンプトを送る前にトークン数を見積もることができます。
import tiktoken

# エンコード
enc = tiktoken.get_encoding("o200k_base")  # GPT-5用
tokens = enc.encode("こんにちは、世界!")
print(len(tokens))  # トークン数を出力

# デコード
print(enc.decode(tokens))  # 元のテキストに戻す
tiktokenはBPEベースの高速トークナイザーで、同等のオープンソースツールより3〜6倍高速です。API利用前にトークン数を確認することで、予想外のコスト超過を防ぐことができます。
コスト最適化のコツ
API料金を抑えるためには、以下のポイントを意識しましょう。
- プロンプトは簡潔に:冗長な説明を避け、必要最小限の指示で済ませる
- プロンプトキャッシュを活用:同じシステムプロンプトを繰り返し送る場合、キャッシュ機能で入力トークンを削減
- 出力トークン数を制限:必要以上に長い回答を生成させない(max_tokensパラメータで制御)
- 日本語特化モデルを検討:日本語中心の用途ならPLaMoなど日本語に最適化されたモデルも選択肢
LLMを選ぶ際は、RAG vs ファインチューニング:コスト・精度・実装難易度で選ぶLLM最適化手法でも解説しているように、コストと精度のバランスを総合的に評価することが重要です。トークン効率だけでなく、出力品質やタスクとの相性も考慮に入れましょう。


