 AI-Papers
- Thinking Machines Labが総パラメータ2760億・アクティブ120億のMoE型オープンウェイトモデルをApache 2.0でHugging Faceに公開しました
- 従来版Inklingの約4分の1サイズながら、Humanity's Last ExamやSWE-bench Verifiedで上位モデルを上回る結果を示しました
- NVFP4量子化版では必要GPUメモリが180GBまで下がり、開発者が手元で動かせる実用性を備えています
概要
米OpenAIの元最高技術責任者(CTO)ミラ・ムラティ氏が率いるThinking Machines Labは、2026年7月30日(米国現地時間)にオープンウェイトモデル「Inkling-Small」を公開しました。ライセンスはApache 2.0で、モデル重みはHugging Faceからダウンロードできます。
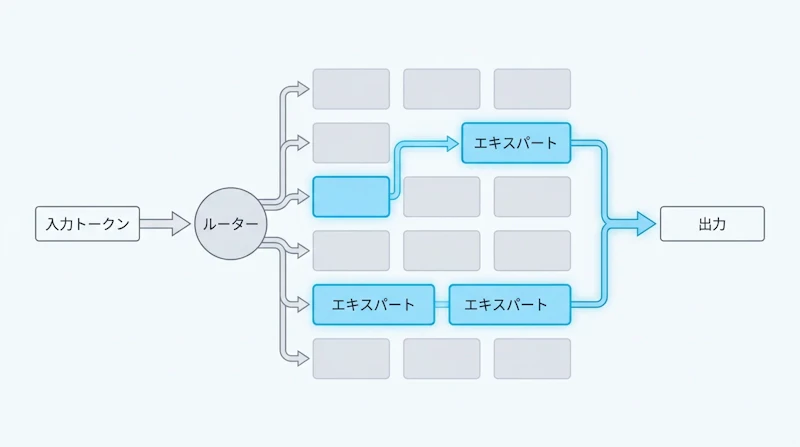
Inkling-Smallは総パラメータ数が2760億、実際の推論で動くアクティブパラメータ数が120億のMoE(Mixture-of-Experts)型Transformerです。MoEは入力ごとに一部の専門家(エキスパート)だけを使う仕組みで、モデル全体は大きくても計算コストを抑えられます。
同社の従来モデル「Inkling」の約4分の1というサイズながら、複数のベンチマークで上位モデルを上回った点が今回の発表の中心です。オープンウェイトモデルを巡ってはMoonshot AIのKimi K3など各社の競争が続いており、Inkling-Smallもその流れに加わる形となりました。
MoEで実現した軽量化
Inkling-Smallでは、入力トークンをルーターが受け取り、その内容に応じて少数のエキスパートだけを起動して出力を生成します。総パラメータは2760億ありますが、1回の推論で動くのは120億分に限られます。そのため、大規模モデルの知識量と軽量モデルの計算効率を両立できます。
学習にはNVIDIAのGB300 NVL72システムが使われました。マルチモーダルに対応し、音声と画像をネイティブに処理できるほか、コンテキストウィンドウは最大100万トークンに達します。
推論時の思考労力を調整できる仕組みも備えており、用途に応じて速度と精度のバランスを変えられます。
ベンチマークで上位を上回る
性能面では、難関問題を集めたHumanity's Last Exam、ソフトウェア開発能力を測るSWE-bench Verified、ターミナル操作を評価するTerminal-Bench 2.1の3つで、いずれも従来版Inklingを上回ったとしています。発表された数値は次のとおりです。
ベンチマーク | Inkling-Small | Inkling |
|---|---|---|
Humanity's Last Exam | 31.6% | 29.7% |
SWE-bench Verified | 80.2% | 数値の記載なし(Inkling-Smallが上回る) |
Terminal-Bench 2.1 | 64.7% | 数値の記載なし(Inkling-Smallが上回る) |
より小さいモデルが上位モデルを上回った背景には、学習プロセスの改良があります。Inkling-SmallはInklingより後に学習されたため、事前学習データの配合を見直し、プレビュー版を教師役に使うオンポリシー蒸留を実施しました。
さらに2週間かけて、エージェント型コーディングの強化学習をスケールさせています。
量子化で180GBまで削減
実用面で重要なのが必要GPUメモリの削減です。BF16チェックポイントは600GB以上を必要とし、B300を4基またはH200を8基で動かせます。Inklingでは2TB以上が必要だったため、大幅に下がりました。
数値の精度を落として軽量化するNVFP4量子化版では、必要メモリが180GB以上に下がります。これはB300を1基、あるいはH200を2基で動かせる水準で、Inklingの600GB以上から大きく削減されました。両モデルの必要メモリを次の表にまとめます。
形式 | Inkling-Small | Inkling |
|---|---|---|
BF16 | 600GB以上(B300×4基またはH200×8基) | 2TB以上 |
NVFP4量子化 | 180GB以上(B300×1基またはH200×2基) | 600GB以上 |
単一GPUに近い構成で動かせることは、多くの開発者にとって導入のハードルを下げます。
利用環境と今後
Inkling-Smallは、ブラウザ上でテキスト・画像・音声のチャットを試せる「Tinker Playground」で利用できます。ファインチューニングに対応した「Tinker」プラットフォームからも扱え、いずれも期間限定の割引価格で提供される予定です。
オープンウェイトかつApache 2.0という緩いライセンスで公開されたため、企業や研究者は独自の用途に合わせて改変・再配布しやすくなりました。上位モデルに迫る性能を、少ない計算資源で手元で動かすという選択肢が加わった形です。


