 AI-Papers
- 0.8Bから27Bまでの意思決定モデル群StartLux-Decisionが公開され、即答型のInstantと確信度に応じて推論を起動するAutoThinkの2系統を用意
- 強化学習手法RLCD²は、推論が確率の質を改善したときだけ報酬を与え、長すぎる推論に軟らかい罰則を課して平均長を最大65%削減
- Decision Index 0.3の公開サブセットで同規模のオープンモデルを7.4〜16.9ポイント上回り、27BのAutoThinkは73.4を記録
研究の背景
Large Language Model(LLM、大規模言語モデル)に判断を任せる場面が増えるにつれ、推論の使いどころが課題になってきました。思考の過程を長く書き出す推論モデルは難しい問題に強い一方で、簡単な判断にも時間と計算資源を費やしてしまいます。
意思決定タスクではもう一つの問題があります。正解か不正解かの二値だけでなく、どの程度の確信で判断しているかが実務では重要になる点です。確信度が実際の正答率と乖離していると、人間がどの判断を信用して良いか分からなくなります。
香港大学などの研究チームが発表したStartLux-Decisionは、この2つの問題を同時に扱おうとした試みです。判断の確信が高い場合は即答し、不確実な場合にだけ明示的な推論を起動する設計を採用しました。意思決定に特化したモデルという方向性は、選択肢の順序に左右されないSystem Oneモデル Jevaなど近年いくつか登場しており、本研究もその流れに位置づけられます。
提案手法
モデルは2系統に分かれます。Instant系は入力を1回通すだけで答えを返す単一パス推論を維持しつつ、全アテンション層で双方向アテンションを使うことで判断精度を高めています。生成タスクでは因果的(過去方向のみを見る)アテンションが必要ですが、判断を下すだけなら入力全体を双方向に見たほうが有利という考え方です。
AutoThink系はこのInstantを土台に、確信度に応じて振る舞いを切り替えます。確信の高いケースはそのまま答え、不確実なケースでは推論を書き出してから結論を出します。学習は3段階で、共通の判断能力を身につけたうえで2系統に分化させ、最後にAutoThinkへ推論能力を付与する流れです。
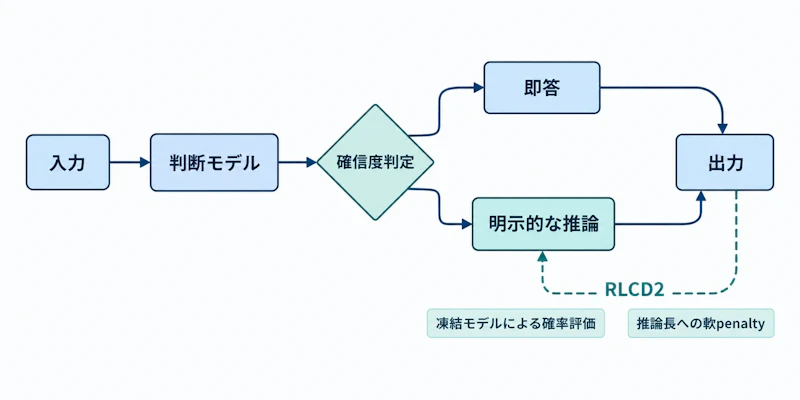
図1のように、推論部分の学習に使われるのが新手法のRLCD²(Reinforcement Learning for Calibrated Deliberative Decisions)です。凍結したモデルと proper scoring rule(確率予測の質を測る評価規則)を組み合わせ、推論を挟んだことで判断確率の質が実際に改善した場合にだけ報酬を与えます。推論すること自体ではなく、推論の効果に報酬を結びつける設計です。
あわせて、長くなりすぎた推論連鎖には軟らかい罰則をかけます。これにより生成上限内で推論を完走する割合が最大48ポイント向上し、平均推論長は最大65%短くなりました。論文によれば、判断精度はおおむね維持されています。
実験結果
評価には2つのベンチマークが使われました。1つは既存のDecision Index 0.3の公開サブセット、もう1つは研究チームが新たに構築したDecisionPivotです。DecisionPivotは、答えが変わる1点だけが異なる対比ペアからプログラムで検証可能な計算的判断問題を作る方式を採っています。細部の違いを見落とさないかを測る狙いです。
評価項目 | 結果 |
|---|---|
Decision Index 0.3(Instant、同規模オープンモデル比) | +7.4〜16.9ポイント |
Decision Index 0.3(27B AutoThink) | 73.4 |
DecisionPivot ペア精度(AutoThink対Instant) | +11.5〜18.4ポイント |
RLCD²による推論長削減 | 最大65%減 |
生成上限内で完走した推論の割合 | 最大48ポイント向上 |
DecisionPivotでAutoThinkがInstantを大きく上回った点は、明示的な推論が効くのは細かな差分を追う必要がある問題だという解釈を裏づけます。逆に言えば、確信度の高い問題で推論を省く設計が精度を犠牲にしていないことの間接的な証拠にもなっています。
まとめと今後の展望
StartLux-Decisionの重みは0.8Bから27Bまで公開され、推論基盤としてvLLM、llama.cpp、MLXに対応します。量子化版も用意されているため、手元のマシンで試せる範囲が広いのが実用面での強みです。
一方で課題も残ります。確信度に基づく切り替えは確信度の推定そのものが外れたときに脆く、確信を持って誤るケースでは推論が起動しません。Decision Index 0.3での27Bのスコア73.4という水準も、判断を任せきるには距離があることを示しています。
報酬を推論の効果に結びつけるRLCD²の発想は、意思決定以外の領域にも応用の余地がありそうです。推論の長さと質のバランスをどう設計するかは、推論モデル全般に共通する論点として今後も検証が重ねられていくでしょう。
論文情報: "StartLux-Decision: AutoThink Decision Models with Reinforcement Learning for Calibrated Deliberative Decisions"(Xialie Zhuang et al., 2026) arXiv:2610.17309


