 AI-Papers
- 直列テキストから答えを生成する現行の高速モデルが、決定問題の構造を無視している点を指摘し、4つの設計要件を定式化した論文です
- リクエストと選択肢を別々に符号化し、固定された選択肢メモリに対してリクエスト側だけを更新する構成で、順序不変とキャッシュ再利用を同時に成立させています
- BANKING77でのnull検出AUROC 98.66%、順序入れ替えによる判定反転ゼロ、キャッシュ利用時の中央値レイテンシ約28分の1を報告しています
研究の背景
分類や選択のように、考え込まずに即答すべき処理を担うモデルは「System One」モデルと呼ばれます。現在の実装の多くは、リクエストと選択肢の一覧を1本のテキストにつなげて言語モデルに入力し、答えをトークン列として生成する方式です。
この方式は手軽ですが、決定問題がもともと持っている性質と噛み合いません。選択肢は本来、順序のない集合であるにもかかわらず、直列化した時点で並び順が生まれ、モデルの出力が並び順に引きずられます。LLM評価で繰り返し報告されてきた選択肢順序バイアスは、この構造上の不一致から生じています。
さらに、適切な答えが1つも存在しない場合の扱いも曖昧になります。生成型の出力では「どれも当てはまらない」と「候補同士が拮抗していて自信がない」が区別されず、どちらも低い確信度として現れてしまいます。シンガポール国立大学のQi Li氏とXinchao Wang氏による本研究は、この問題をアーキテクチャの側から解こうとしたものです。
4つの設計要件
論文はまず、System Oneモデルが満たすべき要件を4つに整理しています。既存手法の弱点を列挙するのではなく、決定問題の定義から逆算して要件を導いている点が本研究の出発点です。
- null認識、候補の不在と候補間の競合を区別できること
- 順序不変性、選択肢を並べ替えても判定が変わらないこと
- 候補数のスケーラビリティ、候補が増えても出力空間を作り直さずに済むこと
- キャッシュ可能性、繰り返し現れる選択肢の計算をリクエスト間で再利用できること
これらは個別に見れば既知の課題ですが、4つを同時に満たす構成は従来存在しませんでした。Jevaはこの4要件を前提として設計されたアーキテクチャです。
Jevaの構成
Jevaの中心は、リクエストと各選択肢を共有エンコーダで独立に符号化する点にあります。選択肢のベクトルは、リクエストにも他の選択肢にも依存しません。
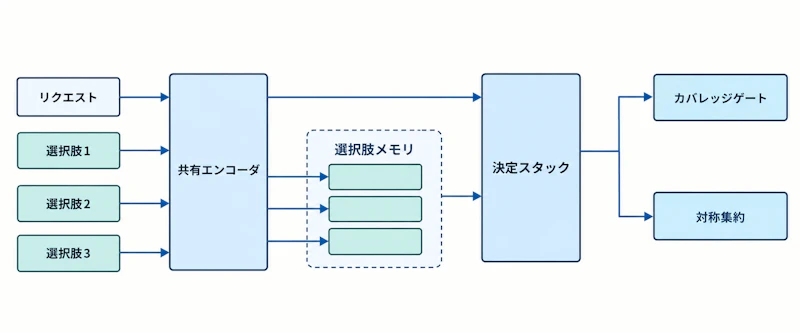
図1に示すように、符号化された選択肢は固定された選択肢メモリとなり、その上でリクエスト側の状態だけが決定スタックによって更新されます。公開モデルの決定スタックは1ブロック、8ヘッド、決定幅768という小さな構成です。
出力は2系統に分かれます。カバレッジゲートが「受け入れ可能な候補が存在するか」の確率を推定し、候補間の競合はそれとは別にsoftmaxで解決します。この分離によって、答えの不在を明示的な出力として扱えるようになりました。
選択肢スコアは対称集約と共有スコア関数で計算されるため、並べ替えに対する不変性が構造として保証されます。また、選択肢の表現も層ごとの射影もリクエストに依存しないので、別のリクエストで同じ選択肢が現れたときに計算をそのまま使い回せます。出力型は選択を行うChoice、真偽の確率を返すNoul、数値評価を返すScoreの3種類に統一されています。
実験結果
評価にはQwen3.5-4Bをバックボーンとし、エンコーダにrank-64のLoRAを適用したJeva-4Bが用いられました。意図分類のBANKING77やMASSIVE、Web操作のMind2Web、大規模候補検索のToolRet、長文検索のMLDRなどを組み合わせた8スライスでの比較が行われています。
評価項目 | Jeva-4B | 比較対象 |
|---|---|---|
BANKING77(K=16)精度 | 92.05% | 8スライス中7つで首位 |
Typed Decisions精度 | 78.30% | InternDecision-4B 78.70% |
null検出AUROC | 98.66% | KEV-BF16 93.61% |
順序入れ替えでの判定反転 | 0件 / 600件 | 他手法 17.00〜26.17% |
2,048候補での精度 | 69.88% | JevK5 67.47% |
MLDRでの中央値レイテンシ | 約75ms | キャッシュなし 約2,102ms |
null検出では、答えが存在しないケースの93.88%を誤検出率5.02%で捉えています。順序入れ替えの試験では600件すべてで判定が変わらず、17%から26%の反転率を示した比較手法との差が明確に出ました。
選択肢の再利用が完全に効く条件下では、中央値レイテンシが約2,102msから約75msへ、およそ28倍の高速化を達成しています。判定内容は変わらないため、速度向上が精度の犠牲によるものではない点が確認されました。Typed Decisionsの精度ではInternDecision-4Bにわずかに及ばず、全項目で勝っているわけではありません。判断特化モデルという方向性ではMicrosoft-Decision-1のような商用モデルも登場しており、設計思想の比較は今後の論点になりそうです。
限界と今後
論文には独立した限界の節がなく、注意点は本文中に散在しています。順序不変性や候補追加に関する理論的保証は厳密な実数演算を前提としており、同点の最大値や浮動小数点誤差があると結果がぶれる可能性に触れています。複数ブロック構成での候補追加に関する保証も未完成のままです。
運用面では、重みやエンコーダ設定を変更した際にキャッシュを無効化する必要があります。Score出力のRMSEなど一部の指標では既存手法が上回る場合もあり、万能の置き換えではありません。
それでも、選択肢順序バイアスを後処理やプロンプト工夫で緩和するのではなく、アーキテクチャの性質として排除したという点に本研究の価値があります。同日に公開された動画向けのVideoJevなど派生研究も現れており、決定問題に特化した設計の広がりが見えてきました。
論文情報: "Jeva: System One Models from First Principles"(Qi Li, Xinchao Wang, 2026) arXiv:2610.18773, CC BY 4.0


