 AI-Papers
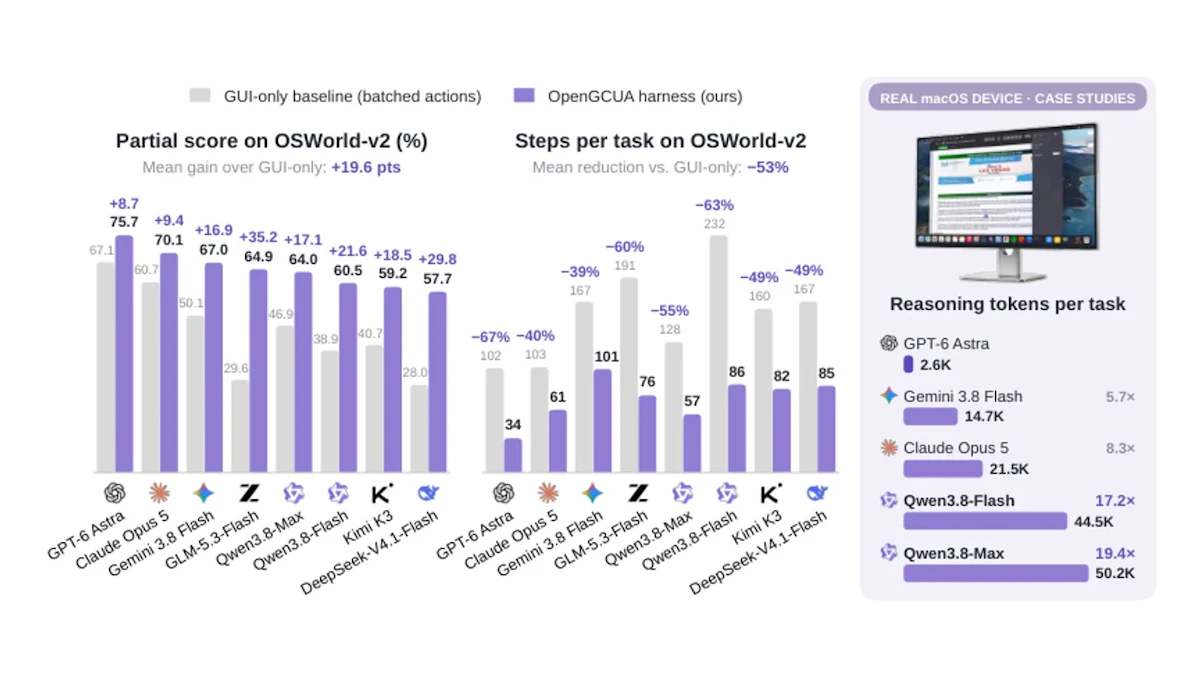
- コンピュータ操作エージェントの実装・プロンプト・8モデル分の評価軌跡までを公開する「OpenGCUA」が提案されました
- コード実行を中核に据えた設計で、OSWorld-v2のオフライン82タスクで8モデル全てのスコアが向上し、平均partial scoreは45.3から64.9へ改善しました
- 観測や進捗判断をハーネスの固定ルールからモデル側へ移すことで、1タスクあたりのステップ数が平均53.0%削減されています
研究の背景
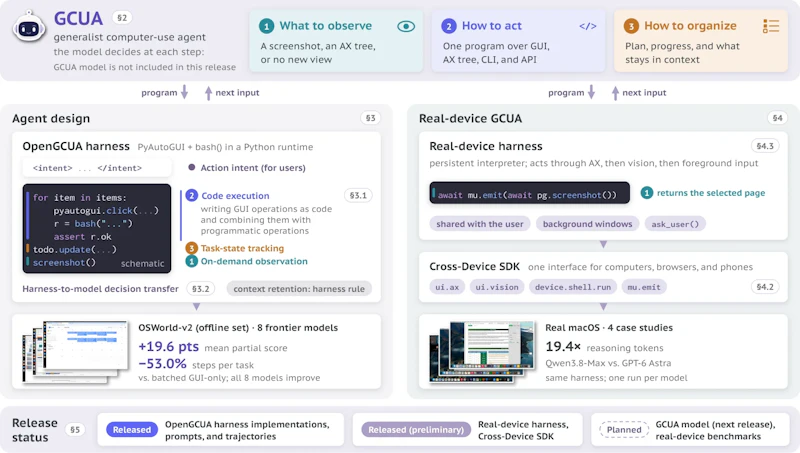
コンピュータ操作エージェント(Computer Use Agent、CUA)は、画面を見てマウスやキーボードを操作し、人間が使うアプリをそのまま動かすAIシステムです。論文の著者らは、こうしたエージェントを「GUI(画面操作)とプログラム的なインターフェースの両方にまたがって、何を観測し、どう行動し、作業をどう組み立てるかを自分で選ぶシステム」として、汎用コンピュータ操作エージェント(Generalist Computer Use Agent、GCUA)と定義しています。
問題は、この領域で性能の高いシステムがほぼ非公開である点です。GPT-6 Astraのようなフロンティアモデルを動かすハーネス(モデルと環境をつなぐ実行基盤)の中身や、プロンプトの設計、実際の行動軌跡は外部から確認できません。どの改善がモデルの能力に由来し、どの改善がハーネス側の工夫に由来するのかを切り分けられないため、研究としての積み上げが難しい状況にありました。
OpenGCUAは、この層を丸ごと開くことを目的としたコミュニティプロジェクトで、論文はその最初のバージョンにあたります。実装、プロンプト、評価に使った8モデル分の軌跡、さらに実機macOSハーネスとクロスデバイスSDKの先行版が公開されています。
コード実行を中核に置く設計
図2に示すように、OpenGCUAの設計の中心にあるのはコード実行です。モデルは1手ごとにクリック座標を返すのではなく、共通SDKを呼ぶPythonプログラムを書きます。ランタイムは永続的なインタプリタを持つため、変数や取得済みのオブジェクトがターンをまたいで残り、途中の計算結果を次の判断に使えます。
この方式の利点は、モデルが持つプログラミング能力をコンピュータ操作そのものに転用できることです。論文は、生成されたプログラムに繰り返し現れるパターンを整理しています。GUIクリックとプログラムによる状態チェックを交互に挟み、チェックが通ってから次の操作に進む構成、7つのページセクションをループで巡回してDOM(ページの構造データ)から各セクションの状態を検証する構成、下書きの比較結果が一致したときだけ送信ボタンを押す構成などです。
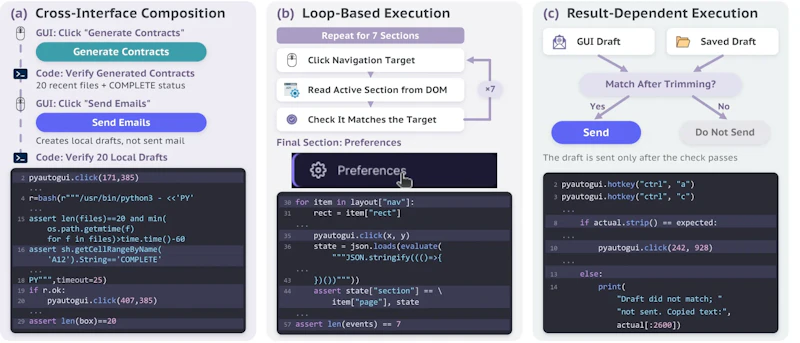
プログラムは観測の準備にも使われます。3Dオブジェクトの25方向のビューを自動で収集し、番号付きの一覧画像にまとめてから1回だけモデルに見せる、という使い方です。25回のスクリーンショット往復が1回の視覚確認に圧縮されるため、ステップ数の削減に直接つながります。
決定をモデルへ移す仕組み
もう1つの新規性が「harness-to-model decision transfer」です。従来のハーネスは、毎ステップ必ずスクリーンショットを撮る、履歴を一定長で切るといったルールを固定で持っています。OpenGCUAはこうした判断の一部をモデル自身に委ねます。モデルは次の入力にスクリーンショットが必要かどうかを宣言し、タスクの状態を「変更したが未検証」「検証済みと主張」といったラベルで自己申告し、プログラムが何を変え何を保つつもりかを短い意図文として出力します。
この設計はコンテキスト管理とも密接に関わります。必要なときだけ画面を撮る方式はキャッシュヒット率を高め、Qwen3.8-Maxでは75.6%から86.1%へ、スクリーンショットを一定数だけ保持するローリングバッファではさらに16.0ポイントの改善が報告されています。長い対話で何を残し何を捨てるかという論点は、コンテキストエンジニアリングとは?プロンプトとの違いと圧縮・メモリ設計を解説で扱われている設計課題と地続きです。
ただし全ての機構が一様に効くわけではありません。意図文の出力はスコアをわずかに下げており、著者らはこれを想定内と説明しています。意図文の目的はスコア向上ではなく、実機でエージェントの挙動を人間が追えるようにすることだからです。
実験結果
評価にはOSWorld-v2のオフラインサブセット82タスクが使われました(インターネット接続が必要な26タスクは除外)。GUI中心の従来型CUA構成と比較すると、8モデル全てでスコアが向上しています。
項目 | GUI中心のCUA | OpenGCUA |
|---|---|---|
8モデルの平均partial score | 45.3 | 64.9 |
GPT-6 Astraのスコア | 67.1 | 75.7 |
GPT-6 Astraの平均ステップ数 | 102.1 | 33.5 |
向上幅はGPT-6 Astraの+8.7ポイントからGLM-5.3-Flashの+35.2ポイントまで幅があり、もともと性能の高いモデルより中位のモデルで効果が大きい傾向が見えます。ステップ数は平均53.0%減少しました。CLI(コマンドライン操作)を併用するバッチ型のベースラインと比べた場合も、Qwen3.8-Maxが57.2から64.0、Claude Opus 5が65.7から70.1へと改善しています。
一方で論文内には数値の不整合もあります。コード実行の寄与について、本文中の図では一定の差が示される一方、導入部ではGUI+CLI比較を+6.1ポイント、ステップ-14.8%と報告しており、両者が一致していません。読む際は比較条件を確認する必要があります。
コストで最適モデルは変わる
著者らはタスクあたりの支出上限を後から適用する分析も行っています。失敗した試行の費用も含めて上限を超えた軌跡は0点として扱う、という厳しめの条件です。この分析では、予算が上がるにつれて首位モデルがQwen3.8-Flash、GLM-5.3-Flash、Gemini 3.8 Flash、GPT-6 Astraへと入れ替わりました。
Qwen3.8-Flashは1タスク約0.38ドルで60.5点に達し、GPT-6 Astraが75.7点を出すのには約15.26ドルかかります。精度だけを見れば上位モデルが有利ですが、予算制約のある実運用では小型モデルの方が合理的になる場面があるという整理です。なお時間制約の比較については、APIのレート制限や並列度を揃えていないため探索的な結果にとどまると明言されています。
実機ハーネスとクロスデバイスSDK
ベンチマークだけでは実機の難しさを捉えきれないという判断から、著者らは実機macOS用のハーネスも構築しています。図9の5層構成は、モデルが生成したプログラムが実際のアプリとOSに届くまでの経路を示したものです。
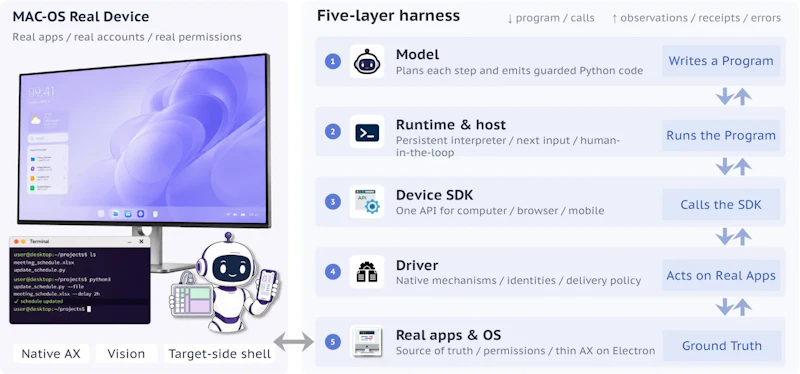
- Model: 何を観測し、どう行動し、作業をどう組み立てるかをPythonプログラムとして表現する
- Runtime: 永続インタプリタでエージェントループを回し、変数を次のターンへ引き継ぐ
- Device SDK: 操作対象のデバイス・ウィンドウ・タブを明示的に束縛する
- Driver: SDK呼び出しをネイティブ操作へ変換し、検出可能な失敗は型付きエラーで返す
- Applications and OS: 権限とアクセシビリティ対応が実行可能な範囲を決める
クロスデバイスSDKは、PC・モバイル・ブラウザに共通の語彙を与え、プラットフォーム固有の差分をアダプタに閉じ込める設計です。macOSアダプタはtrycuaのCua Driverを利用し、アクセシビリティ経由の構造化観測とスクリーンショットベースの座標操作を使い分けられます。実機4タスクの先行結果では、GPT-6 Astraが平均34.5ステップで4タスク全て完了、Qwen3.8-Maxは50.8ステップで3タスク完了という差が出ました。推論トークンの消費量はQwen3.8-Maxが19.4倍に達しており、実機環境での効率差がベンチマーク以上に開く可能性を示しています。
まとめと課題
OpenGCUAの意義は、スタック全体を開いたうえで「コード実行を中核にすること」と「決定をモデルへ移すこと」の効果を、8モデル横断で定量的に示した点にあります。エージェント開発者は公開された実装とプロンプトを起点に、自分のモデルやタスクで同じ構成を検証できます。
ただし制約は多く残ります。この版では新しいモデルを学習しておらず、既存モデル上での設計検証にとどまります。実機ハーネスとSDKはいずれも先行版で、実機評価は4タスクという小さな標本です。さらに、タスク状態のラベルやプログラム内のアサーションはモデルやプログラム自身による確認であり、独立した評価の代わりにはならないと著者らも明記しています。ステップ数が減っても出力トークンが減るとは限らず、実運用での遅延は別途測る必要があるという指摘も、導入を検討する側には重要でしょう。
論文情報: "OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use"(Hanzhang Zhou et al., 2026) arXiv:2610.22200, CC BY 4.0
本記事の図(図2、図3、図9)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


