 AI-Papers
- NVIDIAがIIT MadrasのAI4BharatらとインドAI向け事前学習コーパス「Nemotron-pretraining-Indic-v1」を発表、22言語34構成で約2.8兆トークン規模
- 英語データを翻訳し、MQM準拠のルーブリックでGemma-4-31B-itが100点満点採点、75点未満は指摘を元に書き直して438.4Bトークンを回収
- 継続事前学習に用いたところ、インド系5ベンチマークすべてで4.98〜9.82ポイントの改善を確認
22言語34構成のコーパス
NVIDIAは、インド憲法が定める22のインド系言語を対象にした事前学習用データセット「Nemotron-pretraining-Indic-v1」を発表しました。Gemma-4トークナイザで数えて、ネイティブ文字が2,601.0億トークン、ラテン文字に転写したローマ字表記が224.6億トークン、合わせて約2.8兆トークンという規模です。
ネイティブ文字のデータは22言語すべてに用意され、ローマ字表記はBengali、Gujarati、Hindi、Kannada、Malayalam、Marathi、Nepali、Odia、Punjabi、Tamil、Telugu、Urduの12言語に用意されています。言語と文字の組み合わせでは34構成になります。Assamese、Bodo、Dogri、Kashmiri、Konkani、Maithili、Manipuri、Sanskrit、Santali、Sindhiの10言語はネイティブ文字のみの提供です。
元データは、Web文書、質問応答、数学、コード、専門分野などを含むNemotron-CC-v2の15サブセットです。各レコードには出典の識別子が残され、どの英語文書から生成されたかを追跡できる作りになっています。共同開発にはIIT Madras、同大学のAI4Bharat、Bodhan AIが参加しました。
翻訳と採点を分ける2系統
制作パイプラインは言語グループごとに2系統に分かれています。12言語のグループでは、Gemma-4-31B-itが文書全体を翻訳し、同じモデルが翻訳を英語原文と突き合わせて採点します。コード、数式、URL、書式はそのまま保持する設計です。
採点基準はMultidimensional Quality Metrics(MQM)を参考にしたルーブリックで、意味、流暢さ、用語、文体、書式の5観点を見ます。100点満点で75点以上を採用条件とし、これは正解率ではなくルーブリックの得点である点が明記されています。
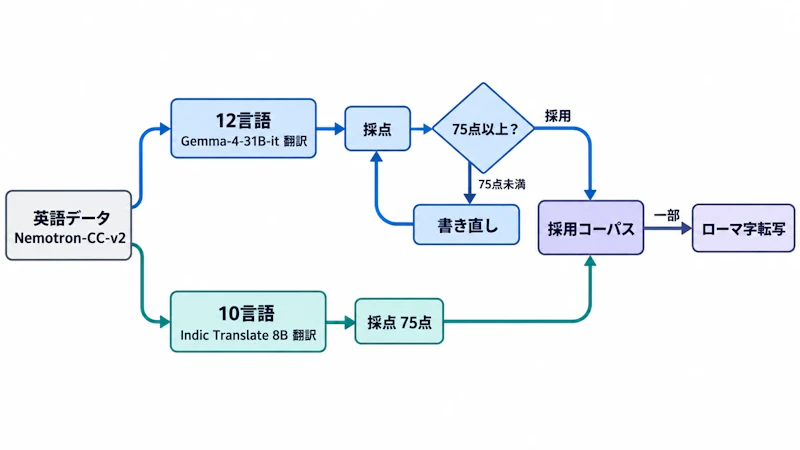
図1のように、残る10言語のグループではBodhan AIのIndic Translate(8B)が翻訳を担い、採点のみGemma-4-31B-itが行います。長文のSantaliは重複する窓に分けて翻訳し、Manipuriはいったんベンガル文字に翻訳してからMeitei Mayekへ変換するという処理が入ります。こちらのグループはネイティブ文字のみの提供で、指摘に基づく書き直しは行いません。
438.4Bトークンを回収
このパイプラインで特徴的なのが、低得点の出力を捨てずに修復する工程です。12言語グループでは、75点に届かなかった翻訳を採点時のフィードバックを使って書き直し、同じ基準で採点し直します。
この再処理によって回収されたのが438.4億トークンで、コーパス総量にすでに含まれています。採点の信頼性については、人手による抜き取り確認に加え、意図的に誤りを混ぜた文書を通して検出できるかを試し、プロンプトと検査項目を調整したと説明されています。
区分 | トークン数 |
|---|---|
ネイティブ文字 | 2,601.0B |
ローマ字表記 | 224.6B |
うち書き直しで回収 | 438.4B |
なお、この数字には採用された書き直し版や同一出典の文字違いの版も含まれるため、独立した英語文書の数や学習予算をそのまま示すものではありません。
継続事前学習での効果
データセットの有効性は、Nemotron 3.5 Super VLの継続事前学習で検証されています。100億トークンの学習予算のうち100億トークン中の10億トークン分にあたる10%をインド系言語に割り当て、本コーパスの12言語サブセットと自然なインド系言語テキストを組み合わせました。
結果は、MILU、Indic MMLU-Pro、Indic ARC-Challenge、Indic ARC-Easy、Indic GSM8Kの5指標すべてで上昇し、伸び幅は4.98〜9.82ポイントでした(GSM8KはOdiaを除く)。ただしNVIDIAは、この伸びは合成データと自然テキストを合わせた段階の結果であり、合成コーパス単体の寄与ではないと注記しています。モデル全体ではNemotron 3 Superと比べて6つのタスクベンチマークのうち5つで上回り、IFEval 1.5のみ2.04ポイント低下しました。
再現できる形で公開
今回の発表で実用面の意味が大きいのは、データそのものよりも生成手順が開く形で提供される点です。NeMo Data Designer向けの「Nemotron Bharat」翻訳プラグインが公開され、次の要素が含まれます。
- 翻訳用および評価用のプロンプト
- フィードバックに基づく書き直し(任意)
- 長文を分割して処理する文書ウィンドウ化
- 文字体系を変換するスクリプトリマップ
プラグインは候補と得点を返すだけで、どこで足切りするかは利用者が決める設計です。データ不足が性能差の主因になっている低リソース言語で、英語資産を翻訳して品質を機械的に担保するという手順を、他の言語圏でも試せることになります。データセットの構成を公開する動きは3DCodeVerseのような大規模データセットでも見られ、学習データ側の透明性を高める流れの一つといえます。
AI4BharatのMitesh Khapra氏は、インド言語技術が英語に後れを取る理由を「インド言語には十分なデータがない」ことだと述べています。AI4BharatとNVIDIAは評価基盤となるIndic-LLM-Eval-Suiteの整備も進めており、学習データと評価指標を両輪で揃える構えです。データセットは近日公開予定で、利用前にデータセットカードとライセンスを確認するよう案内されています。


