 AI-Papers
- 3Dコンテンツをメッシュではなく実行可能なコードとして集めた269,597件のプログラム集「3DCodeVerse-2M」を構築し、公開が予告されました
- 実行検証と空間計測、視覚評価を自動で回すDAG型マルチエージェントHarnessが、Claude Design(3D Object)に対して人間評価で90%の勝率を記録しました
- このデータでQwen3.5-9BをLoRA微調整すると、3DCodeBenchの実行成功率が0.0%から84.9%まで改善しました
研究の背景
3D生成モデルの主流は、メッシュや点群、ガウシアンスプラッティングといった「出力そのものが形状データ」の表現です。見た目の品質は年々上がっていますが、できあがった形状は後から部品単位で編集しづらく、寸法が仕様どおりか、部品が互いに貫通していないか、ヒンジが可動域内で動くかといった検証も容易ではありません。
これに対して、3D世界は本来コードでも記述できます。Blender Python、CadQuery、OpenSCAD、URDF、Three.js、GLSLなど、形状や挙動をプログラムとして書く手段はすでに広く使われています。コードであれば数値を書き換えるだけで寸法を変えられ、実行して結果を検証でき、差分として管理もできます。
問題は、Large Language Model(LLM)がこうした3Dコードを書くのが苦手なことです。学習データとして使える「実行可能で説明が付いた3Dプログラム」が圧倒的に足りません。arXiv に投稿された論文「3DCodeVerse: Exploring 3D Worlds as Code」は、この欠落をデータセットと生成基盤の両面から埋めようとした研究です。
データセットの構成
3DCodeVerse-2M は、公開データの収集、専用表現からの変換、そしてコーディングエージェントによる新規生成という3つの経路でプログラムを集めています。図2がその収集と構成の流れです。各プログラムは単体で動く形に整えられ、実行に必要なアセット、説明文、レンダリング画像、検証の記録が添えられています。
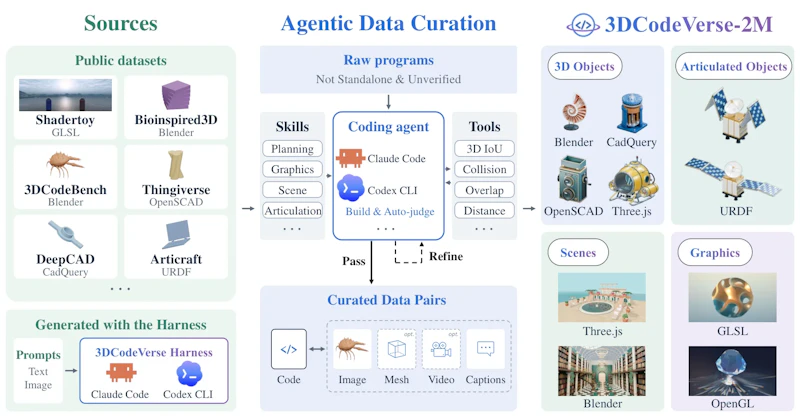
カタログに索引化されたユニークな実行可能プログラムは269,597件、総容量は800.6MBです。これを統一フォーマットのテキストとして342シャードに書き出すと2,028,286行になり、名称の「2M」はこの行数を指します。学習用には768,596件のプロンプトとコードの組(約891Mトークン)に重複除去して整えられています。
内訳は偏りが大きく、上位2つが全体の9割以上を占めます。主な収録元は次のとおりです。
- DeepCAD から CadQuery へ変換したCADモデル(128,201件、47.6%)
- Shadertoy 由来の GLSL シェーダ(119,961件、44.5%)
- Articraft の CadQuery(6,882件)と URDF(6,146件)
- Bioinspired3D の Blender Python(6,343件)
- Thingiverse の OpenSCAD(1,193件)やエージェント生成の Three.js / Blender プログラム
収録対象は静的オブジェクト、可動部を持つ関節オブジェクト、シーン、そして手続き的グラフィックスの4カテゴリに分かれます。評価用のベンチマークは学習データから切り離し、アセット単位の重複も確認してリークを避けたと報告されています。
Harnessの仕組み
データを増やす側の仕掛けが 3DCodeVerse Harness です。図3のように、まずLLMのプランナーがプロンプトを「部品名・寸法・素材・部品間の関係・合否チェックリスト」という構造化された仕様に変換します。続いて有向非巡回グラフ(DAG)が実装タスクを並べ、サブエージェントが互いに編集ファイルが重ならない範囲で並行してコードを書き、組み立てます。
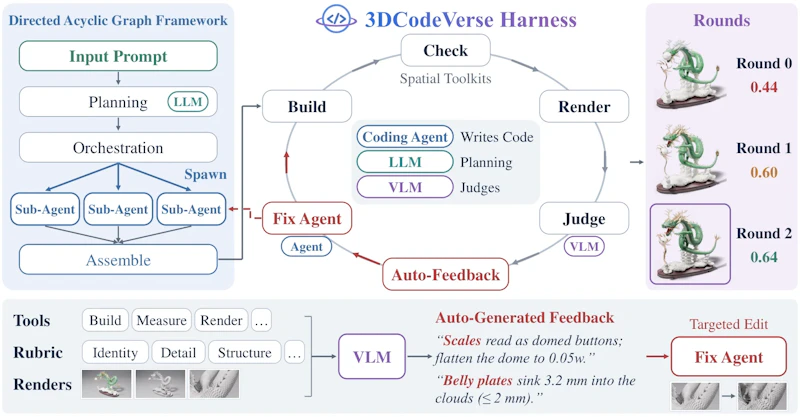
生成物はまず決定的なチェックにかけられます。ビルドが通るか、バウンディングボックスが指定寸法の契約を守っているか、部品が接続されているか、衝突や貫通がないか、関節オブジェクトなら可動域を動かしきれるか、グラフィックスなら時刻ごとのフレームが統計的に妥当かを調べます。そのうえで Vision Language Model(視覚と言語を扱うモデル)の審査役がマルチビューのレンダリングをルーブリックで採点します。審査役はソースコードを見られず、観察した内容を先に述べてから採点する形式に縛られ、計測が通っている項目について矛盾する指摘をした場合は無効化されます。
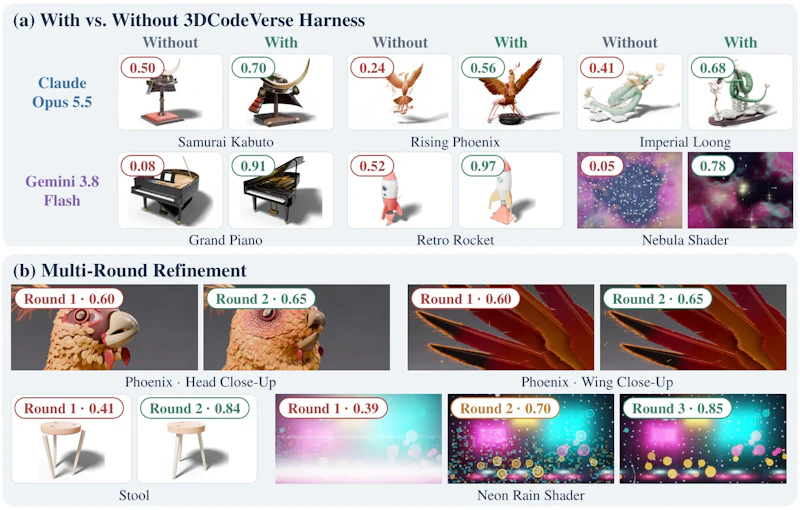
修正エージェントは、これらの指摘を1ラウンドあたり最大6件の優先順位付きタスクに変換します。最大4ラウンド、壁時計時間60分を上限に反復し、最も高いスコアのプログラムが最終出力として選ばれます。図5の右側では、浮いていた脚や貫通していた部品がラウンドを追って解消されていく過程が示されています。コスト面では、Gemini 3.8 Flash を使った場合のオブジェクト1件あたり平均費用が3.31ドルと報告されています。
実験結果
Harnessの効果は、各モデルが標準で備えるコーディング環境との一対比較で測られています。3Dオブジェクトの生成では人間評価の勝率が69%から89%、審査スコアは11から25ポイントの改善でした。関節オブジェクト、シーン、グラフィックスでも78%から88%の勝率です。
比較条件 | 審査スコア(標準) | 審査スコア(Harness) |
|---|---|---|
Gemini 3.8 Flash | 61 | 87 |
GPT-6 Luna | 64 | 86 |
Claude Design(Claude Opus 5.5) | 37 | 88 |
Claude Opus 5.5 を共通のバックボーンとして Claude Design(3D Object)と比べた場合、人間評価で90%の勝率、審査スコアで88対37という差が付きました。決定的チェックによるスコア上限を外した採点でも88.1対62.4で優位が残っており、差が採点ルールの副作用ではないことを確かめています。
データセット側の価値は微調整実験で示されました。Qwen3.5-9B は 3DCodeBench の実行成功率が0.0%から84.9%へ、Qwen3.8-27B は教師ありファインチューニングとDPOの併用で51.9%から92.9%へ上がりました。失敗の多くは Blender 5 系の古いAPI呼び出しなど方言のずれに起因しており、データで埋められる種類の弱点だったことがわかります。コーディングエージェントの能力をタスク別に測る試みとしては、AgentSWEのような評価研究とも関心が重なります。
応用と残る課題
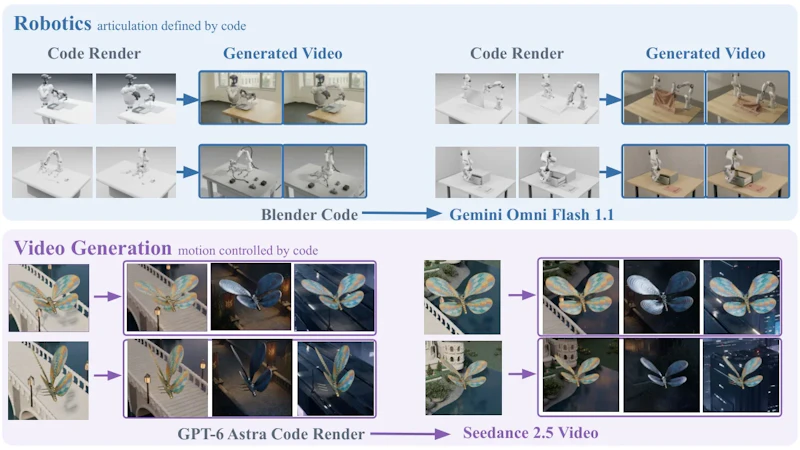
応用例として2つが挙げられています。ロボット操作では、リンク形状と関節軸、可動限界が編集可能なパラメータとして書かれるため、プログラムで条件を振りながら検証できます。生成したアセットを MuJoCo で動かした場合、電子レンジの扉と取手の形状チェックを12件すべてで通過した一方、比較対象の世界モデル UWM の行動条件付き動画予測は36回中7回しか通りませんでした。もう1つは動画生成で、図7のようにコードからのレンダリングをレイアウトやカメラ運動の参照として与え、Gemini Omni Flash 1.1 や Seedance 2.5 に見た目を仕上げさせる使い方です。
まとめと今後の展望
3DCodeVerse は、3D生成を「形状を直接出す問題」から「検証可能なプログラムを書く問題」へ寄せる試みです。データセット、Harness、モデル、学習レシピの公開が予告されており、実現すれば3D生成とコーディングエージェントの双方で使える基盤になります。
一方で課題も残ります。収録内容はCAD変換とシェーダに大きく偏っており、シーンや関節オブジェクトの件数は数千規模にとどまります。微調整後もGLSLの実行成功率は56.0%から71.5%どまりで、メッシュ忠実度(F@0.05)は0.374が最高値と、形状そのものの精度には距離があります。Harnessは外部の商用モデルに依存し、1件あたり数ドルの費用がかかるため、大量生成の経済性も検討が必要でしょう。論文には独立したLimitationsの節が置かれておらず、評価の多くが自前のルーブリック審査に依存している点も、公開後の追試で確かめたいところです。
論文情報: "3DCodeVerse: Exploring 3D Worlds as Code"(Yipeng Gao et al., 2026) arXiv:2610.22341, CC BY 4.0
本記事の図(図2、図3、図5、図7)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


