 AI-Papers
- 世界生成・物理推論・行動生成を単一モデルに統合した初のオープン統合モデル
- Mixture-of-Transformersで複数モダリティを一度に処理、ロボット・自動運転の開発効率を大幅改善
- HuggingFace経由で即日利用可能、NanoとSuperの2サイズを用意
概要
NVIDIAは2026年5月29日、物理AI向け統合モデル「Cosmos 3」をHuggingFaceで公開しました。従来はロボティクスや自動運転の開発に複数の専門モデルを組み合わせる必要がありましたが、Cosmos 3は世界生成(リアルな映像の合成)、物理推論(動き・因果関係の理解)、行動生成(ロボット動作の予測)を単一アーキテクチャで処理します。
開発者はテキスト・画像・動画・音声・アクション指令を入力として与え、映像生成・推論結果・行動予測を一度に得られます。これにより、モデル間のデータ受け渡しが不要になり、物理AIシステムの開発サイクルが大幅に短縮されます。
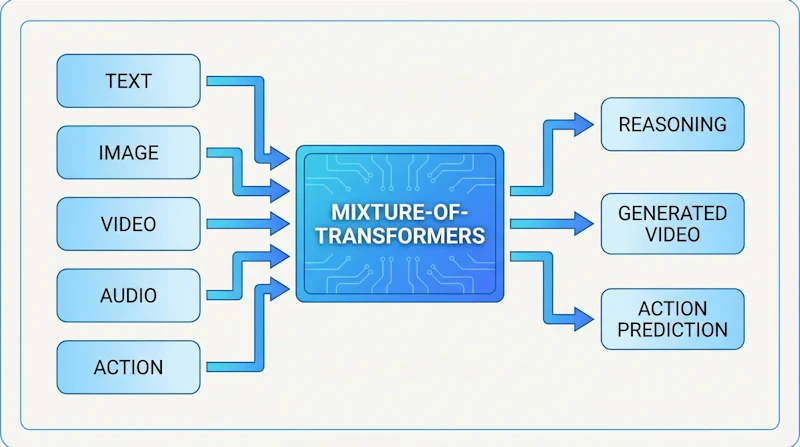
Mixture-of-Transformersアーキテクチャの仕組み
Cosmos 3の中核技術は「Mixture-of-Transformers(MoT)」と呼ばれる新アーキテクチャです。テキスト・映像・音声・アクションといった異なる種類のデータを、それぞれ専用のエンコーダ(映像はViT、生成はVAE、アクションはドメイン固有ベクトル)で処理し、共通の表現空間に投影します。
MoTは内部で2つの処理経路を持ちます。1つ目は自己回帰(AR)シーケンスで、次トークン予測による推論・理解を担当します。2つ目は拡散(DM)シーケンスで、反復的なノイズ除去による生成を担います。ARとDMは独立したパラメータを持ちながらも、ジョイントアテンション機構を通じて相互に情報を交換します。
モデルサイズは用途に応じて2種類が用意されました。Cosmos 3 Nanoは推論用8B+生成用8Bの計16Bパラメータで、RTX PRO 6000やワークステーションで動作します。Cosmos 3 Superは推論用32B+生成用32Bの計65Bパラメータで、大規模な合成データ生成や研究用途に適しています。
項目 | Cosmos 3 Nano | Cosmos 3 Super |
|---|---|---|
推論用パラメータ | 8B | 32B |
生成用パラメータ | 8B | 32B |
合計パラメータ | 16B | 65B |
想定環境 | RTX PRO 6000・ワークステーション | 大規模な合成データ生成・研究用途 |
2つのサイズは同じアーキテクチャを共有するため、手元での試作から大規模な生成まで同じコードで移行できます。
ロボット・自動運転への実用的な応用
Cosmos 3は入出力の組み合わせによって、5つの主要機能を実現します。テキストと画像・動画から映像を生成する「ビデオモデル」モードでは、物理的に妥当なシミュレーション映像を合成できます。テキストと映像から説明文を生成する「VLM」モードは、自動運転における状況理解に活用されます。
アクション指令と画像・テキストから映像を生成する「順動力学モデル」は、ロボットの動作シミュレーションに使われます。逆に、テキストと映像からアクションを予測する「逆動力学モデル」は、観測された動きから必要な操作を推定します。画像とテキストから映像とアクションの両方を生成する「ポリシーモデル」は、ロボットの把持計画やピック&プレース作業に直接適用できます。
NVIDIAは物理AIトレーニング用の合成データセットも同時公開しました。内訳は次の6種類です。
- Embodied-Robot-Scenes: ロボットシミュレーション
- Physical-Interaction-Scenes: Isaac Simによる物理シミュレーション
- Spatial-Reasoning: 空間推論データ
- Digital-Human-Scenes: 人間の動作データ
- Autonomous-Driving-Scenarios: 自動運転シナリオ
- Warehouse-Operations-Scenes: 倉庫作業データ
開発者はこれらを使って、特定ドメインへのファインチューニングを行えます。
ロボット開発において、Qwen-VLAとは?操作・ナビゲーション・軌跡予測を統合したクロス体型ロボットAIのようなクロス体型対応モデルとCosmos 3を組み合わせることで、異なるロボット間での知識転移がより効率的になると期待されています。
開発者向けアクセスと活用方法
Cosmos 3はHuggingFaceのDiffusersライブラリ経由で即座に利用できます。Cosmos3OmniPipelineを使い、モデルをロードしてプロンプトを与えるだけで、テキストから画像・動画を生成できます。コードはPyTorchとbfloat16精度に対応し、CUDAデバイスで動作します。
NVIDIAはGitHubでCosmos 3のリポジトリとCosmos Frameworkを公開しており、ポストトレーニングスクリプトやエージェントスキルのサンプルが含まれています。Cosmos Cookbookには詳細なチュートリアルとプロンプトエンジニアリングのテンプレートが用意されています。
本番環境へのデプロイにはNVIDIA NIMマイクロサービス経由でのアクセスも可能です。開発者は特定のロボット・環境・タスクに対してLoRAやDoRAによるファインチューニングを実行し、ドメイン固有の性能を高められます。
プロンプトの書き方には用途による違いがあります。映像生成時は詳細な段落形式のプロンプトが推奨され、アクション生成時は空間的な参照を含む簡潔なプロンプトが効果的です。プロンプトアップサンプリングのテンプレートはGitHubリポジトリで公開されています。


