 AI-Papers
- Microsoftが文章を生成せず選択肢ごとの確率だけを返す判断特化モデル「Microsoft-Decision-1」を提供開始
- 学習に使っていない36のベンチマークで最高の正答率を記録し、GPT-6 Solより35倍速いと説明
- 入力は100万トークンあたり0.042ドルで出力は無料。Xboxの社内事例ではコストが200分の1に
文章を書かないAIモデル
Microsoftは2026年10月9日(現地時間)、テキストを生成しないAIモデル「Microsoft-Decision-1」を発表しました。与えられた選択肢ごとの確率を返すだけの「判断特化」モデルで、開発者向けのAI開発基盤「Microsoft Foundry」と、複数のモデルをAPI(Application Programming Interface)経由で利用できる「OpenRouter」で提供が始まっています。
ベースになっているのはAlibaba Groupのオープンウェイトモデル「Qwen3.5-9B」で、ここにMicrosoftが追加学習を施しました。同社は今後、Microsoft AIやOpenAIのモデルをベースにしたものへ切り替えていく方針も示しています。
出力は確率のJSON
入力は状況、質問、そして固定の回答候補という3つの要素です。モデルは候補ごとの確率を1回の処理でJSON形式にまとめて返します。はい/いいえの二択、多肢選択、レーティング、さらに基準に沿ってAIの回答やエージェントの行動を採点する用途に対応します。
確率は実際の正答率と一致するようキャリブレーション(確信度の校正)されている点が設計上の軸になっています。アプリ側は返ってきた確率の高低を見て、そのまま処理を先に進めるか、人間による確認に回すかを切り分けられます。コンテキスト長は32,768トークンで、入出力はテキストのみです。
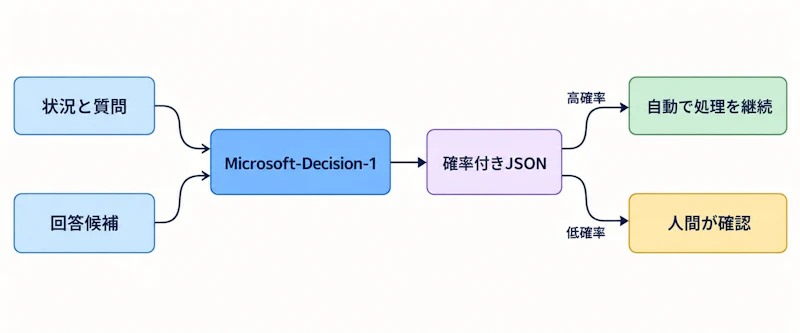
図1のように、確率がしきい値を超えたときだけ自動処理に流し、曖昧な場合は人間に戻す構成が想定されています。生成モデルに判断させる場合と違い、出力は決まった候補の中からしか返らないため、後段のパース処理が崩れにくくなります。
36ベンチマークで首位
Microsoftは、学習に使っていない36のベンチマークで他モデルと比較し、正答率が最も高かったと説明しています。応答速度でも首位で、2位の「H2O-Lightning-4B v1.1」より2.5倍、OpenAIの「GPT-6 Sol」より35倍速いという結果です。一方でキャリブレーションの精度では、TypeSafe AIの「Jev」などに次ぐ3位でした。
社内の適用例として挙げられたのは、Xboxの研究チームによるフィードバック分類です。ゲームなどに関する1万件を超えるフィードバックの仕分けにDecision-1を使い、GPT-6 Solと遜色ない品質を保ちながら処理は14倍以上速く、コストは200分の1に下がったとしています。
想定用途と避ける領域
Microsoftが挙げる想定用途は、生成能力を必要としない判定系の処理に絞られています。
- リクエストの分類と振り分け
- 優先順位付けと検証
- AIエージェントの次の行動の可否判断
- AI出力の評価
- データのラベル付け
振り分けの用途は、TokenRouterとは?トークン単位のLLMルーティングを最大64倍高速化で扱ったようなルーティング研究と重なる領域です。反面、文章生成、自由回答、会話、翻訳、要約には対応しません。与信や雇用、医療といった人間に関わる重大な決定をこのモデル単独で下す用途は避けるよう、同社は注意を促しています。
先行する2社との比較
判断特化モデルという枠組みは、Microsoftが最初に出したものではありません。2026年9月15日には米TypeSafe AIが「Jev」を発表し、元OpenAIの研究者による開発であることや「スマートなif文」という位置付けがAIコミュニティで話題になりました。料金は入力100万トークンあたり0.042ドル、出力無料で、Decision-1と同額です。
OpenAIも2026年9月29日に「Decisions API」のプレビュー版を公開し、廉価モデル「Luna」で同種の機能を提供しています。MicrosoftはDecision-1の公開後にブログを更新し、Jevとの正答率およびキャリブレーションの比較結果を追記しました。短期間に3社の選択肢が並んだことで、比較の軸は精度だけでなくキャリブレーションの質と単価に移りつつあります。
コスト設計への影響
公開されている主な数値は次の通りです。
項目 | Microsoft-Decision-1 |
|---|---|
入力料金 | 0.042ドル/100万トークン |
出力料金 | 無料 |
応答速度(GPT-6 Sol比) | 35倍 |
応答速度(H2O-Lightning-4B v1.1比) | 2.5倍 |
コンテキスト長 | 32,768トークン |
出力が無料という課金形態は、判定処理を大量に回すエージェント基盤にとって見積もりの前提を変えます。生成モデルで分類やガードレールの判定を行っている部分をDecision-1に置き換えると、支払いは入力トークン分だけになり、Xboxの事例が示した200分の1という削減幅もこの構造から説明がつきます。
ベースがパラメータ数9Bのモデルである以上、複雑な推論を伴う判断には限界があります。それでも、エージェントのルーティングや出力検証といった定型的な判定を安く速く回す層が選択肢として揃ったことは、実装側の設計判断に直接影響します。


