 AI-Papers
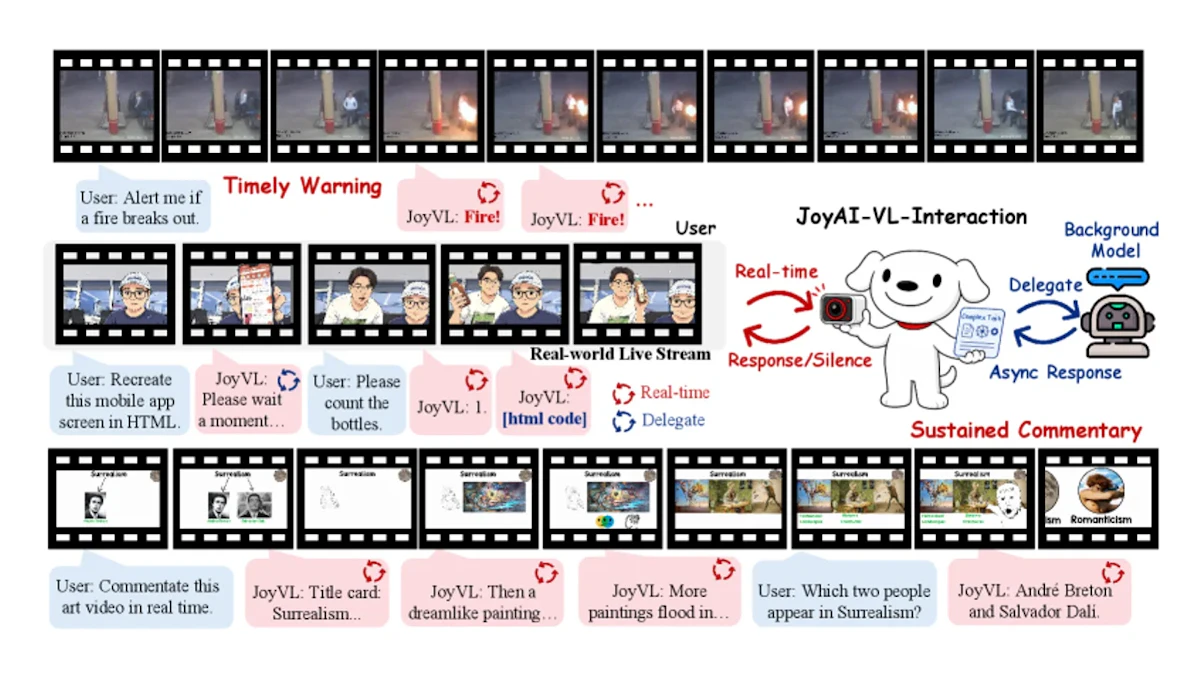
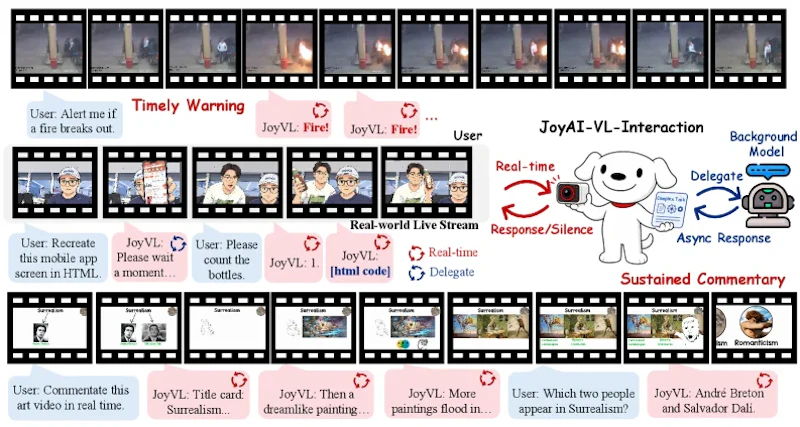
- 映像ストリームを毎秒解析し、ユーザーの入力を待たずに「沈黙・応答・委譲」を自律的に選択する新しい対話設計を実現
- AdaCodecで参照フレームと中間フレームを使い分け、長時間ビデオのリアルタイム処理をサブ秒レイテンシで達成
- DouBaoに77.6%、Geminiに87.9%の勝率を達成し、モデル・学習レシピ・データセットをすべて公開
ユーザーを待たないAIという発想
現在広く使われている視覚言語モデル(VLM)は、ユーザーが質問を送って初めて動き出す「ターンベース」の設計が主流です。しかし現実の場面では、炎が上がったり、ホワイトボードの内容が切り替わったりと、モデルが自ら気づいてほしい瞬間が無数に存在します。
「現実の多くの瞬間は、ユーザーの問いかけを待ってはくれない」という認識から、JD.com(京東)の研究チームが開発したのがJoyAI-VL-Interactionでした。映像ストリームを連続的に観察しながら、毎秒「沈黙する・応答する・バックグラウンドに委譲する」のいずれかを自律的に選択するプロアクティブな対話設計を採る。
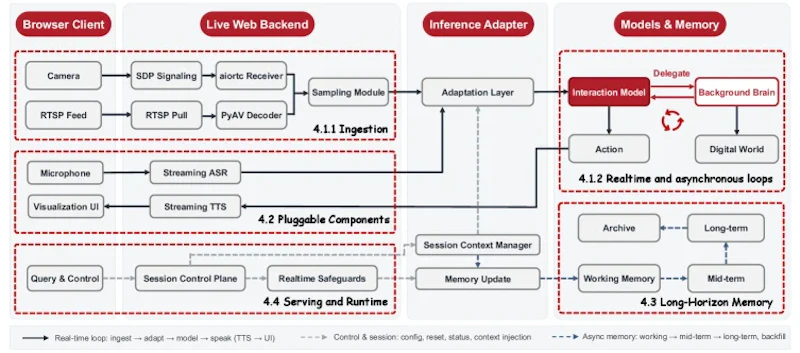
3択の行動空間とシステム設計
モデルが毎秒選択できる行動は、次の3種類に整理されています。
- 沈黙(Silent): 特に伝えるべき情報がなければ静観する
- 応答(Respond): 映像の変化やユーザーの状況に応じてテキストで話しかける
- 委譲(Delegate): 複雑な推論が必要な場合にバックグラウンドの大型モデルへ処理を回し、非同期で結果を受け取る
この3択の判断はモデル内部で完結します。ASR(音声認識)/TTS(音声合成)や3段階の階層型メモリ管理は「変換層」として外側に置き、モデルは「いつ・何を話すか」だけに集中する設計です。
サービング基盤にはvLLMを採用しており、長時間ビデオでもサブ秒のレイテンシを維持しています。
AdaCodecによる効率的な動画エンコード
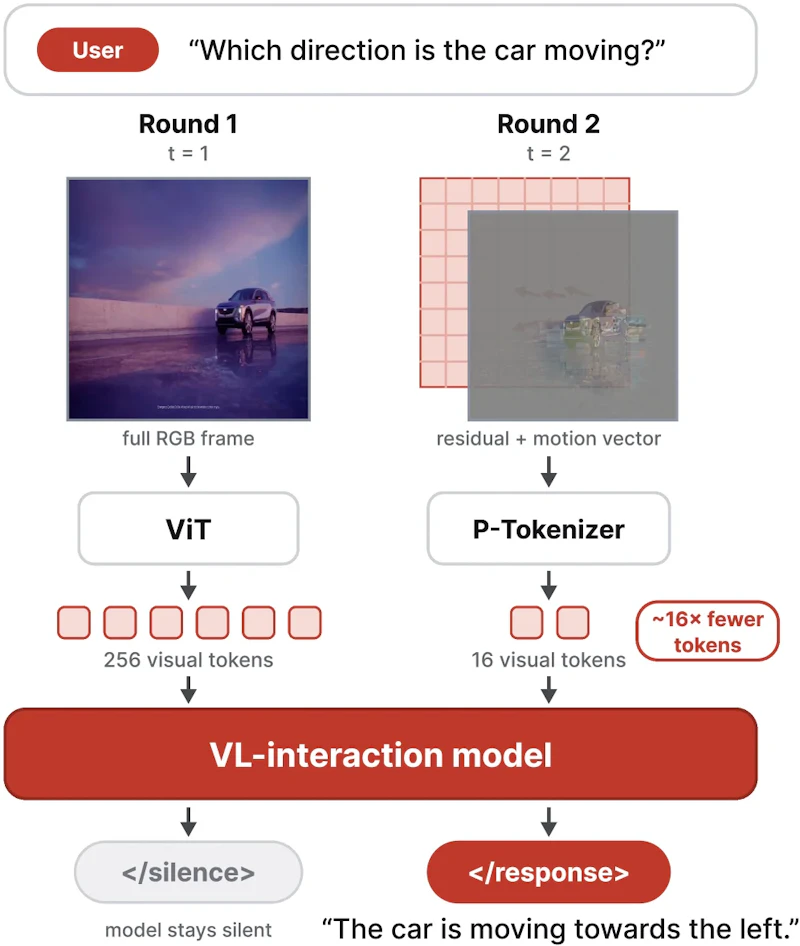
連続した映像ストリームをリアルタイムで処理するには、計算コストの削減が欠かせません。本研究ではAdaCodecという適応型動画エンコーダーを採用しました。
キーフレームには完全な視覚トークンを割り当て、その間の予測しやすいフレームは少数の圧縮トークン(P-token)でコンパクトに表現します。シーンが動的なときは詳細に、静止しているときは粗く、という動的な資源配分です。
ベースのLLMにQwen3-8B、視覚エンコーダーにQwen3-VLを組み合わせた8Bパラメータ規模のモデルは、この設計によって長時間ビデオストリームでも安定したレイテンシを実現しています。
「沈黙」を正式なラベルとして学習する
学習に使用したデータは400万件以上の時間同期済みストリーミングクリップです。警告(Alerting)、質問応答、カウント、ナレーション、雑談、委譲タスクの6カテゴリに分類されています。
設計上の工夫は、「沈黙」を「応答なし」ではなく正式なラベルとして扱う点にあります。加重クロスエントロピー損失を用いて、沈黙の継続はコストを低く、応答の開始タイミングはコストを高く設定することで、モデルが「しゃべりすぎる」問題を解消しました。長尺ビデオでは沈黙フレームが大多数を占めるため、クラス不均衡への対処が欠かせない設計でした。
DouBaoとGeminiを大幅に上回る人間評価
6つの実世界シナリオで、DouBaoとGeminiのビデオ通話アシスタントと人間による比較評価を実施しました。結果は次の表のとおりです。
比較対象 | 勝率 | 引き分け | 敗北 |
|---|---|---|---|
DouBao | 77.6% | 17.2% | 5.2% |
Gemini | 87.9% | 10.3% | 1.7% |
評価者は「応答品質」と「応答タイミング」を別々に採点しましたが、優位性が際立ったのはタイミングでした。監視シナリオでは両ベースラインに対して100%の勝率となっており、プロアクティブ型の設計が最も効果を発揮する場面と一致します。
アプリ画面操作やスライドの即興解説といった、学習データに明示的に含まれない能力が自然に現れた点も研究チームが挙げています。
長尺ビデオの処理効率という観点では、TetherCacheのKVキャッシュ管理手法も同じ課題に異なるアプローチで取り組んでいます。KVキャッシュの観点からリアルタイム処理の設計上のトレードオフを比較して読むと、理解が深まります。
まとめと今後の可能性
JoyAI-VL-Interactionは、「ユーザーが呼ぶまで待つ」という従来のVLMの前提を問い直すモデルです。3択の行動空間、「沈黙」の正式ラベル化、AdaCodecによる効率的なストリーム処理という3つの設計が組み合わさり、既存の商用ビデオ通話AIを人間評価で上回る性能に至りました。
モデルの重み、学習レシピ、データセットはすべて公開されています。常時接続型エージェントや映像監視システム、リアルタイム字幕生成などへの応用を検討する研究者・開発者にとって、すぐに試せる基盤となるでしょう。現時点では英語・中国語が主な対応言語で、多言語化は今後の課題として挙げられています。
論文情報: "JoyAI-VL-Interaction: Real-Time Vision-Language Interaction Intelligence"(Dingyu Yao et al., 2026) arXiv:2606.14777, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


