 AI-Papers
- Hugging Faceが2026年10月20日、TransformersとDiffusersのTorchTPU対応を公開。PyTorchのコードを書き換えずにGoogleのTPUで実行できる
- モデル読み込み時の
device_map="tpu"やパイプラインのpipe.to("tpu")など数行の指定で動作し、PyTorch/XLAやOptimum TPUの迂回策が不要になる - Kernels HubのPallas製カーネルを使うとMoEモデルのデコードがバッチ64で最大21.5倍高速化。Transformersのテストは96.5%が通過
TPUが普通のデバイスに
Hugging Faceは2026年10月20日、TransformersとDiffusersがTorchTPUに対応したことを公開しました。TorchTPUはPyTorchのネイティブバックエンドとして動作し、GoogleのTPU(Tensor Processing Unit、Googleが開発するAI向けアクセラレータ)を「もう一つのデバイス」として扱えるようにするものです。
これまでTPUのソフトウェアスタックはTensorFlowとJAXを中心に発展してきたため、PyTorchで書かれたコードをTPUで動かすにはtorch_xlaへの移植やJAXの学習が必要でした。TorchTPUでは通常のPyTorchコードをそのまま使い、TPU向けに調整されたPallasカーネル、分散学習、torch.compileとの統合が提供されます。
インストールはTPU VM上でpip install torch-tpu --extra-index-url https://download.pytorch.org/whl/cpuを実行します。追加インデックスを指定するのはCPU版のtorchを取得するためで、これを省くとTPUでは不要な大きなCUDAビルドが入ってきます。
数行の指定で実行できる
Transformers v5はモデル定義の参照実装という位置づけで、TPUがサポート対象のターゲットに加わりました。モデル読み込み時にdevice_map="tpu"を渡すとTPU上に直接ロードされ、入力を.to("tpu")で移せばgenerateはそのまま動きます。既定ではeagerモードで実行され、性能を求める場合はtorch.compileや分散構成を併用します。
DiffusersでもTPUは第一級のデバイスとして扱われ、eagerモードならpipe.to("tpu")だけで済みます。コンパイル実行ではpipe.transformer.compile(backend="tpu", fullgraph=True, dynamic=False)のように1行を追加します。1チップに載らない大きさのモデルはfrom_pretrainedにTensorParallelConfigを渡すことで、読み込み時にTransformerを複数チップへ分割できます。標準で対応していないパイプラインにはtp_planを指定します。
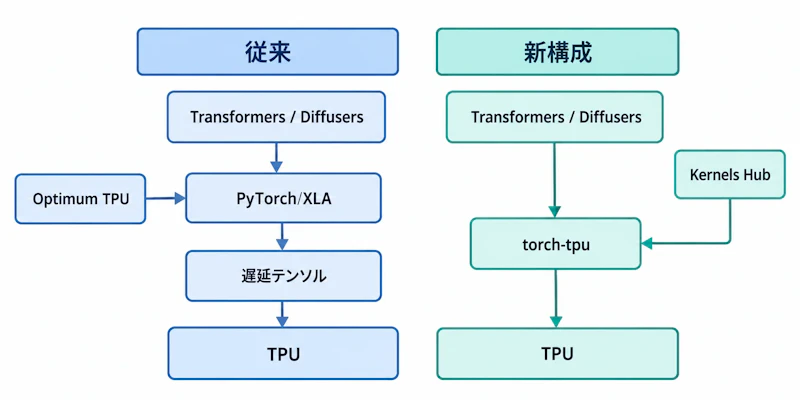
図1のように、従来はTransformersやDiffusersとTPUの間にPyTorch/XLAの遅延テンソルや別実装のOptimum TPUが挟まっていました。TorchTPUではこの層が整理され、Diffusers側にTPU専用のフォークを置く必要もなくなります。
Diffusersの実測値
公開された計測はCloud TPU v6e-4、テンソル並列数4、bf16、バッチサイズ1の条件で行われたものです。コンパイル実行とeager実行の差は次の通りです。
条件 | コンパイル | eager |
|---|---|---|
Qwen-Image-2.1、1024×1024、40ステップ | 3.5秒 | 8.0秒 |
動画生成、1344×768、5.2秒・49ステップ | 188秒 | 262秒 |
画像生成では2.3倍ほど、動画生成では1.4倍ほどの差が出ています。ただし最初の呼び出しではコンパイルの時間が加算され、コンパイル済みのグラフは特定の画像サイズに紐づくため、サイズを変えると再コンパイルが走ります。生成の高速化はモデルやデコード手法の側でも進んでおり、推論経路の工夫で動画生成を1.5倍速くするSpeculative Forcingのような研究と組み合わせる余地もあります。
Kernels HubのTPUカーネル
Hugging FaceのKernels Hubには、すぐ使えるTPU向けカーネルが置かれています。TPUのカーネルはハードウェアを細かく制御できるPallasで書かれており、GoogleのTokamaxライブラリのカーネルも利用できます。記事の例では、MoE(Mixture of Experts、入力ごとに一部の専門家ネットワークだけを使う構成)モデルにexperts_implementation="tokamax_ragged_dot"としてragged-dotカーネルを差し込んでいます。
TPU v6e-8上で既定のgrouped_mm実装と比較した結果、バッチサイズ64のデコードで次の差が報告されました。
モデル | デコードの高速化 |
|---|---|
Qwen3-30B-A3B | 21.5倍 |
Gemma 4 26B-A4B | 12.8倍 |
この差はバッチサイズが大きくなるほど広がるとされています。MoEの専門家ごとの行列積はサイズが揃わず既定実装では無駄が出やすいため、専用カーネルの効果が出やすい部分です。
完成度と残る課題
TransformersのテストスイートはTPU上で実行されており、TPUで走るテストのうち96.5%が通過しています。Hugging Faceはこれを「まだ全部が緑ではない」と表現しており、TorchTPUのリポジトリへ34件の問題を報告し、そのうち19件が修正済みとしています。TransformersのCIダッシュボードにはTPUのナイトリー実行を追加する計画です。
TPUでの実行はTransformers側のバグも表面化させました。StaticCacheやQwen3のテンソル並列プランの不具合が見つかり、上流で修正されています。Optimum TPUはTransformersとDiffusersのモデルを動かす目的では不要になりますが、CUDA一択だった実行環境に別の選択肢が加わるという意味で、学習・推論のコスト構成を見直す材料になります。利用にあたってはGoogle Cloud上のTPUが前提で、問題はGitHubのIssueとして報告するよう案内されています。


