 AI-Papers
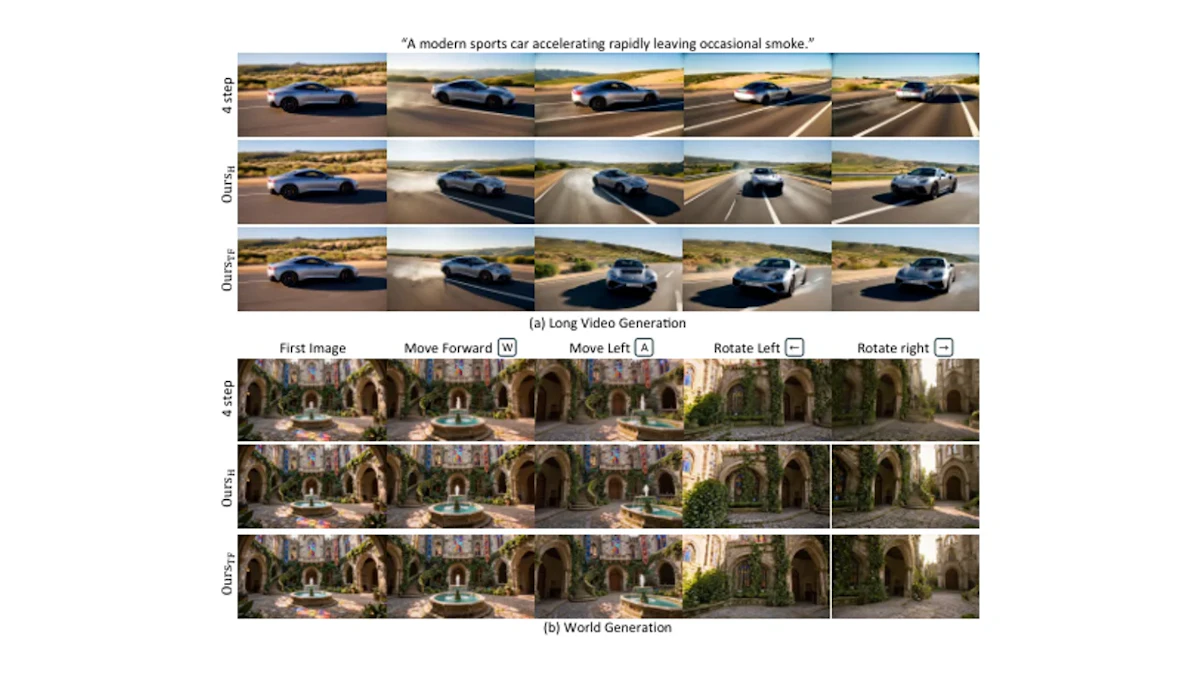
- 少ステップ自己回帰動画生成で、途中のクリーン推定を「下書き」とみなしトークンごとに早期確定する手法 Speculative Forcing が提案されました
- LongLive では平均1.68ステップ・41.74fps と4ステップ版の約1.58倍、Lingbot-World 2.0 でも約1.35倍を、VBench スコアを落とさずに達成しています
- 学習済みの軽量ヘッド(約410万パラメータ)と学習不要の検証器の2種類が用意され、生成モデル本体は凍結したまま後付けできます
研究の背景
リアルタイムに動画を作る自己回帰動画生成モデルは、拡散(ノイズを少しずつ取り除いて映像を作る仕組み)のステップ数を4回程度まで削った「少ステップ」設計が主流になっています。それでも計算は重く、すべてのトークン(映像を分割した潜在表現の単位)が一律に最後のステップまで処理される点が無駄になっていました。
実際には、トークンごとに必要な精製量は大きく異なります。本研究の著者ら(NAVER AI Lab と KAIST の Hyunwook Choi らのグループ)は、ノイズ除去の途中で各チャンクの予測が4ステップ出力にどれだけ近づくかを可視化し、収束の早さに明確な偏りがあることを示しました。
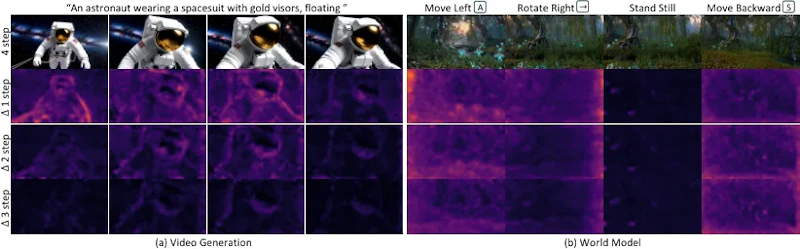
図1のとおり、動画生成では過去フレームと似た背景や動きの少ない物体領域が早い段階で収束します。一方、カメラが動いて新しい景色が現れるワールド生成では、既に見えていた領域が先に落ち着き、新たに露出した領域だけが長くノイズ除去を必要とします。
提案手法
Speculative Forcing は、この偏りを Large Language Model(LLM)の投機的デコード(小さなモデルの下書きを本体が検証して受理する高速化手法)になぞらえて活用します。途中ステップのクリーン推定を「下書き」と見立て、検証器が十分に収束したと判断したトークンをその場で最終出力として凍結し、以降のノイズ除去から外す仕組みです。
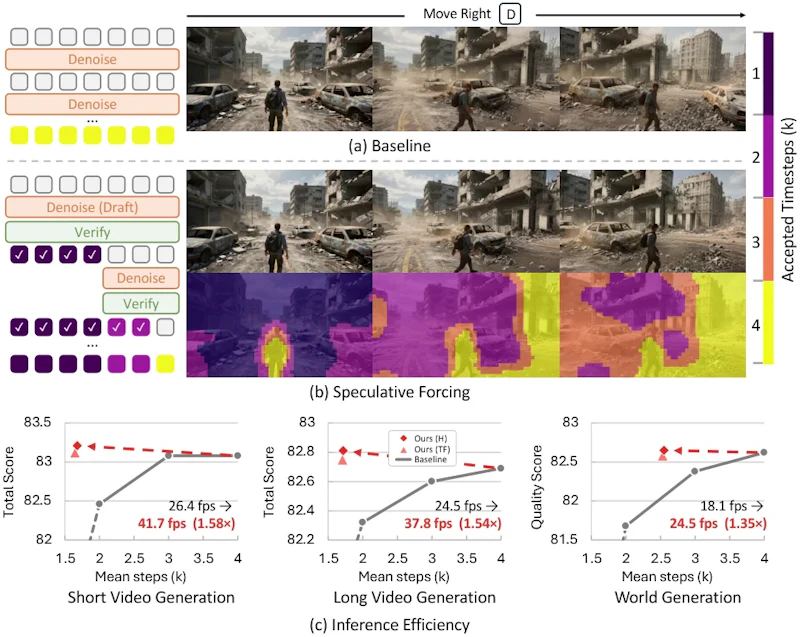
図2が全体像を示しています。確定したトークンは、受理した時点で計算済みのキーとバリュー(Attention が参照する内部表現)をそのまま残すため、まだ精製を続ける他のトークンは確定済みの内容を文脈として参照できます。チャンクの処理が終わった後にタイムステップ0でのクリーンなパスを1回だけ走らせ、全トークンのキャッシュを完成版の出力で更新してから次のチャンクに進みます。
検証器は2通り用意されています。学習不要版は、1ステップ目では下書きが過去フレームや参照トークンにどれだけ近いかという冗長性を、2ステップ目以降は連続する下書き間の変化量という安定性を見て、2つの閾値で判定します。学習版は、凍結した生成モデルの最終ブロックの隠れ状態を読み取り、各トークンが4ステップ出力までどれだけ離れているかを予測する浅いヘッドで、レイヤー正規化と3層の3次元畳み込みからなる約410万パラメータの小さな構造です。許容度εは再学習なしに推論時に変更できます。
実験結果
評価には LongLive(1.3B)と Lingbot-World 2.0 の Causal-Fast モデル(1.3B)を、いずれも4ステップ設定のまま凍結して使っています。計測は NVIDIA H100 1枚で、VAE のエンコードとデコードは除外した値です。
設定 | 手法 | 平均ステップ | FPS | 品質スコア |
|---|---|---|---|---|
LongLive 5秒 | 4ステップ | 4.00 | 26.40 | 83.08 |
LongLive 5秒 | 学習不要検証器 | 1.65 | 43.61 | 83.12 |
LongLive 5秒 | 学習済み検証器 | 1.68 | 41.74 | 83.21 |
LongLive 30秒 | 4ステップ | 4.00 | 24.5 | 82.69 |
LongLive 30秒 | 学習済み検証器 | 1.72 | 37.8 | 82.81 |
Lingbot-World 2.0 | 4ステップ | 4.00 | 18.1 | 82.62 |
Lingbot-World 2.0 | 学習済み検証器 | 2.55 | 24.5 | 82.65 |
LongLive の短尺設定では、平均1.7ステップ程度で4ステップ版と同等以上のスコアを保ちながら1.5倍以上の高速化が得られました。30秒の長尺でもドリフト(時間が経つほど映像が崩れる度合い)は1.722から1.707へわずかに改善し、品質劣化なしでの加速が確認されています。
視点が絶えず変わるワールド生成では平均2.55ステップを要し、加速率は1.35倍にとどまりました。新しく現れる領域が多いほど早期確定できる余地が減るという、図1の観察と整合する結果です。カメラ位置推定の誤差(RPE)も4ステップ版とほぼ同じで、幾何的な一貫性は保たれています。
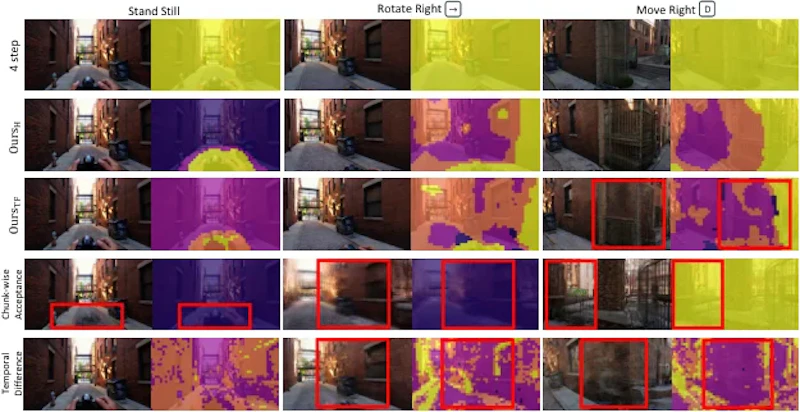
図3はアブレーションの定性比較です。チャンク単位でまとめて確定すると、早すぎる受理による誤りが後続チャンクへ伝播し、品質82.54・ドリフト3.214とトークン単位(82.65・2.839)に劣りました。動き量に基づく検証はカメラ由来の変化と歪みを区別できず、品質80.97まで下がっています。学習済み検証器は、4ステップ出力を実際に計算して比較するオラクル検証(82.61)に並ぶ82.65を記録しました。
まとめと今後の展望
生成モデルを再学習せずに後付けでき、許容度の調整で速度と品質のバランスを変えられる点が実用上の利点です。推論の効率化という文脈では、離散表現の工夫で画像生成を加速したIntern Lumina U2のような研究とも方向性が重なります。
一方で、著者らは制約も率直に挙げています。
- 加速率はモデルと領域に依存し、視点変化の大きいタスクでは早期確定の余地が減る
- チャンクは最後の1トークンが確定するまで走るため、平均ステップ数がそのまま速度に直結しない
- キャッシュ更新のクリーンなパスが1回加わるため、理想的な加速率は5/(平均ステップ+1)程度が上限
- 学習不要版は閾値2つの較正、学習版は凍結モデルからのロールアウト収集が必要
評価が2つの生成モデルとそのベンチマークに限られている点も残された課題でしょう。とはいえ、トークンごとに計算量を割り振るという考え方自体は汎用性が高く、他のストリーミング型生成やワールドモデルへの展開が見込まれます。
論文情報: "Speculative Forcing for Efficient Autoregressive Video Generation"(Hyunwook Choi et al., 2026) arXiv:2610.22347, CC BY 4.0
本記事の図(図1〜図3)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


