 AI-Papers
- Google DeepMindが2026年7月30日にロボット向け基盤モデル「Gemini Robotics ER 2」を発表し、連続する動画から作業の進み具合を追跡して自己補正する機能を搭載した
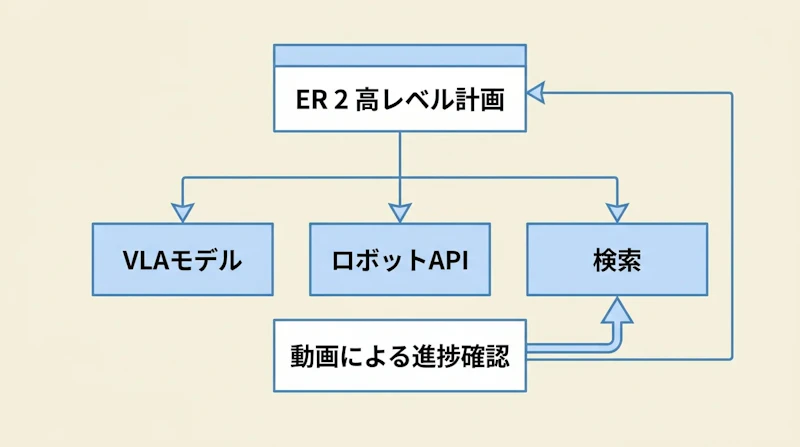
- VLAモデルやロボット制御APIをツールとして呼び出し、形状の異なる複数のロボットを協調させる高レベルの司令塔として動作する
- 動画内の特定の瞬間を探すモーメント検出で91.3%の精度を記録し、実行速度は従来比4倍で1秒未満の遅延を達成、Gemini APIやGoogle AI Studioで利用できる
ロボット向けの司令塔モデル
Google DeepMindは2026年7月30日、ロボット向けの基盤モデル「Gemini Robotics ER 2」を発表しました。ERは Embodied Reasoning(身体化された推論)の略で、カメラ映像などから周囲の空間を把握し、複数ステップにわたる作業計画を立てる役割を担います。
このモデルは、ロボットの「高レベルの脳」として位置づけられています。実際に手足を動かす下位のモデルを指揮しながら、ロボットがその指示に沿って動作を同時に実行する構成です。前世代の Gemini Robotics ER 1.6 からのアップグレードにあたり、動画理解、ツールの呼び出し、複数ロボットの協調という3点が新たに強化されました。
動画で進捗を追跡し自己補正
今回の更新で中心となるのが、連続した動画フィードを理解する能力です。ER 2は作業の進み具合を0%から100%まで5段階に分類し、実行中の状況をリアルタイムで監視します。これにより、途中で何かがうまくいかなくなった場合でも、ロボットが状況を検知して動作を調整できるようになりました。
動画内の特定の瞬間を見つけるモーメント検出では、91.3%の精度と0.96秒の平均絶対誤差を記録しています。作業段階を分類する進捗分類の精度は57.4%で、成功と失敗の判定や計器の読み取りといった空間推論の場面で改善が示されました。従来は動作の完了を外部から確認する必要がありましたが、ER 2はモデル自身が経過を把握して次の判断につなげます。
VLAモデルをツールとして呼び出す
ER 2は、VLA(Vision-Language-Action、視覚と言語から行動を生成する)モデルやロボット制御APIを「ツール」として呼び出せます。作業全体を計画するER 2が、個別の動作を担うVLAモデルを必要に応じて起動する分業の仕組みです。軽量なVLAモデルの動向についてはTurboVLAの解説記事もあわせて参照できます。
呼び出せるツールにはGoogle検索やユーザーが独自に定義した関数も含まれます。通信には Gemini Live API を用いた双方向ストリーミングを採用し、ロボット制御に必要な低遅延の応答に対応しました。
複数ロボットの協調動作
ER 2は、車輪型のローバーやヒューマノイドなど、形状の異なるロボット同士を通信させて協調させられます。1台では完結しない複雑な作業を、それぞれ得意分野を持つ複数の機械に分担させる使い方を想定しています。
身体を持つAI(身体性AI)の分野では、計画から動作までを一つのモデルで担う手法と、役割を分けて組み合わせる手法の両方が研究されています。ER 2は後者に位置づけられ、司令塔となるモデルが複数の実行役を束ねる方式をとります。
性能と提供状況
実行速度は前世代と比べて4倍に高速化し、1秒未満の遅延を実現しました。安全性の面では、指示に従う安全性(Safety Instruction Following)と人との距離を保つ挙動(Human Proximity)のベンチマークで、前世代のER 1.6を上回る結果が示されています。
Gemini Robotics ER 2は、Gemini APIとGoogle AI Studioを通じて開発者が利用できます。企業向けの Gemini Enterprise Agent Platform ではプライベートプレビューとして提供が始まりました。Google DeepMindは、ロボット向けモデルの空間推論と安全性の強化を継続する方針を示しています。


