 AI-Papers
- Gemini 4 Argonは身体性推論ベンチマークERQAで87%を記録し、推論のみでフロンティアモデル中の最高値となった
- ロボットカメラ映像、人間の一人称動画、手描きスケッチからMuJoCoのシミュレーション環境を生成するReal2Simを実証
- 4,500本以上のドメインランダム化エピソードでVLAを微調整し、実機成功率56%から75%、所要時間35秒から24秒に改善
公開の概要
Googleは2026年10月13日、開発者向けブログでGemini 4 Argonをロボティクスに適用した事例をまとめて公開しました。執筆はPrincipal Software EngineerのKanishka Rao氏で、同モデルを汎用の物理推論モデルとして位置づけ、物理理解、コード生成、視覚と意味の統合推論における段階的な進歩だと説明しています。
定量的な裏付けとして挙げられたのが、身体性推論を測るERQA(Embodied Reasoning QA)ベンチマークの87%という値です。追加の学習や専用の制御モジュールを使わず、純粋な推論のみでこのスコアに達したとされています。記事は、ロボット制御、Real2Sim、物理理解、研究と自己改善の4領域に分けて事例を示す構成です。
シミュレーションで予習する制御
ロボット制御の例では、Boston Dynamicsの四足ロボットSpot(12自由度の脚と6自由度のアーム)が、足踏み式ペダルのゴミ箱を開けて空き缶を投入する課題に取り組みました。Argonはいきなり実機を動かすのではなく、関節構造を持つMuJoCoのデジタルツインを自ら構築して動作を練習させ、足と手をそれぞれ検証する2体のエージェントが位置合わせを確認してから実行に移す流れを取ります。
単純なアームでのゼロショット制御では、2cm刻みのグリッドを重ねた視覚座標系を手がかりに、倒れたマグカップを立ててから丸めたナプキンを中に入れる動作を達成しました。呼び出しの粒度は、2回から4回で済ませる粗い制御、把持前にホバーして確認する4回から7回、視覚サーボで追い込む8回から20回の3段階が用意されています。さらにGemini Omni World Modelを閉ループで操作し、33ステップでスクラブルの5枚のタイルをA-R-G-O-Nの並びに整える例も示されました。
Real2Simの3つの入力
Real2Simは、現実の観測からシミュレーション環境を作り出す工程です。Argonは入力の種類ごとに異なる検証条件を課しており、図1のように3系統の入力が共通のMuJoCoシーン生成と検証に合流します。
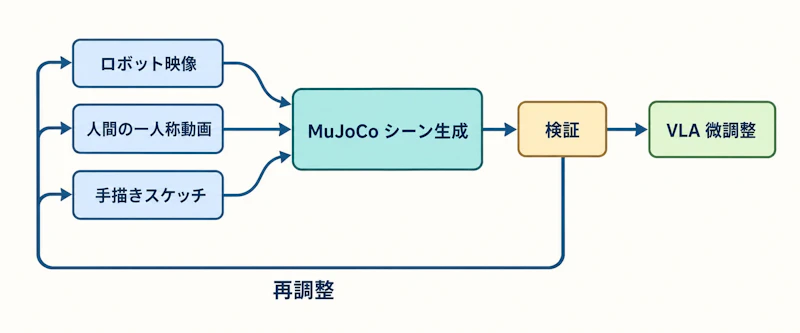
遠隔操作のログからシーンを再現する場合は、描画結果と指先の接触力が実機の記録と一致するまで物体アセットと指令値を調整します。このとき外力の付加や衝突判定の無効化、記録された触覚値の流用は禁止され、計画された指令は腕の関節で0.55ラジアン、手の関節で0.65ラジアン以内の逸脱に抑えられます。人間の一人称動画からの変換では、手の動きを22自由度の5本指ハンドを備えた76自由度の双腕ヒューマノイドへ転写し、500Hz(dt=0.002秒)で力学的な閉じ込めと2cm以上の持ち上げ、安定した設置を確認します。手描きスケッチからはmujoco_warpのシーンを生成し、Apollo 2ヒューマノイドがボールを投げて6個の箱のピラミッドを崩す動作を50Hzの140ステップ(2.80秒)で成立させ、骨盤の横ずれ3cm未満と6個すべての転倒を検証結果として報告しています。
現実とシミュレーションの差をどう埋めるかは、ロボット向け世界モデルの研究でも中心的な課題です。反事実データで世界モデルの欠陥を減らす取り組みとしてはDreamTrueとは?反事実ポストトレーニングでロボット世界モデルの欠陥率を6.25%にも参考になります。
自己改善による数値の変化
研究と自己改善の節では、生成したシミュレーション環境を学習データの供給源として使う流れが示されました。卓上の写真1枚から9個の小道具を再構成したMuJoCoツインを作り、77タスクのカリキュラムを定義した上で、物体姿勢を±10cm振るドメインランダム化によって4,500本以上のエピソードを書き出します。これをVLA(Vision-Language-Action)モデルの微調整に用いた結果が、以下の数値です。
項目 | 改善前 | 改善後 |
|---|---|---|
実機でのタスク成功率 | 56% | 75% |
タスク完了までの時間 | 35秒 | 24秒 |
SO-101の把持搬送(1回目と3回目) | 58.9秒 | 17.4秒 |
6自由度アームSO-101での反復では、1回目58.9秒、2回目22.9秒、3回目17.4秒と短縮が進み、2回目は箱の縁をかすめた一方で3回目は中央に落とせたと記載されています。安全の制約内で2倍以上の高速化を目標に据えた点も明記されました。
論文68本をブラウザで再現
既存研究の再現も試されています。DeepLoco、HUSKY、Whole-Body MPC、ANYmal Cを用いた大規模並列深層強化学習といった論文を、MuJoCoのWebAssembly版で動く対話型サンドボックスへ移植し、合計68本を用意したとしています。検証はヘッドレスのChromiumで300フレーム以上動かし、コンソールエラーが0件かつタスク進行度が0でないことを条件としました。
Gemini 4 Argonはモデル識別子gemini-4-argonで提供され、利用経路は次のとおりです。
- Google AI Studio(Google AI Ultra契約者向け)
- Gemini APIの有料ティア(Interactions API経由、
google-genaiSDKが初日から対応) - Google Antigravity(計画立案や
/goal実行、マルチエージェント連携)
今回示された事例は、物理シミュレータの構築からデータ生成、学習、検証までを1つのモデルが一貫して担う開発フローを前提にしています。シミュレーション側の不正を禁じる条件や自動検証の基準が具体的に示されているため、再現性を確認しながら自社の環境に当てはめる余地も残されています。



