 AI-Papers
- Gemma 3 270Mで全パラメータの約63%を占める埋め込み層を、PCAの符号から作る512bit固定コード(16MB)に置き換える手法が提案されました
- 同一の2.05Bトークンで学習した比較では、学習パラメータが1/2.6でもLAMBADA・HellaSwag・PIQAは学習型と同等以上の成績でした
- 三値(BitNet b1.58)版は46MBのファイルに収まり、ノートPCのCPUで615〜740 tok/s、8bit GGUF比で5〜6倍の生成速度を記録しました
研究の背景
小型の言語モデルでは、語彙の埋め込み層(トークンをベクトルに変換する巨大な対応表)がパラメータの大半を占めます。Gemma 3 270Mの場合、268Mパラメータのうち168Mが埋め込みテーブルです。
さらに厄介なのは量子化との相性です。本体の重みを4bitや8bitに落としても、埋め込みは精度劣化を避けるため16bitのまま残されることが多く、圧縮後のファイルサイズでは埋め込みが支配的になります。つまり小型モデルを本気で小さくしたいなら、語彙そのものを作り直す必要があるという問題設定です。
arXivに公開された「Embeddings Are Overpriced?」(Sai Kiran Bathula著)は、この埋め込みテーブルを学習パラメータを一切持たない固定テーブルで置き換えられるかを検証した単著の論文です。重み、学習データ、問題ごとの評価結果まで公開されており、追試しやすい点も特徴といえます。
埋め込みを512bitに圧縮
手法は驚くほど単純です。Gemma 3 270Mの学習済み埋め込み行列(262,144語 × 640次元)を中心化し、分散の大きい上位512方向に射影したうえで、各成分の符号だけを残します。1語あたり512bit、全体で16.8MBの固定コード表が一度だけ作られ、その後は学習中も推論時も変化しません。
図1のように、このコード表はモデルの入口と出口の両方で使われます。入力側は512bitのコードを小さな線形写像(512→640)で本体に渡し、出力側は本体の最終状態を別の写像(640→512)で変換し、全語のコードとの内積でスコアを計算します。学習されるのはこの2つの写像の0.65Mパラメータだけです。
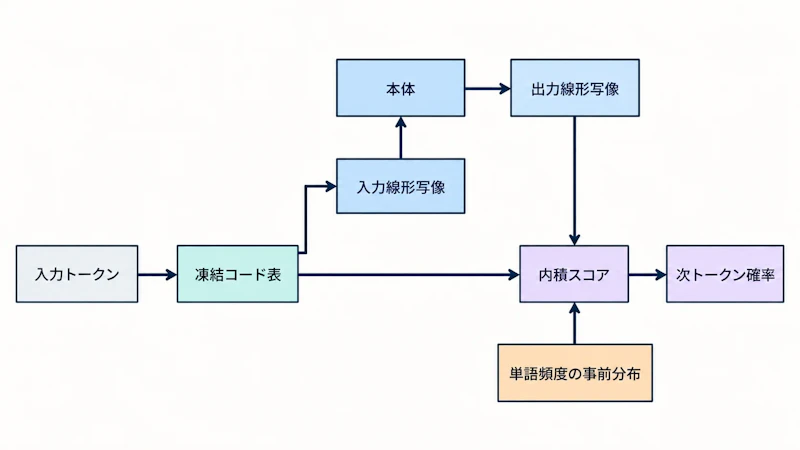
スコアには、各語の出現頻度の対数を固定値として足す事前分布(1MB、学習パラメータなし)が加えられます。符号化による情報の損失は小さく、上位512方向で元の分散の92.3%を保持し、単語類似度のベンチマークWordSim-353では相関0.617と、元の実数埋め込みの0.614をわずかに上回りました。
3つの構成を同条件で比較
検証はGemma 3 270Mと同形の本体をランダム初期化から学習する形で行われました。構成Aは通常の学習型埋め込み(学習パラメータ268.1M)、構成Bは凍結テーブル+実数本体(101.0M)、構成Cは凍結テーブル+三値本体(101.2M)です。
学習データはFineWeb-Eduから2.05Bトークンで、3構成すべてが同一のバッチを同じ順序で見ます。計算コストはRTX 5090 1枚で1構成あたり14〜16時間、約18ドルで、研究全体でも75ドル未満に収まったと報告されています。小規模ゆえの手堅い実験設計です。
実験結果と推論速度
検証損失では学習型のAが0.203ナット有利でしたが、下流タスクの結果は単純な優劣になりませんでした。凍結テーブルのBはLAMBADAで+1.6ポイント上回り、HellaSwagとPIQAは統計的に同等、ARC-Easyのみ3.4ポイント劣るという結果です。
構成 | LAMBADA | HellaSwag | ARC-Easy | PIQA | 検証損失 |
|---|---|---|---|---|---|
A(学習型・実数) | 21.6 | 30.4 | 45.9 | 60.6 | 3.155 |
B(凍結・実数) | 23.2 | 30.4 | 42.5 | 61.5 | 3.358 |
C(凍結・三値) | 22.5 | 29.4 | 41.0 | 59.5 | 3.439 |
差が明確に出たのは低頻度語です。学習データ中に10〜99回しか現れないトークンでは、BがAを2.34ナット、CがAを1.70ナット上回りました。Gemmaの語彙262,144語のうち52,782語は学習データに一度も登場しないため、学習型テーブルはこうした語の表現を育てられないまま終わります。一方、頻出161語(本文の52%を占める)ではAが0.035ナット優位で、差はほぼ消えます。
実用面で目を引くのは三値版Cの軽さです。専用カーネルで動かすと46MBのファイル、ピークメモリ62MBで615〜740 tok/sを出し、Aの8bit GGUF(116 tok/s、471MB)と比べて5〜6倍速く、メモリは約1/7でした。CPUだけで動く小型モデルの選択肢として現実的な水準です。
学習後の語彙拡張も凍結テーブルの利点になります。生物医学系の1万語を追加学習なしで足したとき、損失の悪化はBで3.3%、Cで3.1%にとどまったのに対し、Aは42.9%悪化しました。埋め込み空間上の任意のベクトルをそのまま新語にできる設計が効いています。こうした「学習済みパラメータに頼らず外部の表を使う」発想は、COUNTとは?n-gramカウントをCPUメモリに置きLLMを計算量57%増相当に強化で紹介した手法とも通じるところがあります。
限界と今後の展望
著者自身が複数の制約を挙げています。学習は各構成1シードのみで、誤差範囲は評価問題のばらつきしか反映していません。また2.05Bトークンでは学習型テーブルが十分に育っておらず、トークン予算を増やせばAの優位が広がる可能性があります。
構成Cは三値本体・BitNet由来の学習スケジュール・事前分布の学習という3点がBと同時に異なるため、どれが効いたかの切り分けは不完全です。速度比較もノートPC 1台かつ実装基盤が異なる比較で、生成速度に限られます。コードはGemma 3 270Mの埋め込みから導出されるため、公開物はGoogleのGemma利用規約に従い非商用研究向けという制約も残ります。
とはいえ、埋め込みに巨大な学習パラメータを割く慣習が小型モデルでは必ずしも割に合わないという指摘は示唆的です。端末上で動く小さなモデルの設計において、語彙の扱い方を見直す余地があることを具体的な数値で示した研究といえます。
論文情報: "Embeddings Are Overpriced? A Frozen 16 MB Vocabulary for Small and Ternary Language Models"(Sai Kiran Bathula, 2026) arXiv:2610.22428


