 AI-Papers
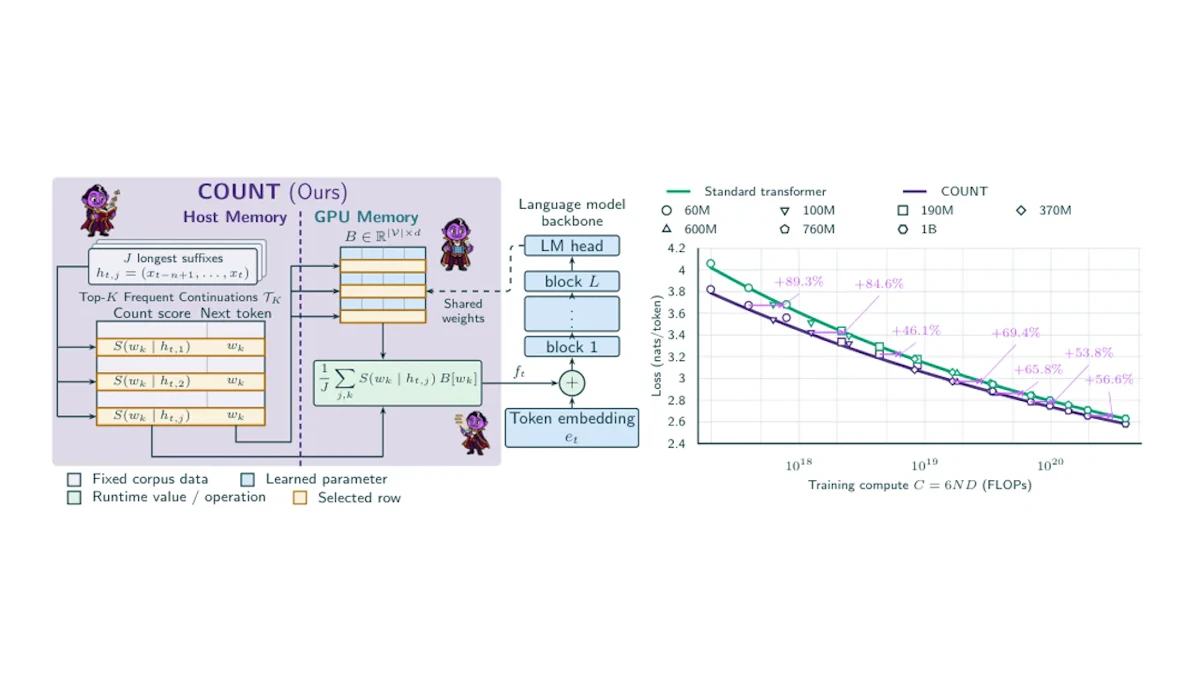
- 事前に数えたn-gramの出現回数をホストCPUのメモリに置き、学習パラメータを増やさずにTransformerの入力を補強する手法COUNTが提案されました
- 1Bモデルの事前学習で、検証損失は計算量46〜89%増(アブストラクト記載の代表値は57%増)の標準モデルに相当する改善を示しました
- 推論時にドメイン別のカウント表へ差し替えるだけで、追加学習なしに数学・法律などの領域へ適応できます
研究の背景
言語モデルの性能は長らく計算量の関数として語られてきました。学習に投じる演算量を増やし、パラメータとデータを同時に拡大すれば損失が下がるという経験則です。
これに対して近年は、計算量とは別の軸としてメモリを拡大する方向も探られています。その代表がn-gram埋め込み(連続するn個のトークンの並びごとに用意した追加の埋め込み表)で、直前の文脈に対応するベクトルを引いてモデルの入力に足し込みます。ただし既存手法はこの表をゼロから学習するため、高価なGPUメモリを大量に食います。
Ian Magnusson氏らの研究チームが提案したCOUNT(Counting Offline Unlocks N-gram Transformers)は、学習パラメータを一切追加せずにこの方向を追求します。コーパスから事前に数え上げたn-gramの出現回数を、学習中はほとんど使われないホスト側のシステムメモリに置き、そこから組み立てた埋め込みを入力に加えるという設計です。
COUNTの仕組み
COUNTが参照するのは、各n-gram履歴について「次に来やすいトークン上位K個」とそのスコアを収めた凍結済みの表です。スコアにはstupid backoff(観測された続きには出現回数の比を使い、見つからなければ短い履歴へ0.4の割引を掛けて後退する簡便な推定法)を用いており、正規化のやり直しはしません。
肝心なのは、この表から埋め込みを作る方法です。COUNTは新しい埋め込み行列を持たず、モデル自身のunembedding行列(出力側でトークンを予測するために使う行列)の該当行をスコアで重み付けして足し合わせます。n-gramの次数ごとに計算して平均したベクトルを、通常のトークン埋め込みに加算してTransformerへ入力します。
図1の左側がこの流れです。参照表はGPU上に置く必要がないため、学習時はホストRAMへオフロードできます。1Bモデル向けの主要な表は797.5GBに達しますが、これは普段遊んでいるメモリを使い切る形で性能に変換したことを意味します。
実験結果
実験はOLMo-coreの60Mから1Bまでのモデル列をDolma 3で学習し、トークン対パラメータ比10、20、40の条件でスケーリング則を当てはめる形で行われました。n-gramは6次まで数え、評価は11ソースの言語モデル検証損失、74構成のタスク損失(bits per byte)、41構成の多肢選択正解率で行っています。
指標 | COUNTが相当する標準Transformerの計算量増分 |
|---|---|
言語モデル検証損失 | 46〜89%増 |
タスク損失(bits per byte) | 6〜56%増 |
学習スループット(1B) | 標準の93.1〜97.8%を維持 |
アブストラクトが掲げる「計算量57%増に相当」は、1Bモデルの検証損失改善をこの範囲の代表値として示したものです。下流タスクの正解率もほぼすべての予算で標準Transformerを上回りましたが、損失に比べるとばらつきが大きいと報告されています。
比較の本題は学習型n-gram埋め込み(Over-Encodingなど)との対決です。学習パラメータの予算を固定すると、試したすべてのスケールでCOUNTが最良の損失を記録しました。学習型の表はバックボーンのパラメータとGPUメモリを奪い合うのに対し、COUNTの表はホストRAMに留まるためです。AI向けGPU比較2026で論じられるようにVRAM容量が制約になりやすい環境では、この違いがそのまま実利になります。
訓練不要のドメイン適応
もう一つの成果が、学習を挟まない適応です。推論時に数学・生物医学・法律のカウント表(各80〜83GB程度)へ差し替え、汎用表のスコアと係数0.25で補間すると、3領域すべてでタスク損失が下がりました。正解率の改善は数学と法律で明確だった一方、生物医学は結果がまちまちでした。
汎用表を推論時に17.1GBまで縮めた条件でも標準の1B Transformerを上回っており、1桁以上の圧縮に耐える余地があることが示されています。表は行を書き換えれば内容を修正・追加できるため、小規模なドメインデータからでも有用な事前知識を注入できる、というのが著者らの見立てです。
まとめと今後の展望
COUNTは、計算量一辺倒のスケーリングに対して「空いているホストメモリを使う」という別経路を具体的な数字で示しました。学習パラメータを増やさないため、同じGPU予算をバックボーンに集中させられる点が実装上の強みです。
ただし課題も残ります。検証は1Bパラメータまでで、より大規模なモデルで同じ比率の恩恵が続くかは未確認です。スループットはわずかに低下し、生物医学のような領域では適応効果が安定しませんでした。高次のn-gramカウントは珍しい文脈では原文の断片を露出させうるため、学習コーパスの扱いにも配慮が必要になります。メモリを計算量の代わりに使うという発想がどこまで伸びるかは、今後のスケール拡大を待つことになります。
論文情報: "The COUNT: Counting N-grams Unlocks Scaling on Host Memory and Training-Free Adaptation"(Ian Magnusson, Noah A. Smith, Pang Wei Koh, 2026) arXiv:2610.20456, CC BY 4.0
本記事の図(図1)とサムネイルは上記論文より引用しています(縮小・形式変換あり)。


