 AI-Papers
- 拡散モデルのオンライン強化学習で、プロンプト単位に報酬をまとめてから方向を決める「集約優先の報酬傾斜」を提案した研究です
- EMA(指数移動平均)の役割は実はオフポリシー学習ではなくモデルの復元にあると分析し、二段更新と信頼領域マスクで置き換えました
- HunyuanVideo-13B では DiffusionNFT と同水準の報酬に 12.02 倍少ない GPU 時間で到達し、平均報酬も 28.8% 上回りました
研究の背景
画像や動画を生成する拡散モデルは、事前学習だけでは人間の好みや指示への忠実さが十分とは言えません。そこで、生成結果に点数を付ける報酬モデルを用意し、強化学習(RL)で後追いに調整する手法が広がっています。報酬モデルが微分可能である必要がない点が魅力で、美的品質や動きの自然さといった「数式で書きにくい」評価軸も扱えます。
ただし既存手法には明確な弱点がありました。Flow-GRPO のように生成の逆過程(ノイズから画像へ向かう軌跡)を方針とみなす手法は、最終的な報酬を途中の各ステップにどう割り振るかというクレジット割当が粗く、学習効率が上がりません。一方、DiffusionNFT のように順過程(画像にノイズを足す向き)側で学習する手法は効率が良い反面、EMA を使ったオフポリシー学習の設定を丁寧に調整しないと学習が崩壊します。
DiffusionART(Diffusion Reinforcement with Aggregation-first Reward Tilting)は、この二つの課題を同時に解こうとした手法です。arXiv に 2026 年 10 月 8 日付で投稿され、HuggingFace Daily Papers でも上位に入りました。
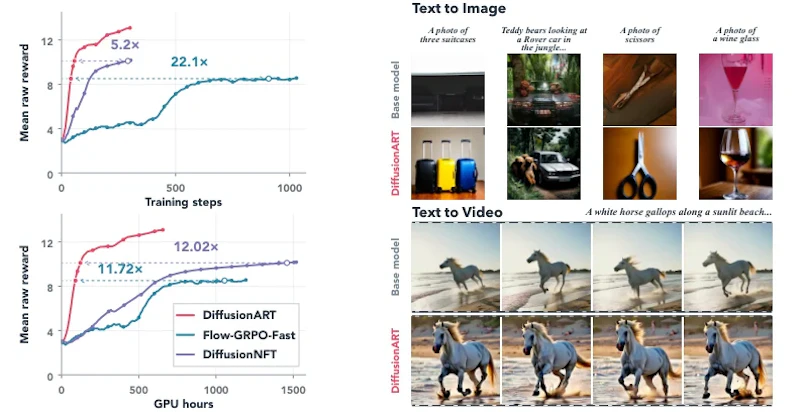
図1の左側を見ると、報酬の立ち上がりが既存手法より明らかに早く、右側では同じプロンプト・同じシードでも細部の破綻が減っていることが読み取れます。
隠れていた一致力とEMAの正体
著者らはまず、DiffusionNFT 系の学習目標を分解して分析しました。その結果、更新に働く力は「報酬を改善する方向」と「順過程と逆過程の食い違いを埋める方向」の二つに分かれることが示されます。後者はforward-reverse consistency force(順逆一致力)と呼ばれ、報酬の改善には寄与しません。正例と負例を同時に学習させれば打ち消されるという前提で設計されていたものの、実際には部分的にしか消えていなかったというのが指摘の核心です。
さらに興味深いのは EMA の解釈です。従来は「過去の方針で集めたデータを使い回すため」に EMA が必要だと説明されてきました。しかし論文の実験では、EMA 方針でロールアウトを集めても古い方針のアンカーがなければ学習は崩壊します。つまり EMA が効いていたのは、更新で動きすぎたモデルを元の位置に引き戻す復元(restoration)の働きだったということです。
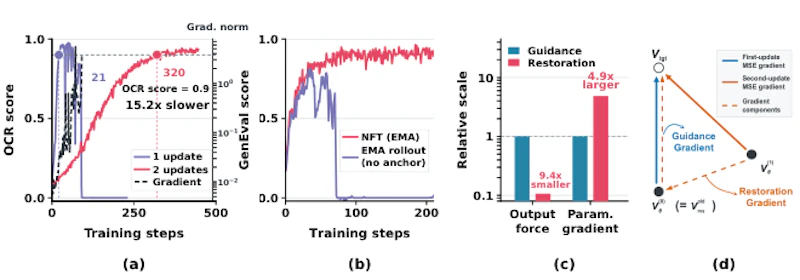
図3では、1 ロールアウトあたりの更新回数を 1 回から 2 回に増やすだけで学習速度が 15.2 倍遅くなる現象や、2 回目の更新における復元成分が誘導成分に比べて出力側の大きさは 9.4 分の 1 なのにパラメータ勾配のノルムは 4.9 倍大きいという非対称性が示されています。小さく見える復元成分が、実際には更新を支配していたわけです。
集約優先の報酬傾斜と二段更新
DiffusionART の提案は二本柱です。第一が集約優先の報酬傾斜で、同一プロンプトから得た K 個のロールアウトの報酬をまず一つの共有方向にまとめ、その方向をそのプロンプトに属する全ての状態へ与えます。サンプルごとに目標を作ってから平均を取るのではなく、先に集約してから目標を作るため、順逆一致力が設計上はじめから入り込みません。
第二が信頼領域マスク付きの二段更新です。ロールアウトのバッチを重複しない二つに分け、それぞれで 1 回ずつ更新します。2 回目の更新では、1 回目で生じたずれの分だけ復元方向を足し込むことで、EMA のスケジュール調整なしに同じ安定化効果を得ます。加えて、新旧の方針の乖離を KL 近似で測り、しきい値(固定値 10 のマイナス 5 乗)を超えた外向きの更新をマスクします。報酬モデルを微分できる必要はなく、プロンプトあたりのサンプル数が少なくても機能する点も実用上は大きいでしょう。報酬を際限なく追い込むと報酬ハッキングの懸念も出てきますが、信頼領域による制約はその抑制にも寄与すると考えられます。
勝敗のラベルしか得られない報酬モデル向けに、ペアごとの比較を共分散計算に差し替える DiffusionART-Pairwise も用意されています。
実験結果
動画生成では HunyuanVideo-13B を用い、視覚品質(VQ)と動き品質(MQ)、テキスト整合性(TA)を報酬として評価しています。
手法 | VQ | MQ | TA |
|---|---|---|---|
事前学習モデル | 5.195 | 1.943 | 1.118 |
Flow-GRPO-Fast | 3.149 | 1.874 | 1.667 |
DanceGRPO | 3.922 | 1.206 | 1.685 |
DiffusionNFT(EMA) | 6.827 | 2.683 | 2.096 |
DiffusionART | 8.970 | 4.224 | 2.111 |
最も強いベースラインに対して VQ で 31.4%、MQ で 57.4% の改善です。効率の面では、VQ と MQ を同じ重みで平均した指標で DiffusionNFT(EMA)の終盤水準に 12.02 倍、Flow-GRPO-Fast の水準に 11.72 倍少ない GPU 時間で到達し、最終 50 ステップの平均報酬はそれぞれ 28.8%、53.0% 高い値になりました。画像から動画を生成する Wan2.1-I2V-14B でも、MQ が 6 に達するまでの GPU 時間が 220.3 時間から 45.8 時間へと 4.8 倍削減されています。
画像生成では SD3.5-M で、Flow-GRPO が 500 ステップで到達する報酬に GenEval で 10.0 倍、OCR で 5.2 倍、PickScore で 9.6 倍少ないステップ数で届きました。FLUX.1-dev の GenEval 評価報酬は次の通りです。
手法 | GenEval 評価報酬 |
|---|---|
Flow-GRPO-Fast | 0.8374 |
DiffusionNFT(EMA) | 0.8490 |
Flow-DPPO | 0.9183 |
DiffusionART | 0.9684 |
ただし著者自身が注記しているとおり、FLUX 向けに DiffusionNFT のハイパーパラメータを再調整していないため、この比較はベースラインにやや不利な可能性があります。アブレーションでは、1 回更新のみの設定は OCR タスクで学習は速いが徐々に劣化し、二段更新にすると安定することが確認されました。信頼領域マスクを外すと動画学習では 200 ステップ付近で報酬が落ち込みます。
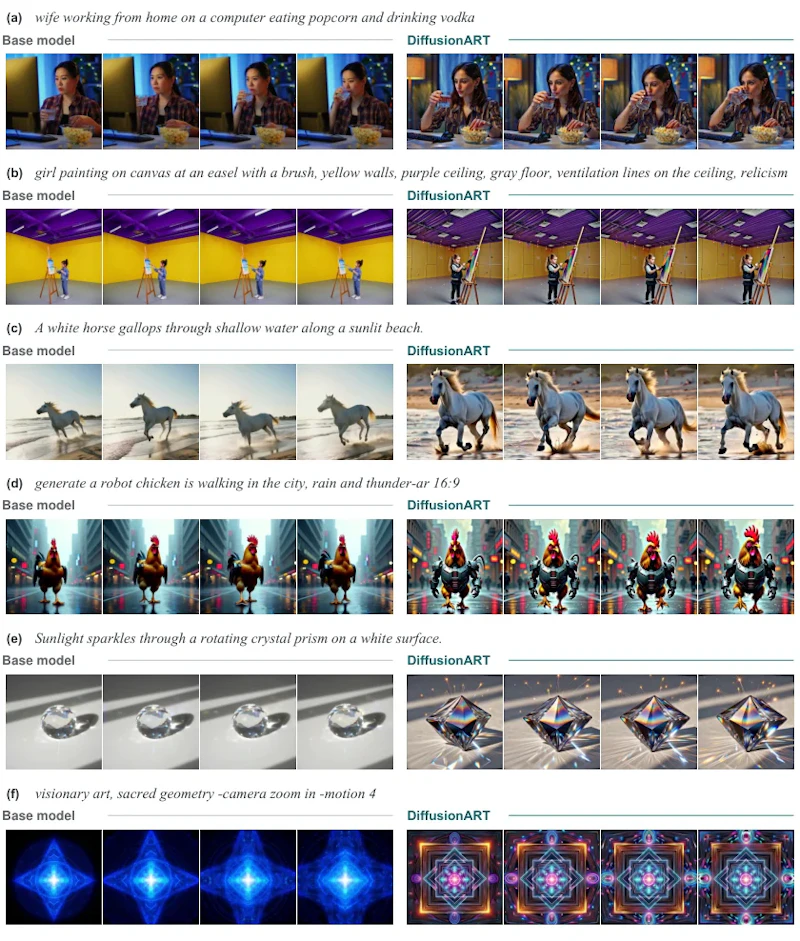
図15 のように、同じ条件で生成したフレームを時系列に並べると、被写体の形状の安定性や動きの一貫性に差が出ています。
まとめと課題
DiffusionART の価値は、手法の派手さよりも「なぜ既存手法が不安定だったのか」を分解して突き止めた点にあります。EMA を経験的なテクニックとして扱うのではなく、その効果の正体を復元と特定し、明示的な二段更新に置き換えたことで、タスクごとの調整という運用上の負担が減りました。画像・動画の両方で追加調整なしに動く点は、実務での採用しやすさにつながります。
一方で限界もあります。論文には独立した限界の節がなく、復元成分が勾配集約を経ても支配的である理由については今後の分析課題として残されています。信頼領域の判定は決定的な ODE ロールアウトに対する KL の近似であり、しきい値も固定値です。マスクの効果は画像より動画で顕著と記述されており、タスク特性による差は残ります。報酬モデルの質がそのまま結果を左右する構造自体も変わっていないため、報酬設計の良し悪しが引き続き成否を分けるはずです。
コードは GitHub で公開されており、拡散モデルの RL をこれから検証する研究者にとっては、EMA 調整という参入障壁が下がった意味も小さくないでしょう。言語モデル側の RL スケーリングと同様に、生成モデルの後追い学習も効率の勝負になってきています。
論文情報: "DiffusionART: Efficient, Stable and Scalable Reinforcement of Diffusion Models"(Zhenglin Wan et al., 2026) arXiv:2610.12572
本記事の図(図1、図3、図15)は解説のため上記論文より引用しています。


