AI-Papers
- DiffusionGemma 26Bは拡散モデルで256トークンを並列生成し、NVIDIA H100で毎秒1000トークン以上、RTX 5090で700トークン以上を達成
- MoE構造で全体26Bながら推論時のアクティブパラメータは3.8B、18GB VRAMの家庭用GPUでも動作可能
- Apache 2.0ライセンスで公開済み、Hugging Face・vLLM・MLXなど主要フレームワークへ即日対応
自己回帰の速度ボトルネック
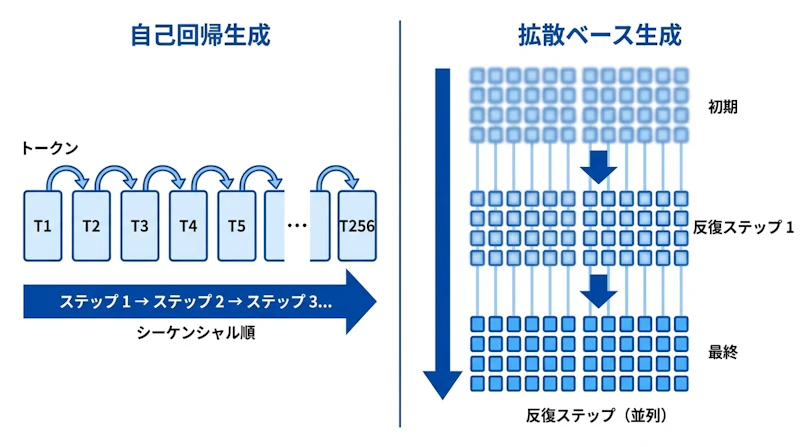
現在の主要な大規模言語モデル(Large Language Model、LLM)の大半は、「自己回帰(Autoregressive)」と呼ばれるアーキテクチャを採用しています。この方式では、回答を1トークン(単語や文字の断片)ずつ順番に生成します。前のトークンが確定するまで次の計算を始められないため、GPUの並列処理能力を十分に引き出せません。
チャットボットや文書生成ツールが普及するにつれ、この逐次生成の制約は無視できないボトルネックになってきました。特に長文の生成や、ユーザーが待ち時間を意識するリアルタイム対話では、速度と品質のトレードオフが開発者の課題でした。Googleが2026年6月10日に公開したDiffusionGemma 26Bは、拡散モデルという異なるアプローチでこの問題に取り組んでいます。
拡散で256トークンを同時生成
DiffusionGemma 26Bは、テキスト生成に拡散モデルの考え方を応用しています。生成はランダムなプレースホルダートークンで埋まった「白紙のキャンバス」から始まり、複数の反復ステップを経てトークンが少しずつ洗練されていきます。1トークンずつ左から右へ確定させる自己回帰モデルとは、根本から異なる仕組みです。
この仕組みの最大の利点は、256トークン分のブロックを一度に並列処理できる点にあります。さらに双方向アテンション機構を採用しており、生成中のすべてのトークンが互いを参照できます。この相互参照は、マークダウンを正しく閉じることやコードブロックの整合性を保つことなど、構造化された出力の品質向上にもつながっています。
アーキテクチャと実測性能
DiffusionGemma 26Bは、混合専門家(Mixture of Experts、MoE)構造を採用しています。MoEは入力に応じて一部の専門部分だけを動かす構造で、総パラメータ数は26Bでも、推論時にアクティブになるのはわずか3.8Bです。
これにより18GBのVRAMで動く軽さを実現しており、研究者や開発者が自前のハードウェアで試せます。構成としては、Gemma 4ファミリーの言語能力を土台に、新たな拡散ヘッドを組み合わせたものです。
公表されている仕様と実測値は次のとおりです。
項目 | DiffusionGemma 26B |
|---|---|
総パラメータ数 | 26B |
推論時のアクティブパラメータ | 3.8B |
必要VRAM | 18GB |
生成速度(NVIDIA H100) | 毎秒1000トークン以上 |
生成速度(GeForce RTX 5090) | 毎秒700トークン以上 |
同等クラスの標準的な自己回帰モデルと比べると、最大4倍の推論速度向上を達成しています。リアルタイム応答が求められるアプリケーションへの適性は大きく高まったといえます。
現時点での制限と適した用途
Googleの公式発表では、DiffusionGemmaの出力品質は標準的なGemma 4より低いと明示されています。最高品質の回答が求められる本番環境では、引き続き標準のGemma 4が推奨です。モデルを選ぶ際には、この点が判断材料になります。
一方、同時リクエストの少ないローカル推論環境には特に向いています。主なターゲットは、リアルタイム対話アプリケーションや、クラウドではなく端末上で動かすエッジAIへの応用です。ただし大量の処理を同時にこなすクラウド環境では、256トークンのブロック単位で生成する特性上、速度面の優位性は限られる点も考慮が必要です。
入手方法と対応環境
DiffusionGemma 26BはApache 2.0ライセンスで公開されており、Hugging Faceからモデルの重みをダウンロードして利用できます。利用手段は次のとおりです。
- Hugging Faceからの重みのダウンロード
- MLX、vLLM、Hugging Face Transformersといった主要な推論フレームワーク(統合済み)
- Google Cloud Agent PlatformとNVIDIA NIMからのクラウド提供(予定)
主要フレームワークへの統合がすでに済んでいるため、既存の開発環境にすぐ組み込めます。
拡散型テキスト生成は、これまで研究段階の話題として扱われることが多い領域でした。Googleが26Bスケールのモデルを実用レベルで公開したことで、テキスト生成アーキテクチャに新たな選択肢が加わっています。品質と速度のトレードオフを開発者がどう評価するかは、今後の利用事例から見えてくるはずです。