 AI-Papers
- DeepSeekが2026年10月17日に「DeepSeek-V4.1-Flash-1017」を公開し、モデルの重みを商用利用可能なMITライセンスで配布した
- コーディングエージェント評価のDeepSWE v1.1では推論設定「max」で成功率77%を示し、GPT-6 Astraなどを上回ると同社は説明している
- 料金は前バージョン据え置きで、オフピーク時の出力は100万トークンあたり0.6ドル。第三者による検証はまだ少ない
MITライセンスで重みを公開
中国のDeepSeekは2026年10月17日(現地時間)、「DeepSeek-V4.1-Flash」の新バージョンとなる「DeepSeek-V4.1-Flash-1017」を公開しました。モデルの重みはMITライセンスで配布されており、商用利用や改変が許諾されます。
提供形態はWeb版、アプリ、APIの3つで、重みはHugging Faceのモデルカードから入手できます。利用規約で用途が細かく制限されるオープンウェイトモデルも少なくないため、制約の緩いMITライセンスを選んだ点が、自社インフラ上で動かしたい開発者にとっての判断材料になります。
DeepSWE v1.1で成功率77%
同社が示した性能の中心は、コーディングエージェントの能力を測るDeepSWE v1.1での結果です。推論にリソースを多く割く設定「max」で成功率77%を記録したとされ、公開された比較図ではOpenAIのGPT-6 Astraを上回る位置に置かれています。
比較対象にはGPT-6 Astraのほか、OpenAIのGPT-6.1 Sol、AnthropicのClaude Opus 5、そして前バージョンのDeepSeek-V4.1-Flashが並びます。DeepSeekは一部の開発関連の評価において、これら海外のフロンティアモデルを上回ると主張しています。
ただし、この数値はいずれも同社自身が公表したものです。Hugging Face共同創設者のThomas Wolf氏はXで今回の性能向上を評価する一方、同社独自の環境以外でどう再現されるかに関心を示しました。報道時点で第三者機関による検証はまだ少なく、実際の開発現場での再現性は今後の検証待ちという状況です。
自己フィードバックで出力を短縮
改善の手法としてDeepSeekが挙げているのは、自己フィードバックを用いた強化学習です。モデル自身が生成結果を評価し、その信号を学習に反映させる仕組みによって、ゲーム制作や3Dモデリングのように開発プロジェクト全体を任されるタスクへの対応力を高めたと説明しています。
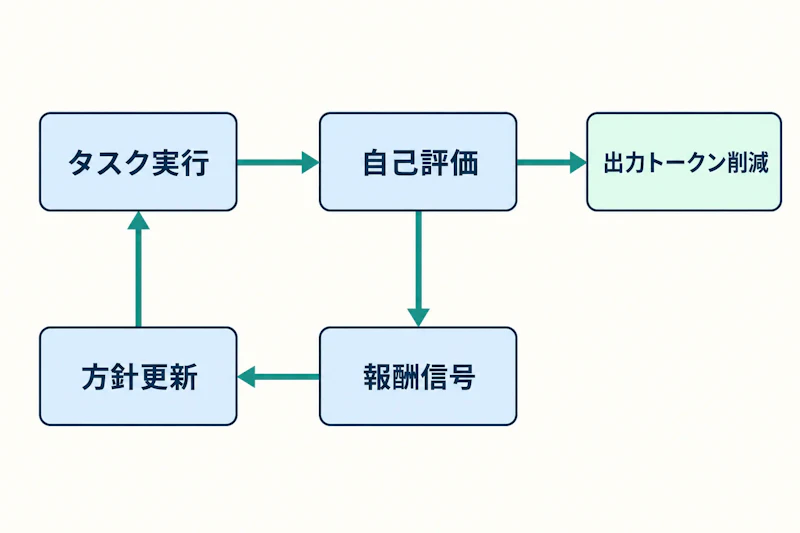
図1のように、生成と自己評価を繰り返す学習ループが、実行の無駄を削る方向に作用します。実際に前バージョンと比べて出力量とタスクの実行時間が減ったとされていますが、削減率などの具体的な数値は公表されていません。
コーディングエージェントでは、同じ成功率でも出力トークンが多いほど費用と待ち時間が膨らみます。成功率の向上と出力量の削減が同時に成り立つのであれば、ベンチマークのスコア以上に実運用での差として表れる部分です。
料金は前バージョン据え置き
性能向上にもかかわらず、API料金は前バージョンから変更されていません。オフピーク時の100万トークンあたりの単価は次のとおりで、ピーク時はいずれも2倍になります。
項目 | オフピーク時 | ピーク時 |
|---|---|---|
入力(キャッシュヒット) | 0.003ドル | 0.006ドル |
入力(キャッシュミス) | 0.15ドル | 0.3ドル |
出力 | 0.6ドル | 1.2ドル |
キャッシュヒット時の入力単価がキャッシュミス時の50分の1に設定されており、同じコードベースを繰り返し参照するエージェント用途では費用差が大きくなります。出力0.6ドルという水準は、主要な商用フロンティアモデルの出力単価と比べてかなり低い位置にあります。
乗り換え判断の材料になるか
開発ツール側でも、採用するモデルを入れ替える動きは珍しくなくなりました。Replitがデフォルトモデルを変更、AnthropicからOpenAIへ切替のように、性能と費用のバランスが変われば既定の選択肢も動きます。重みが自由に使えてAPI単価も据え置きのモデルが登場したことは、こうした比較検討の幅を広げます。
一方で、判断の根拠となる数値が提供元の発表に限られている点は変わりません。自社のコードベースと作業内容で試し、成功率だけでなく消費トークンと所要時間を含めて測ることが、採用を検討する際の現実的な手順になります。


