 AI-Papers
- MLPerf Inference v6.0 の公開結果では、8 GPU 構成の HGX B200 が DeepSeek R1 オフラインで 58,582 トークン/秒を記録し、HGX B300 は 69,319 トークン/秒まで伸びました
- GPU 選びは「VRAM 容量」「メモリ帯域」「低精度演算のネイティブ対応」の3つで決まり、モデルの重み容量が最初の分岐点になります
- クラウド単価から逆算すると B200 8基でおよそ 1 ドル/300万トークン規模になり、自前購入と比べる基準値として使えます
GPU選びで見る3つの数字
LLM(Large Language Model: 大規模言語モデル)を動かすための GPU を選ぶとき、カタログの TFLOPS だけを眺めても判断を誤りがちです。推論の速さを決めるのは、実際には次の3つの数字です。
- VRAM 容量: そのモデルが載るかどうかを決める。載らなければ速度は語れない
- メモリ帯域: トークンを1つずつ吐き出すデコード段階の上限を決める
- 低精度演算の対応: FP8 や FP4 をハードウェアでネイティブに扱えるか
この3つの優先順位は固定されています。まず載るか、次に帯域、最後に演算性能です。なぜこの順番になるのかは、推論処理が2つの異なる性格を持つ段階に分かれていることから説明できます。
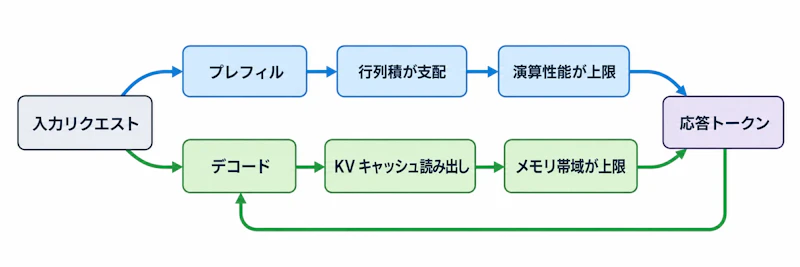
図1のように、プロンプトをまとめて読み込むプレフィル段階は大きな行列積が中心で、演算性能が効きます。一方、応答を1トークンずつ生成するデコード段階では、毎回モデルの重みと KV キャッシュをメモリから読み出す必要があり、ここはほぼ純粋にメモリ帯域で決まります。
チャットのように応答が長い用途ではデコードが支配的になるため、帯域の広い GPU が有利になります。逆にバッチ処理で大量の文書を要約するような用途ではプレフィルの比重が上がり、演算性能の差が表に出てきます。
MLPerf v6.0の実測結果
カタログ値ではなく実測で比べたいとき、参照できる一次データが MLPerf Inference v6.0 です。クラウド事業者の Nebius は 2026年4月に自社の提出結果を公開しており、16ベンチマークのうち10個で1位、合計21件を提出したと報告しています。
このラウンドの対象モデルは DeepSeek R1、Qwen3-VL 235B、gpt-oss 120B の3つです。Qwen3-VL 235B はマルチモーダルモデルとして今回新たに加わりました。シナリオは、レイテンシ制約下でリクエストを処理する Server と、スループット最大化を狙う Offline、そして応答性をより厳しく縛る Interactive に分かれます。
ベンチマーク | HGX B200(8基) | HGX B300(8基) | GB300 NVL72(8基) | GB300 NVL72(72基) |
|---|---|---|---|---|
DeepSeek R1 Server | 51,693 | 60,413 | 64,510 | 575,580 |
DeepSeek R1 Offline | 58,582 | 69,319 | 76,347 | 673,936 |
gpt-oss 120B Server | 87,444 | 100,437 | — | 1,096,770 |
gpt-oss 120B Offline | 85,921 | 106,885 | — | 1,046,150 |
単位はいずれもトークン/秒です。ここから読み取れることが3つあります。
第1に、同じ8基構成で B200 から B300 へ移ると、DeepSeek R1 Offline で 58,582 から 69,319 へ、およそ18%伸びています。gpt-oss 120B Offline では 85,921 から 106,885 で約24%の差でした。世代内のマイナーアップデートでも、メモリ容量と帯域の増強がそのまま効いている形です。
第2に、スケーリング効率が高い点です。GB300 NVL72 の DeepSeek R1 Offline は8基で 76,347、72基で 673,936 ですから、GPU あたりでは 9,543 から 9,360 へ微減にとどまります。18ノードにまたがる構成でも98%前後の効率を保っている計算になります。
第3に、レイテンシ制約の重さです。HGX B200 の gpt-oss 120B は Server で 87,444 トークン/秒ですが、より厳しい Interactive シナリオでは 13,155 トークン/秒まで落ちます。応答速度を優先すると、同じハードでもスループットは7分の1規模になるという事実は、サービス設計の段階で見積もりに織り込んでおく必要があります。
なお、この提出には H200 が含まれていません。H200 と Blackwell 世代を比べる場合は、以下のスペック値をもとに推定する前提になります。
主要GPUのスペック比較
項目 | H200 SXM | B200(DGX B200 換算) | RTX PRO 6000 Blackwell | RTX 5090 |
|---|---|---|---|---|
VRAM | 141 GB HBM3e | 約180 GB HBM3e | 96 GB GDDR7 | 32 GB GDDR7 |
メモリ帯域 | 4.8 TB/s | システム合計 64 TB/s(8基) | 1,792 GB/s | 512ビット GDDR7 |
低精度演算 | FP8 対応 | FP4 ネイティブ対応 | FP4 対応 | FP4 対応 |
公称 AI 性能 | FP8 3,958 TFLOPS(疎行列込み) | FP4 144 PFLOPS 疎 / 72 PFLOPS 密(8基合計) | FP4 4,000 TOPS(疎行列込み) | 3,352 AI TOPS |
消費電力 | 最大 700 W | システム最大 約14.3 kW | 最大 600 W | 575 W |
ECC | あり | あり | あり | なし |
GPU 間接続 | NVLink | NVLink 合計 14.4 TB/s | PCIe | PCIe |
表で最も目を引く差は帯域です。H200 の 4.8 TB/s に対して、GDDR7 搭載のコンシューマ系は 1.8 TB/s 級にとどまります。デコード速度はおおむね帯域に比例するため、同じモデルを1枚で動かせたとしても、トークン生成速度には2倍以上の開きが出ます。
一方で RTX 5090 は 32 GB という容量にもかかわらず 3,352 AI TOPS を持ち、演算性能だけなら H200 の FP8 性能に近い水準です。プレフィルが重い処理や、小さなモデルを大量に回す用途では十分に戦えます。
モデルサイズ別の選び方
実務では、まず「動かしたいモデルの重みが何 GB になるか」から逆算するのが確実です。目安として、パラメータ数に対して FP16 なら2倍、FP8 なら1倍、4bit 量子化なら0.5倍の GB 数が必要になります。これに KV キャッシュの分を上乗せします。詳しい計算式はLLMのVRAM必要量とは?計算式と推論・学習別のGPU選び方を解説で整理しています。
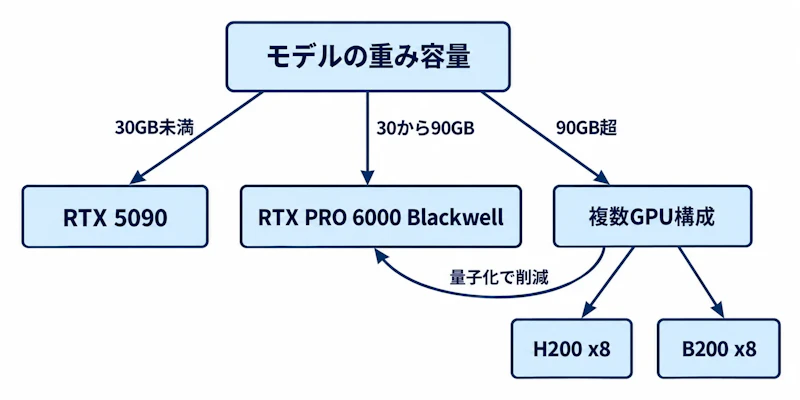
図2の分岐に沿って、具体的なモデルを当てはめてみます。
14B以下のモデル
FP8 で 14 GB 前後、4bit なら 7 GB 程度です。RTX 5090 の 32 GB には余裕を持って載り、残りを KV キャッシュに回せるため長文入力にも耐えます。個人開発や社内の検証環境としては、この帯が最もコスト効率が良い領域です。
32B前後のモデル
4bit で約 20 GB となり、RTX 5090 の1枚構成でぎりぎり実用になります。ただし FP8 で動かすと 32 GB をほぼ重みで使い切るため、KV キャッシュの余地がなくなります。この帯では量子化を前提に設計するか、96 GB の RTX PRO 6000 Blackwell に上げる判断が分かれ目です。
70Bから120Bクラス
gpt-oss 120B のような MoE(Mixture of Experts: 専門家混合)モデルは、FP4 量子化なら 60 GB 前後まで圧縮できます。RTX PRO 6000 Blackwell の 96 GB なら1枚に収まり、ECC も使えるため小規模な本番環境の候補になります。精度を落としたくない場合は H200 の 141 GB が選択肢です。
235B以上のモデル
Qwen3-VL 235B や DeepSeek R1 の規模になると、単体 GPU では成立しません。DeepSeek R1 は FP8 でも 700 GB 近い容量が必要で、H200 の8基構成(合計 1,128 GB)や B200 の8基構成(合計 1,440 GB)が前提になります。ここでは GPU 間の NVLink 帯域が性能を左右するため、PCIe 接続のコンシューマ GPU を並べても代替になりません。
FP4と量子化をどう使うか
Blackwell 世代の大きな変化は、FP4 をハードウェアでネイティブに扱えるようになった点です。従来の 4bit 量子化はソフトウェア側で重みを圧縮し、演算時に展開していたため、容量は減っても演算の恩恵は限定的でした。FP4 ネイティブ対応では、容量削減と演算スループット向上が同時に手に入ります。
ただし精度への影響は残ります。実務上の使い分けとしては、次のように考えると整理しやすいでしょう。
- FP16 / BF16: 学習とファインチューニング、精度検証の基準
- FP8: 本番推論の標準。精度低下はほとんど無視できる範囲
- FP4: 容量が足りないときの手段。タスクごとに精度を実測して判断する
H200 は FP8 までのネイティブ対応ですが、公称 3,958 TFLOPS という数値は依然として実用十分です。FP4 が必須になるのは、どうしても容量を半分にしたい場合に限られます。
クラウド単価で考える損得
購入か借用かを判断するには、トークン単価に換算するのが分かりやすい方法です。Nebius の公開価格では、オンデマンドで H100 が 4.50 ドル、H200 が 5.40 ドル、B200 が 8.50 ドル(いずれも GPU 1基あたり1時間)となっています。スポットインスタンスは H100 / H200 が 0.79 ドルから、B200 が 0.99 ドルからで、数カ月単位の予約では最大35%引きとされています。
この価格と MLPerf の実測値を組み合わせてみます。B200 を8基借りると1時間あたり 68 ドル、DeepSeek R1 Offline の 58,582 トークン/秒で回せば1時間で約2.1億トークンです。単価に直すと100万トークンあたり約0.32 ドルになります。
この数字は、商用 API の料金やオンプレミス導入の減価償却と直接比べられる基準値です。たとえば自社でサーバーを組む場合、本体価格と電力費を同じ単価に換算して下回るかどうかを見れば、投資判断の材料になります。B200 の8基システムは最大約14.3 kW を消費するため、電力と冷却の設備要件も見積もりに含める必要があります。
用途別の結論
ここまでの整理をまとめると、選択は用途によってほぼ決まります。
- 個人の学習と開発、14B 以下が中心: RTX 5090 で十分
- 社内ツールの常時稼働、70B から 120B 級: RTX PRO 6000 Blackwell の96 GB
- 精度優先の本番推論、多ユーザー同時利用: H200 の8基構成
- 最大規模モデルや低レイテンシ要件: B200 以降の Blackwell 世代
- 負荷が読めない立ち上げ期: クラウドのスポットで実測してから決める
MLPerf の結果が示すとおり、世代更新による伸びは1世代あたり2割前後が現実的な線です。手元の要件が現行世代で満たせるなら、次世代を待つ理由は薄くなります。むしろ、自分のワークロードがプレフィル寄りかデコード寄りかを実測し、帯域と演算性能のどちらに投資すべきかを見極めることが、カタログ比較よりも効果の大きい作業になります。


