 AI-Papers
- 50種の画像効果LoRAを単一モデルに統合し、ストレージを110GBから2.2GBへと98%削減
- PDSR・AOP・C2F-DOの3技術が連携してLoRA間の概念干渉と品質劣化を防止
- ユーザー盲検評価でConsistency 66.2%・Style Alignment 53.9%を達成し、個別LoRAと同等以上の品質を確認
研究の背景
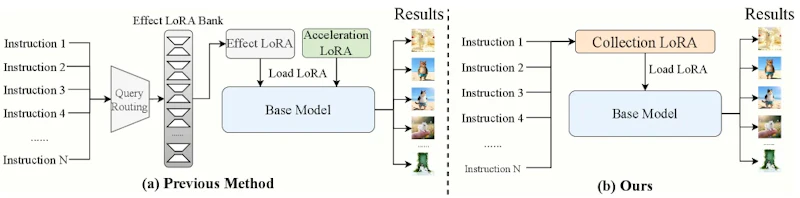
画像生成モデルの実運用では、水彩画風・アニメ調・ビンテージ写真といった多様な表現効果を適用するために、効果ごとに個別のLoRA(Low-Rank Adaptation、大規模モデルを少ないパラメータで効率よく微調整する手法)を用意するのが一般的です。しかし、この方式には運用上の課題があります。
効果が50種類に増えれば、1つあたり2.2GBのLoRAが50個、合計110GBものストレージが必要になります。さらに推論時には加速LoRAと効果LoRAを逐次的に組み合わせるため、遅延も生じます。
そして複数のLoRAを組み合わせると、パラメータが干渉し合い、テクスチャの劣化やスタイルの混在といった品質低下が起きやすいのが実情です。こうした実運用上の問題を解決するのが、本論文が提案するCollectionLoRAです。
3つの核心技術
CollectionLoRAは3つの技術を組み合わせて、多教師蒸留(複数の教師モデルの能力を1つのモデルへ移す学習)の難しさを克服します。
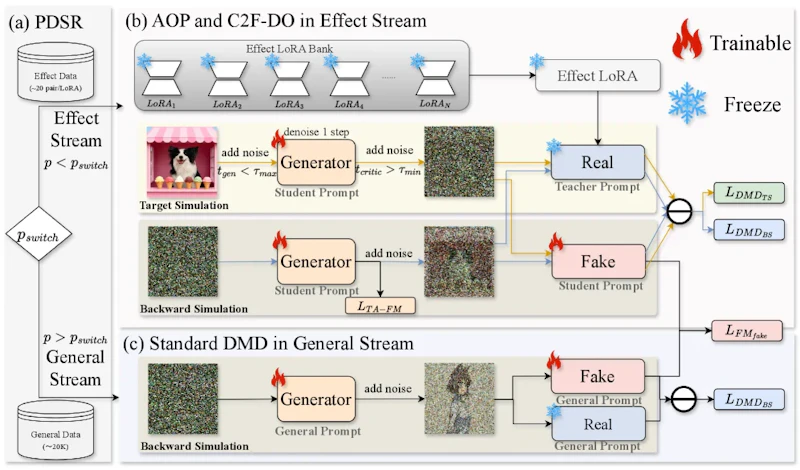
確率的デュアルストリームルーティング(PDSR)は、訓練バッチをエフェクトストリームと汎用ストリームに確率的に振り分ける機構です。エフェクトストリームでは教師LoRAから特定の画像効果を学習し、汎用ストリームでは一般的な画像生成データを使って基盤モデルの生成能力を維持します。この切り替えにより、特定効果の学習が既存の知識を壊してしまう「破滅的忘却」を防ぎます。
非対称直交プロンプト(AOP)は、教師モデルと学生モデルに異なるプロンプトを与える戦略です。教師には元の記述プロンプトを、学生にはVLM(視覚言語モデル)が生成した詳細な説明と効果固有のトリガーワードを組み合わせたプロンプトを与えます。こうしてモデル内部の潜在空間で各効果の概念を互いに干渉させず分離します。
粗から精への蒸留目標(C2F-DO)は3つの学習目標で構成されます。フローマッチングによる軌跡固定(TA-FM)で訓練初期の構造を安定させ、Target Simulationで高周波の細部テクスチャを復元し、Backward Simulationでグローバルなスタイル分布を整えます。
従来のBackward Simulationは、教師と学生の分布差が大きい場合に勾配が消失しやすい問題がありました。Target Simulationはこれを回避し、学生モデルに有効な勾配信号を与え続けます。
実験で示された性能
50種の効果LoRAを統合したCollectionLoRAを主要なベースラインと比較した定量評価の結果は、次の表のとおりです。
評価指標 | CollectionLoRA | ベースライン |
|---|---|---|
生成失敗率(Bad Case Rate) | 0.087 | 0.141〜0.217 |
VSA(Valid Subject Alignment) | 4.380 | 3.901〜4.150 |
生成失敗率はベースラインを大きく下回り、意味的一貫性を厳密に測るVSAスコアもベースラインをすべて上回りました。生成の失敗を抑えながら、元の意味も保てていることが分かります。
10名の専門評価者が50テストセットを盲検で評価したユーザースタディでは、視覚品質49.9%、一貫性66.2%、スタイル整合性53.9%の支持を獲得し、いずれもベースライン手法を上回りました。評価者からは「加速LoRAは速度の利点はあるが視覚品質が低下する」という指摘もあり、CollectionLoRAが品質と速度を両立していることが確認されました。
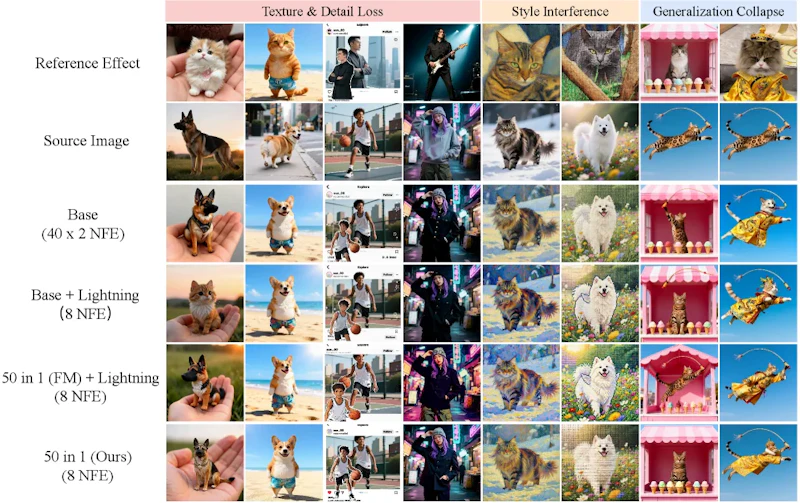
スケーラビリティの観点では、180種もの効果まで拡張しても品質が大幅に低下しないことも確認されています。MRTのように複数タスクを1モデルに統合するアプローチが画像生成分野で広がりを見せており、CollectionLoRAもその実用的な展開例といえます。
ゼロショット効果合成
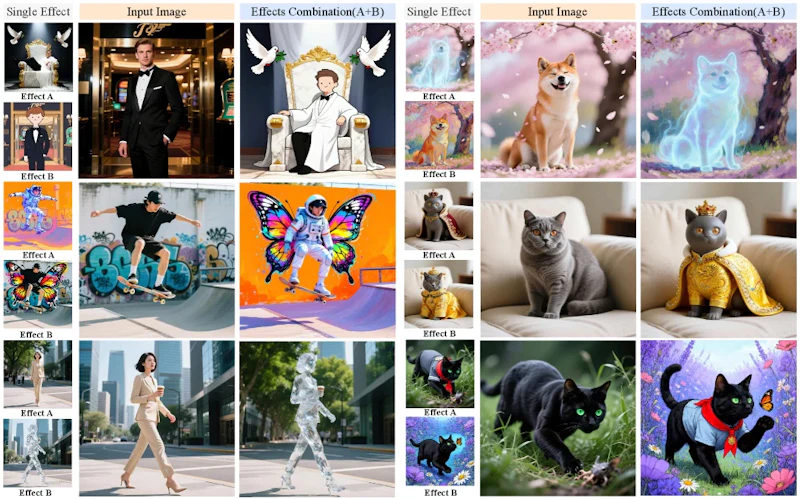
CollectionLoRAのもう1つの特徴が、個別に学習した2つの効果を追加訓練なしで同時適用できる「ゼロショット効果合成」です。「入力画像に効果Aを適用し、さらに効果Bを適用してください」というプロンプトだけで、2つの効果を組み合わせた結果を生成できます。
これは個別LoRAを外部で組み合わせる際に生じる干渉問題を避けつつ、より豊かな表現を柔軟に実現できる可能性を示しています。ただし、この挙動がどのような組み合わせで成立するか、またどこまでの合成数に対応できるかについては、さらなる検証が必要でしょう。
まとめと今後の展望
CollectionLoRAは、LoRAの管理コストと品質干渉という実運用上の問題に正面から取り組んだ研究です。ストレージを98%削減しながら各教師モデルと同等以上の品質を実現した点は、多様な画像効果を扱うサービス開発において実務的な価値があります。コードはGitHub(Qwen-Applications)で公開されており、再現しやすい環境が整っています。
一方で、効果の増加にともなう訓練コストの上昇や、意味的に近い効果同士の分離精度の限界については今後の検討課題です。将来的には、ユーザーが新しい効果を動的に追加・削除できる仕組みへの発展が期待されます。
論文情報: "CollectionLoRA: Collecting 50 Effects in 1 LoRA via Multi-Teacher On-Policy Distillation"(Fangtai Wu et al., 2026) arXiv:2605.25378
本記事の図(図2、図3、図6、図7)は解説のため上記論文より引用しています。


